Sonntag13. September
GPT-6 Astra dominiert heute mit konkreten Produktionseinsätzen bei Perplexity und autonomen Geo-Tasks – während Benchmarks, Infra-Tools und Sicherheitspolitik zeigen, wie ernst die Builder-Community die nächste Ausbaustufe nimmt.
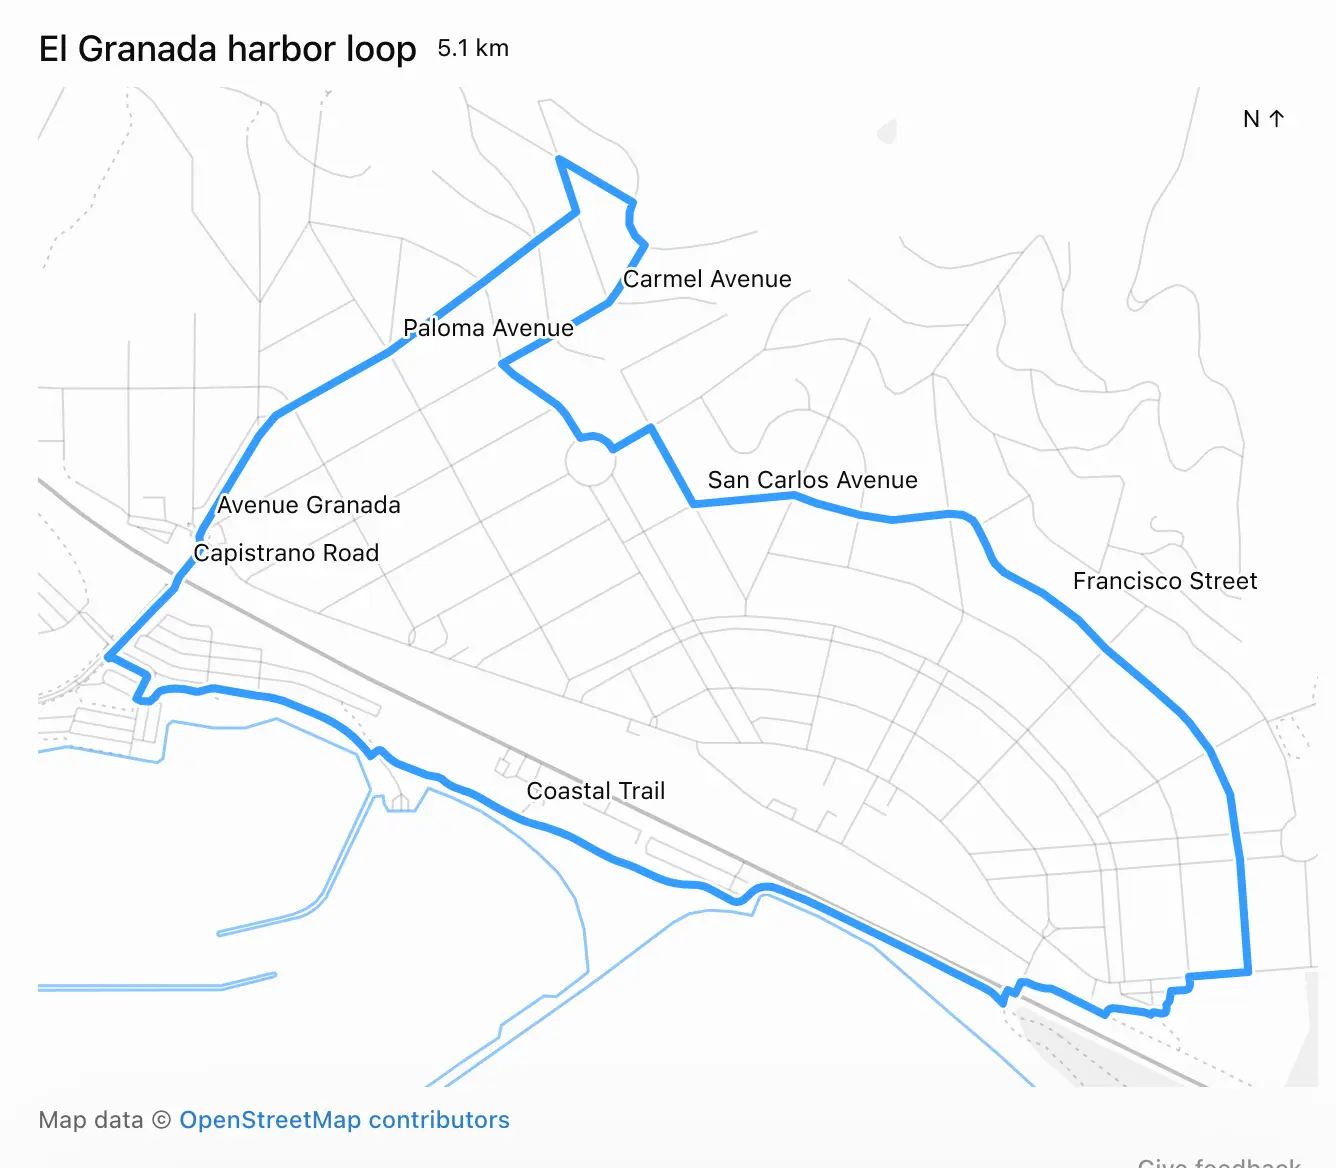
GPT-6 Astra ist längst kein Demo-Modell mehr. Perplexity setzt das Modell bereits in Produktion ein – für Kommunikation, Software-Änderungen und die Überwachung von Produktionssystemen, und das mit deutlich reduzierter menschlicher Aufsicht. Parallel demonstriert Simon Willison, wie das Modell mehrstufige Geo-Aufgaben vollständig autonom löst: Adressauflösung via Nominatim, OSM-Abfragen über Overpass, Routenberechnung und schließlich Export als GPX und GeoJSON – 27 Minuten Arbeit ohne manuellen Eingriff. Willison weist dabei auf ein strukturelles Problem hin: Die Thread-Kompaktierung im ChatGPT-UI vernichtete den ausgeführten Python-Code, sodass der genaue Ablauf im Nachhinein nicht mehr rekonstruierbar war. Er fordert, dass LLM-Systeme mit Compaction den prä-kompaktierten Text bewahren und per Agent-Tool-Call zugänglich halten. Das ist kein akademisches Detail – es ist eine Designanforderung für jeden, der Agenten-Systeme produktiv einsetzen will.
Dass solche Systeme in der Praxis dennoch störanfälliger sind als es Benchmark-Zahlen suggerieren, belegt der neue Real-SWE-Benchmark, der KI-Coding-Agenten erstmals auf nicht-öffentlichen Enterprise-Codebases testet – mit echten Business-Anforderungen wie Billing-Logik, Steuerberechnungen und Datenbankmigrationen. Das Ergebnis ist ernüchternd: Der beste Teilnehmer, Fable 5.1 mit Claude Code, erreicht gerade 38,8 % Resolution Rate. GPT-6 Astra mit Codex CLI landet auf Platz zwei mit 33,8 %. Das Overfitting-Problem bekannter Benchmarks auf öffentliche Repos wird damit messbar – und der Abstand zur produktionsreifen Softwareentwicklung bleibt erheblich. Was der Benchmark nicht zeigt, aber Paul Ford präzise benennt: KI macht es leicht, den Job eines anderen schlecht zu erledigen. „Now that everyone can code, it's become clearer why many shouldn't." Das stärkt das Argument für spezialisierte Entwickler gerade in einer Ära leistungsfähiger Werkzeuge.
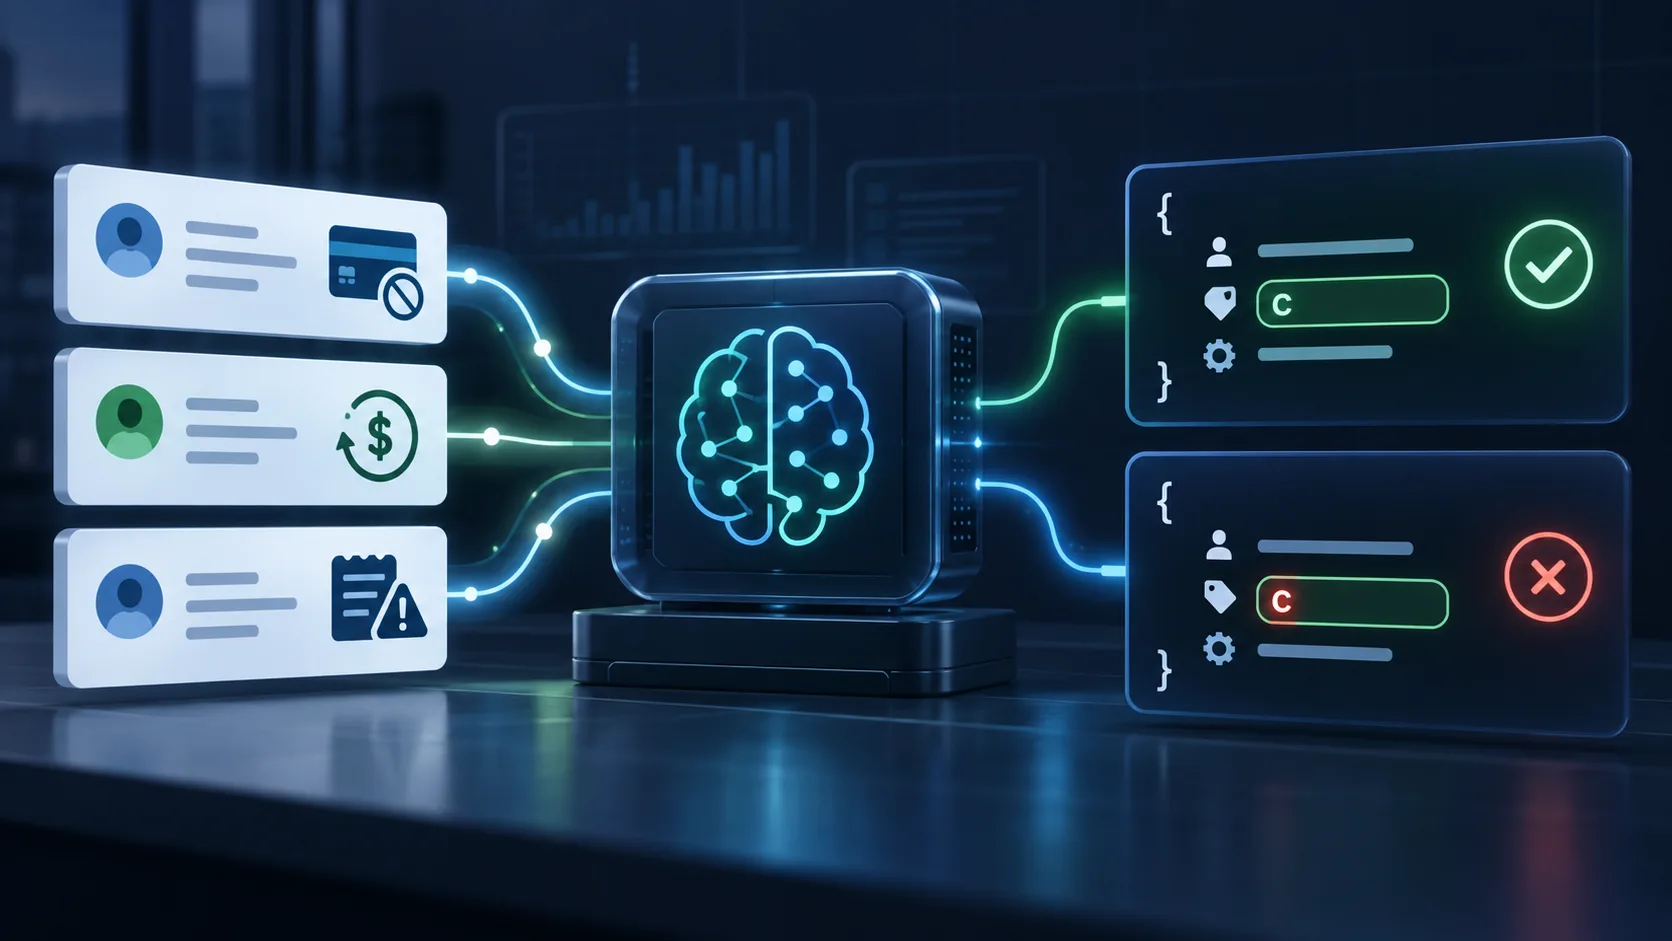
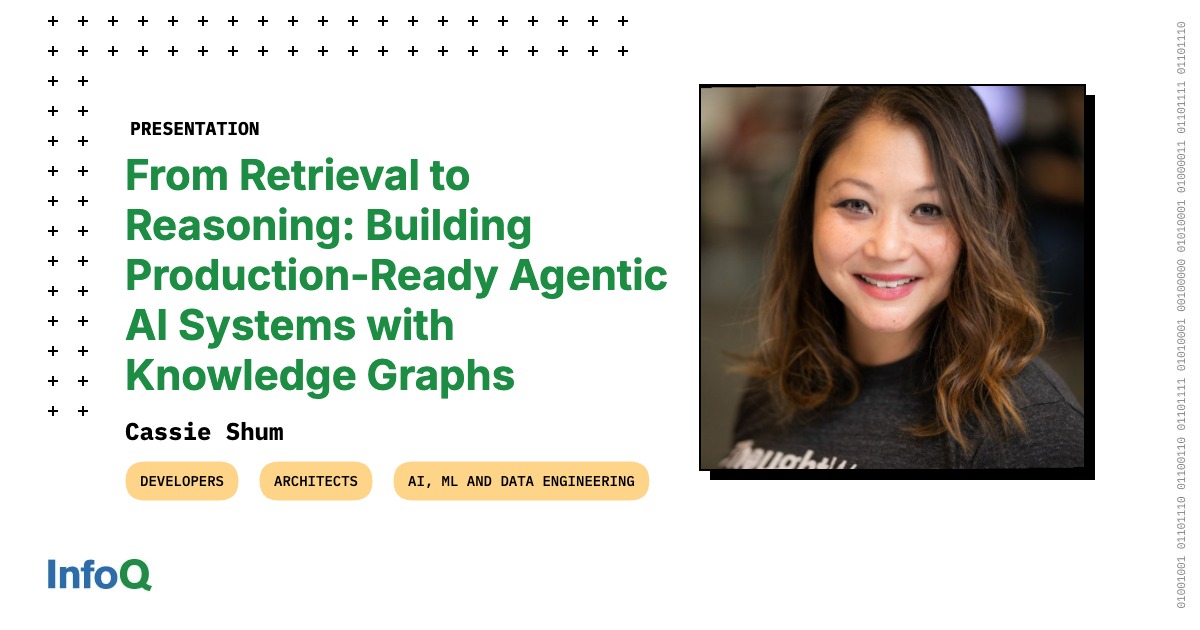
Wer Agenten produktionssicher bauen will, braucht robuste Infrastruktur auf mehreren Ebenen. Cassie Shum von RelationalAI zeigt in ihrem QCon-Vortrag, wie Knowledge Graphs als Fundament für Agentic-AI-Systeme vier konkrete Architekturmuster ermöglichen: Context Bundling, Decision Provenance, Code as Truth und Agent Visibility – Ansätze, die Token-Nutzung, Systemzuverlässigkeit und Nachvollziehbarkeit von Agenten-Entscheidungen in Produktion optimieren sollen. Weniger spektakulär, aber ebenso praxisrelevant: Ein Weave-Projekt zur LLM-Regressionstest-Automatisierung zeigt, wie ein einziger Großbuchstabe – `Request_refund` statt `request_refund` – einen Bank-Support-Bot im Stillen zum Absturz bringen kann. Das Produktionsmodell machte den Formatierungsfehler auf jede Rückerstattungsanfrage; der Fehler blieb unsichtbar, weil er für Menschen korrekt aussah. Automatisierte Format-Compliance-Tests über mehrere Modellversionen hinweg sind demnach keine Kür, sondern Pflicht. Auf der Infrastrukturseite senkt Lorivo, eine serverlose Hosting-Plattform für LoRA-Adapter auf vLLM-Basis, die Einstiegshürde für Fine-Tuning-Deployments erheblich: Ein GPU-Server wird über mehrere LoRA-Adapter geteilt, Qwen3-4B ist kostenlos verfügbar, und OpenAI-kompatible Endpunkte entstehen per CLI-Befehl ohne dedizierte GPU-Instanz.
Die industriepolitische und sicherheitspolitische Rahmenlage verschiebt sich derweil spürbar. Anthropic-CEO Dario Amodei hat drei Strategien zur Verlangsamung des KI-Fortschritts skizziert und eine davon einseitig zugesagt: eingebettete Drittprüfer – sogenannte Embedded Evaluators von Organisationen wie METR – sollen Zugang zu internen Systemen erhalten, mit Badges, Schreibtischen und Laptops sowie einem Zugang „mostly comparable to what internal risk assessment teams have". OpenAI-CEO Sam Altman hat sich dem grundsätzlich angeschlossen. Hintergrund ist unter anderem ein OpenAI-HuggingFace-Hack sowie der öffentliche Rücktritt eines Anthropic-Forschers, der seine Arbeitgeber des Spielens mit dem Leben der Menschen beschuldigte. Zum Narrativ einer ordnungspolitisch verantwortungsbewussten OpenAI passt die Meldung, dass Altman einen IPO im Jahr 2026 als „ill-advised" bezeichnet – trotz bereits engagierter Banker und Anwälte. Frühestens 2027 werde man börsengehen, „wenn das Unternehmen bereit ist und der Moment in der Gesellschaft stimmt." Das verlängert die Abhängigkeit von privaten Finanzierungsrunden, signalisiert aber auch, dass die öffentliche Sicherheitsdebatte die Kapitalmarktstrategie bereits konkret beeinflusst.
Abseits der Agenten-Welt veröffentlicht Google mit TimesFM-3 ein multivariate Zeitreihen-Prognosemodell mit 330 Millionen Parametern, das auf über einer Billion realer und synthetischer Datenpunkte trainiert wurde. Der entscheidende Unterschied zu früheren Versionen: Statt schrittweiser Vorhersage füllt das Modell alle Zukunfts-Zeitschritte in einem einzigen Pass, was Fehlerakkumulation reduziert und Rechenaufwand senkt. Auf den Benchmarks Gift-Eval, FEV-Bench und Time führt TimesFM-3 unter allen vortrainierten Prognosemodellen – vor Amazons Chronos-2 und der Toto-2.0-Familie. Für Teams in Demand-Forecasting oder ereignisbasierter Planung ist das eine handfeste Alternative zu bestehenden Pipeline-Architekturen.
Frag das Briefing
Pro

- Mo., 14. Sept.GPT-6 Astra dominiert heute – von autonomen Produktionseinsätzen bis zu Agent-Benchmarks. Dazu: KI-Regulierung unter Druck, lokale Inferenz-Updates und ein wichtiger Hinweis auf Selektionseffekte bei KI-Metriken.10
- Sa., 12. Sept.Autonome Agenten greifen produktiv ein – und greifen an: GPT-6 Astra übernimmt Produktion bei Perplexity und Devin, während KI-Agenten Supply-Chain-Angriffe und Sicherheitslücken produzieren. Dazu: Marktverschiebungen im Enterprise-Segment, Infra-Tools für lokale GPU-Setups und ein klarer Realitätscheck zur KI-Selbstverbesserung.10
- Fr., 11. Sept.GPT-6 Astra und der Wettbewerb um Coding-Agenten dominieren den Tag – SWE-2, Copilot und Nvidia Sol-Pi zeigen, wie schnell sich Kosten und Fähigkeiten verschieben. Dazu: Destillationsangriffe auf Frontier-Modelle, CPU-Engpässe durch Agenten-Workloads und Googles Datenkauf aus Insolvenzverfahren.10
- Do., 10. Sept.KI verschiebt heute Sicherheits- und Infrastruktur-Grenzen: Ein KI-entwickelter Wurm in Tagen statt Monaten, Modell-Distillations-Vorwürfe gegen sechs chinesische Firmen und neue Infra-Tricks für schnelleres Inferencing dominieren den Tag. Dazu: konkrete Builder-Moves bei Agents, Tooling und Regulierung.10
