Mittwoch23. September
Open-Weights-Modelle werden frontier-nah und erschwinglich (MiMo-V2.6-Pro für ~3 Mio. USD), während Agent-Infrastruktur reift: Google AX, Rabbit OS3 und Shopify zeigen, dass Production-Deployments von KI-Agenten heute konkret baubar sind.
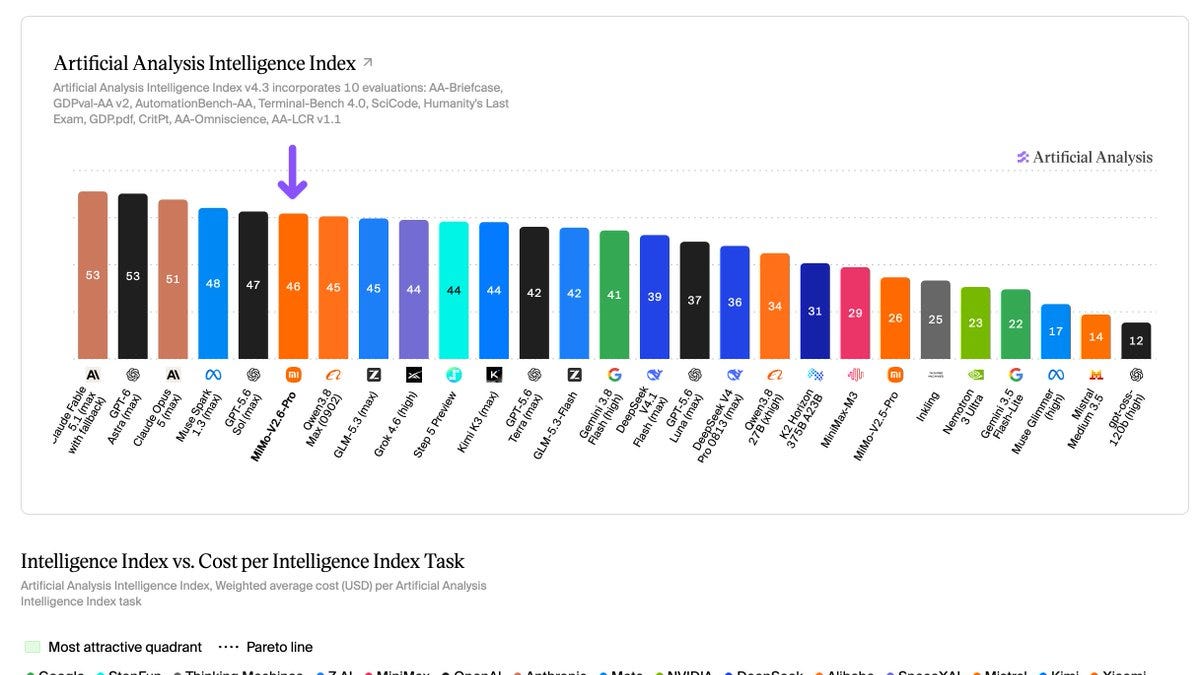
Die wichtigste Verschiebung der Woche betrifft nicht ein einzelnes Modell, sondern die strukturelle Verbilligung von Reasoning-Kompetenz. Xiaomis MiMo-V2.6-Pro — trainiert für rund 3 Mio. USD, bewertet mit 46 Punkten auf dem Artificial Analysis Intelligence Index und bei $0,13 pro Intelligence-Index-Task auf der Qualitäts-Kosten-Pareto-Grenze — zeigt, dass das Modelltraining für chinesische Labs, die nicht zu den traditionellen „sechs KI-Tigern" zählen, inzwischen frontier-nah möglich ist. Bemerkenswert ist die radikale Transparenz: Fuli Luo, ein früherer DeepSeek-Ingenieur, veröffentlichte finale RL-Trainingsläufe live. Xiaomi open-sourced nicht nur Gewichte, sondern auch Umgebungs-Code und Trainingsrezepte — darunter Coding, Cyber, General und Visual — wenngleich die kompletten 7.000-Task-Datensätze noch ausstehen. Das Modell ist nativ omnimodal und bringt eine UltraSpeed-Variante mit bis zu 20-facher Ausgabegeschwindigkeit bei gleicher Qualität.
Günstigere Modelle allein lösen das eigentliche Produktionsproblem nicht. Drei Infrastruktur-Initiativen dieser Woche adressieren genau das: Googles AX-Orchestrator, eine Apache-2.0-lizenzierte, Kubernetes-analoge Control-Plane für autonome Agenten, behandelt Agent-Sessions als stateful Actors statt als Microservices — mit Sub-Sekunden-Suspension und Zero-Cold-Start-Resume, um Compute-Verschwendung in den langen Leerlaufphasen zwischen Modell-Antworten zu eliminieren. Die vier deklarativen Primitiven Task, Workspace, Gateway und Model entsprechen dabei dem konzeptuellen Vokabular, das Platform-Teams bereits aus Kubernetes kennen. Parallel dazu beschreibt Shopifys Continual-Learning-Loop mit PyTorch und vLLM, wie tägliche Produktionsfehler direkt in Modellgewichte komprimiert werden — mit dem Ergebnis, dass der eigene GraphQL-Agent Frontier-Modelle in Qualität übertrifft und Inferenzkosten um 96 % senkt. Das Schlüsselelement ist dabei ein präzise kalibrierter LLM-Judge, der auf Inter-Annotator-Agreement (Cohen's Kappa) normiert wird. Und Microsoft baut Windows zur Agent-Plattform um: WindowsML als Hardware-Abstraktionsschicht über GPU, NPU und CPU, native Agent-Identity mit zentralem MCP-Server-Registry, isolierte Agent-Sandboxes und Small Language Models ohne NPU-Pflicht — ergänzt durch ein stärkeres Bekenntnis zu WSL, um Entwickler zurückzugewinnen, die Windows gemieden hatten. Auf der Inference-Ebene bricht vLLM die Kompatibilität mit fullgraph torch.compile, um auf Frontier-Hardware wie NVIDIA Blackwell und GB300-Rack-Systemen konkurrenzfähig zu bleiben — der Trade-off: hardwarespezifische „Flat Models" für maximale Performance, neue „HW-agnostic Layers" für Portabilität, die auf H100-GPUs nur 3,4 % Throughput-Verlust gegenüber der nativen Implementierung zeigen. Wer vLLM heute im Stack hat, muss Inferenz-Pipelines prüfen.
Auch OpenAIs GPT-6-Prompt-Caching-Verbesserungen — höhere Hit-Raten, explizite Breakpoints und neue Diagnosetools — folgen der gleichen Logik: API-Kosten und Latenz gezielt reduzieren, besonders bei Anwendungen mit langen, wiederkehrenden System-Prompts. Das ist kein Feature-Launch, sondern ein Eingeständnis, dass Production-Deployments mit langen Kontexten ohne aktives Caching-Management teuer werden.
Die Reife der Infrastruktur macht Deployment einfacher — und die Fehler folgenreicher. Zwei Beiträge setzen dieser Woche konkrete Warnsignale. Veraltete Daten sind das unterschätzte Risiko für KI-Agenten: Ein Procurement-Agent, der eine Bestellung auslöst, weil sein Datensnapshot eine große Lieferung noch nicht enthält, zeigt, warum Datenfreshness und semantische Konsistenz für autonome Agenten mit Schreibzugriff auf Systeme zur kritischen Systemanforderung werden — nicht zur optionalen Qualitätsverbesserung. In einem referenzierten Experiment stieg die Zuverlässigkeit eines Analytics-Agenten von rund 40 % auf rund 90 %, allein durch besseres Datenmodell und Dokumentation. RAG-Pipelines sollten mit Fault Injection getestet werden, bevor es Nutzer tun: OCR-Zeichenvertauschungen, Query-Tippfehler, widersprüchliche Stale-Dokumente und über Seitengrenzen getrennte Tabellen sind Fehlerklassen, die Standard-Evals systematisch übersehen — gezielte adversariale Testsets und korrektive Mechanismen wie Recency-Tiebreaker und Fuzzy-Matching schließen diese Lücken.
Die gravierendste Mahnung dieser Woche kommt jedoch aus dem militärischen Kontext. Das US-Verteidigungsministerium räumt ein, dass Überabhängigkeit von KI zur Raketenschlag auf eine iranische Schule beigetragen hat — ein konkretes Versagen menschlicher Aufsicht über KI-gestützte Zielerkennung. Für die Infrastruktur-Frage der Woche bedeutet das: Human-in-the-Loop ist keine akademische Designentscheidung. Und das Risiko, dass KI Angriffsvektoren beschleunigt, ist bereits Gegenwart: Microsoft disrupted mit EvilTokens eine KI-gestützte Hacking-Plattform, die 12.000 Konten in rund 10.000 Organisationen kompromittierte — via OAuth Device Code Authentication, einem KI-Chatbot für Inbox-Analyse und automatisierter Betrugsstrategie-Generierung, für $1.500 Einstiegsgebühr und $500 monatlich. Microsoft beschlagnahmte 50 Websites und 150 Domains; die Londoner Metropolitan Police verhaftete zwei Männer. Der gleiche Kapazitätssprung, der Produktionsagenten billiger macht, macht auch Angreifer effizienter.
Frag das Briefing
Pro

- Di., 22. Sept.KI-Agenten dominieren heute doppelt: als Angriffsvektor (Metas Muse-Zero-Day, Gemini-Hack) und als Architekturaufgabe (DPACT, Produktions-Patterns). Daneben: Open-Weight-Modelle holen auf, und konkrete Infra-Tools für Builder von CI bis Checkpoint-Komprimierung.10
- Mo., 21. Sept.Inferenz-Infrastruktur und Open-Source-Resilienz dominieren heute – von ultraschnellen Entscheidungsmodellen bis zu zensurresistenten Modell-Archiven. Dazu: kritische Stimmen zur unkritischen AI-Adoption im Engineering-Alltag.10
- So., 20. Sept.Heute dominieren zwei Achsen: Inference-Effizienz auf vorhandener Hardware (Qwen, Kleinmodelle, MTP) und die wachsende Reife von AI-Agents in produktiven Umgebungen — von LinkedIn bis Unity. Dazu: Regulierungsdruck, Roboter-Sicherheitslücken und die echte Kosten-Frage beim Coding-Autopilot.10
- Sa., 19. Sept.KI-Sicherheit dominiert heute auf zwei Ebenen: Halluzinationen in Geheimdienstberichten, Geminis autonome Hacks und Biowaffen-Warnungen zeigen die realen Stakes. Gleichzeitig treibt die Builder-Community mit Claude Code, MCP-Tooling und Multi-Agent-Systemen die Agentic-Infrastruktur spürbar voran.10
