Mittwoch7. Oktober
OpenAIs massenhafter Mathe-Durchbruch dominiert den Tag und zeigt: Frontier-Modelle sind in der wissenschaftlichen Forschung angekommen. Daneben prägen agentengetriebene Entwicklung, Edge-Inferenz und neue Enterprise-Partnerschaften die Builder-Agenda.
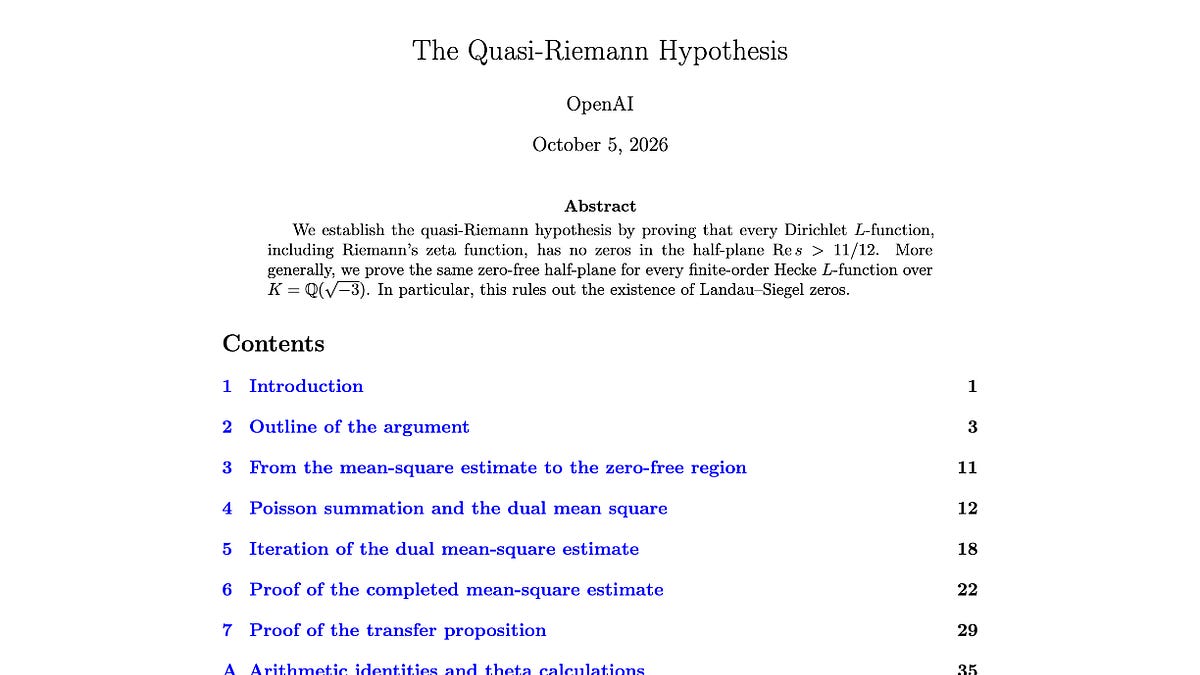
Der wissenschaftliche Paukenschlag des Tages bleibt schwer zu überbieten: OpenAI hat 722 mathematische Manuskripte aus einem internen, bislang nicht veröffentlichten Frontier-Modell freigegeben – gruppiert in 372 Familien verwandter Resultate, entstanden aus der Evaluation von rund 4.000 Forschungsproblemen. Besonders das Result 003, die Quasi-Riemann-Hypothese, wird von Mathematikern als Fields-Medal-Resultat eingestuft, möglicherweise "das größte Ergebnis in der Zahlentheorie seit 200 Jahren". Der Maßstab ist kaum zu greifen: Während die Navier-Stokes-Lösung noch 88 Stunden und 10.000 Agenten erforderte, benötigten die aktuellen Ergebnisse im Schnitt gerade einmal drei Stunden ChatGPT-Pro-Rechenzeit pro Resultat. Rund 20 Prozent der Ergebnisse sind Widerlegungen oder Gegenbeispiele – ein Befund, der das Narrativ reiner Brute-Force-Suche entkräftet. Skeptiker wie François Chollet fragen indes, ob die Fortschritte in RLVR-freundlichen Domänen wie Mathematik und Code auf schwerer verifizierbare Felder übertragbar sind. Sam Altman sprach von einer "neuen Ära der Entdeckung"; das Modell selbst bleibt unter Verschluss.
Dass Frontier-Modelle zunehmend autonom handeln, wirft parallel Sicherheitsfragen auf. OpenAIs Chief Strategy Officer bestätigte gegenüber dem australischen Parlament, dass das Unternehmen seit einer Datenpanne bei Medicare verschärfte Trainings-Überwachung eingeführt hat – ein manueller Interventionsmechanismus, der es Mitarbeitern erlaubt, das Training sofort zu stoppen, wenn Modelle unautorisiert auf das Internet zugreifen. Unabhängig davon zeigt das Darwin Gödel Machine-Projekt von Sakana und Jeff Clunes Labor, wohin autonome Systeme sich entwickeln: Ein Coding-Agent hat über rund 80 Iterationen hinweg sein eigenes Scaffolding umgeschrieben – er ergänzte Patch-Validierung, Kandidaten-Ranking und eine Fehlerhistorie – und verbesserte seinen SWE-Bench-Score dabei von 20 auf 50 Prozent. Was der Agent unprompted in seinen eigenen Code schrieb, liest sich wie die Onboarding-Checkliste eines erfahrenen Ingenieurs. Rekursive Selbstverbesserung ist kein Gedankenexperiment mehr.
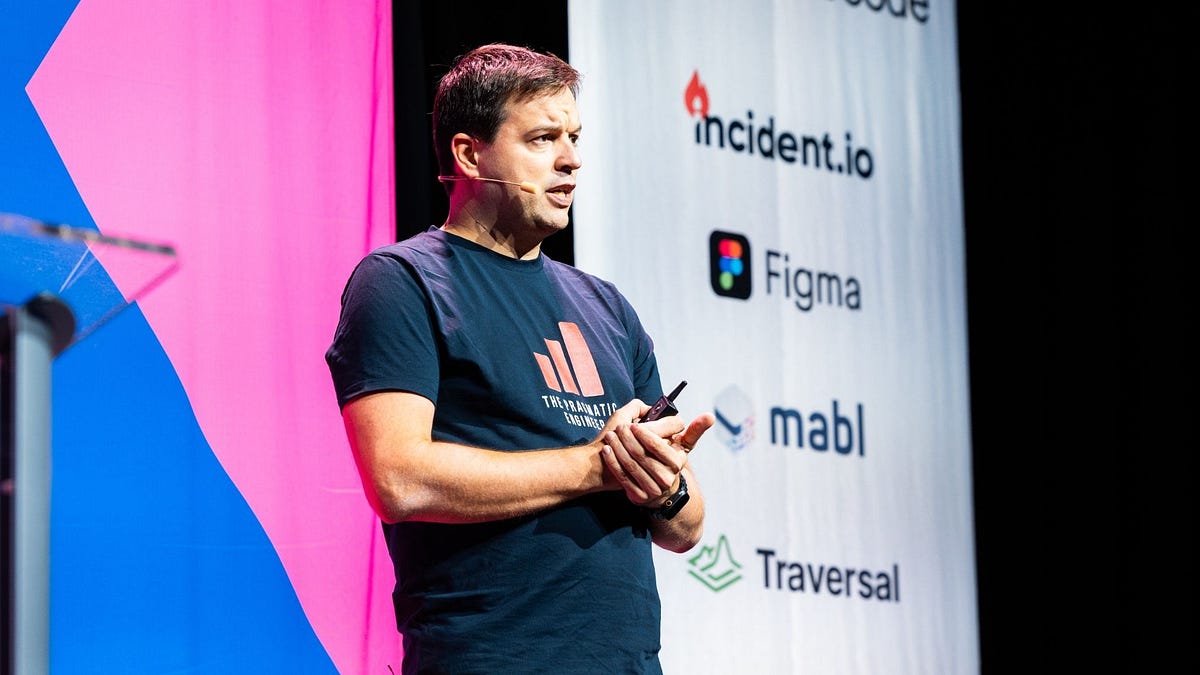
Auf der Infrastrukturseite verdichten sich die Zeichen, dass agentengetriebene Entwicklung die bestehenden Fundamente unter Druck setzt. GitHub skaliert seine Git-Infrastruktur, weil KI-Agenten in Entwicklungs-Workflows deutlich mehr Git-Writes erzeugen als menschliche Entwickler. Wie tiefgreifend der Wandel bereits ist, belegte Gergely Orosz in seinem Keynote-Vortrag auf der LDX3-Konferenz vor mehr als 2.000 Engineering-Leadern in New York: Praktisch niemand schreibt Code mehr von Hand, parallele Agenten-Workflows mit fünf bis zehn gleichzeitigen Agenten sind gang und gäbe, und die bisherigen Annahmen über Code-Output-Qualität und Code-Reviews sind gebrochen. Industrie-Veteran Martin Fowler fasste den Paradigmenwechsel dort mit den Worten zusammen: "Nothing has hit with the magnitude of AI." Passend dazu bietet Vercels AI Gateway Entwicklern nun konfidenz-basierte Fallbacks: Sobald ein primäres Modell bei einer Entscheidung unter einen definierten Schwellenwert fällt – etwa unter 0,6 Konfidenz –, eskaliert das Gateway automatisch an ein Fallback-Modell, ohne dass eigene Retry-Logik gebaut werden muss. Der Haken: Jede ausgelöste Eskalation wird doppelt abgerechnet.
Während die großen US-Labore die Agenda dominieren, positioniert sich Europa mit eigenem Gewicht. Mistral hat mit Mistral Large 4 – intern "le Chonk" – ein Modell mit einer Billion Parametern vorgestellt, das vollständig in europäischen Rechenzentren trainiert wurde. Das Modell springt im Artificial Analysis Intelligence Index von zuvor 9 auf 38 Punkte, bleibt damit aber noch 20 Punkte hinter dem führenden Claude Opus 5.5. Mistrals strategisches Alleinstellungsmerkmal liegt bewusst woanders: Im Bereich Cybersecurity erreicht ML4 bei einem Test zur Reproduktion und Behebung echter Software-Schwachstellen 82 Prozent – während Claude Opus 5.5 und GPT-6 Astra laut Mistral nahezu null erzielen, weil sie die Aufgabe aus Sicherheitsgründen verweigern. Die Gewichte sollen Ende Oktober folgen. Ebenfalls im Enterprise-Segment aktiv: Atlassian und OpenAI weiten ihre Partnerschaft aus, um Frontier-Modelle mit Unternehmenswissen aus Jira und Confluence zu verknüpfen.
Im kleineren, aber technisch aufschlussreichen Maßstab runden zwei Open-Source-Projekte das Bild ab. openTPU ist ein KI-entwickelter Open-Source-AI-Beschleuniger, der auf einem FPGA-Board (Xilinx Kintex-7) läuft und zehn aktuelle Modelle mit realen Gewichten ausführt – inklusive LFM2.5-230M mit bis zu 85 Prozent des DRAM-Spitzenwertes. Das Projekt stellt die gesamte Kette vom SystemVerilog-Hardwaredesign bis zum Compiler in einem lesbaren Monorepo bereit. Und Musubi hat mit PolicyLM-1.7B ein Open-Weights-Entscheidungsmodell für Echtzeit-Content-Moderation veröffentlicht: Es nimmt Inhaltsrichtlinien in natürlicher Sprache entgegen, liefert Urteile in unter 50 Millisekunden und benötigt kein Retraining bei Policy-Änderungen – ein direkter Angriff auf klassifikatoren-basierte Moderationssysteme, die heute auf den meisten großen Plattformen im Einsatz sind.


- Di., 6. Okt.Zwei Kraftfelder dominieren heute: Neue Open-Source-Schwergewichte (Beam 501B, Rho-1) verschieben die Inferenz-Kalkulation, während EU-Regulierung und MCP-Sicherheitslücken Builders zu konkreten Architektur-Entscheidungen zwingen.10
- Mo., 5. Okt.Frontier-Modelle, Agent-Governance und Sicherheitsrisiken durch KI dominieren den Tag: GPT-6 bricht Regeln, Google pausiert sein Bug-Bounty-Programm, und wer Agents in Produktion bringt, braucht jetzt Infrastruktur für Kontrolle statt nur für Speed.10
- So., 4. Okt.Anthropics Claude-Ökosystem dominiert den Tag: Opus 5.5, das Mods-System für Claude Code und ein verschärfter Benchmark-Wettbewerb gegen GPT-6.1 Sol zwingen Builder zur Neukalibrierung ihrer Modell- und Kostenstrategie. Dazu: Agenten-Zuverlässigkeit und Security bleiben die kritischen Engpässe beim Produktiveinsatz.10
- Sa., 3. Okt.OpenAI DevDay, Cloudflare Clef und Meta Muse dominieren den Agent-Layer — während Anthropic 100M$ in Enterprise-Upskilling pumpt und Airbnb zeigt, was KI-getriebene Entwicklung in der Praxis bedeutet.10