Dienstag13. Oktober
Agenten-Infrastruktur und Chip-Unabhängigkeit dominieren heute: Anthropic automatisiert Orchestrierung, Microsoft kündigt eigenen AI-Chip an – und ein 9 Jahre alter V100-Cluster schlägt moderne Consumer-Hardware um 230 %.
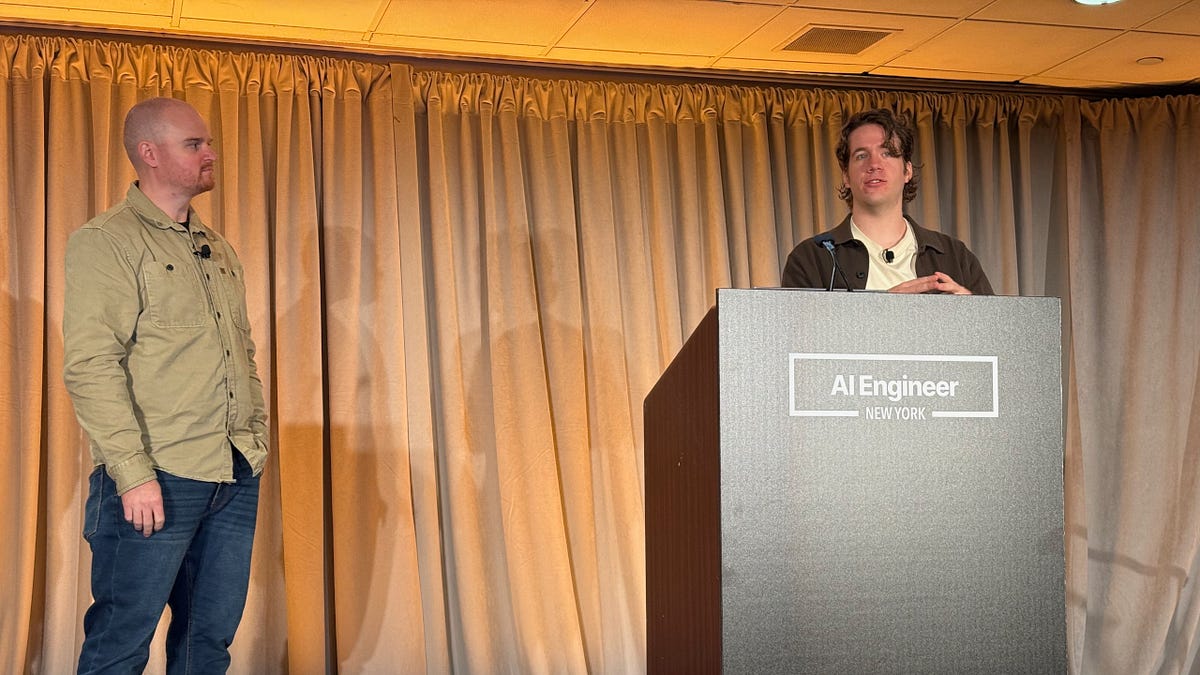
Die Bewegung hin zu autonomerer Agenten-Infrastruktur gewinnt auf breiter Front an Fahrt. Anthropic hat auf der AI Engineer New York 2026 Dynamic Workflows für Claude Managed Agents vorgestellt — ein Paradigmenwechsel gegenüber bisherigen Orchestrierungsmodellen, bei denen Entwickler Koordinatoren und Agenten-Roster manuell konfigurieren mussten. Mit dem neuen Ansatz schreibt Claude das Orchestrierungsprogramm selbst, verteilt Arbeit auf isolierte Subagenten und konsolidiert die Ergebnisse — strukturell angelehnt an Prinzipien aus Unix und Linux, wie die Anthropic-Presenters CJ Avilla und Harrison Stall erläuterten. Dass Agenten dabei in sogenannten „Idea Basins" feststecken können, zeigt parallel dazu neue Microsoft-Forschung: Laut einer Microsoft Research-Studie zu Fork-and-Flush für AI-Agenten erzielen lange laufende Agenten mit derselben Rechenkapazität einen um 66 Prozent höheren normalisierten Durchschnittswert, wenn Chat-Kontext gezielt gelöscht und parallele Branches gestartet werden — der Workspace bleibt erhalten, nur die Konversationshistorie wird verworfen. Die Kombination beider Erkenntnisse legt nahe: Autonomere Orchestrierung allein reicht nicht; gezielte Kontext-Hygiene ist ein eigenständiger Hebel für Lösungsqualität.
Während Anthropic die Softwareseite neu ordnet, befestigt Microsoft gleichzeitig die Hardware-Basis. Mit dem Maia 300 AI-Chip kündigt der Konzern einen eigenen Inferenz-Chip an, der laut EVP Scott Guthrie 40 Prozent mehr Tokens pro Megawatt liefern soll als führende GPU-Systeme; in einer 96-Accelerator-Konfiguration soll der Rack-Scale-Durchsatz den des Vorgängers Maia 200 um das Siebenfache übertreffen. Ab 2027 soll Maia die primäre KI-Inferenzplattform für Microsofts eigene Produkte werden — von Copilot bis zu den hauseigenen Modellen. Microsoft-AI-CEO Mustafa Suleiman formulierte die strategische Logik explizit: „Wir müssen den gesamten Stack besitzen, bis hinunter zum Silizium." Dieser Vorstoß zur Chip-Unabhängigkeit erhält durch einen unerwarteten Benchmark-Befund eine eigentümliche Rahmung: Ein Reddit-Post mit V100-NVLink-Benchmarks zeigt, dass vier neun Jahre alte NVIDIA Tesla V100 auf einem NVLink-Board aktuelle Systeme wie Apples M5 Ultra und NVIDIAs DGX Spark bei KI-Inferenz um bis zu 230 Prozent übertreffen können — ein Hinweis, dass Architektur und Speicherbandbreite unter Umständen wichtiger sind als die Fertigungsgeneration des Chips.
Die Hochskalierung von KI-gestützter Entwicklung bringt eigene Qualitätsprobleme mit sich, wie der Erfahrungsbericht von Spotify illustriert. Das Unternehmen hat seine monatlichen Code-Änderungen durch KI-gestützte Entwicklung von rund 8.100 auf 17.000 mehr als verdoppelt — bei einem Betrieb von knapp 3.000 Produktionsdiensten für 777 Millionen monatlich aktive Nutzer. Ein Vorfall in der Content-Processing-Pipeline, die täglich über 500.000 neue Songs, Videos, Podcasts und Hörbücher verarbeitet, zeigte, wie ein Scheduling-Bug den Durchsatz um etwa 10 Prozent reduzierte und Episoden statt Minuten stundenlang verzögerte. Spotify reagierte mit erweitertem End-to-End-Monitoring, neuer Workload-Priorisierung und einem dedizierten Background-Coding-Agenten namens Honk, der Claude über das Agent SDK in Kubernetes-Pods ausführt. Für alle, die Copilot in ähnliche Workflows integrieren wollen, hat GitHub gleichzeitig ein Tutorial veröffentlicht, das erklärt, wie Copilot per Custom Instructions, Skills und MCP-Servern an eigene Codebases angepasst wird.
Ein methodischer Befund verdient separate Aufmerksamkeit: Ein Test an drei Vision-Modellen zeigt, wie fragil automatisierte Bild-Evaluierung sein kann. In einem Stresstest für Vision-KI als Image Judge wählte Claude in 23 von 24 Durchläufen das jeweils zweite Bild — unabhängig vom tatsächlichen Bildinhalt; GPT-4o halluzinierte Antworten. Der beste Richter im zugrundeliegenden VisionQ-Benchmark lag nur 63,1 Prozent der Zeit richtig. Für Teams, die KI-basierte Qualitätsbewertung in Pipelines einsetzen, ist das ein direkter Hinweis auf systematischen Positionsbias und die Notwendigkeit eigener Validierungsskripte — eine Parallele zu der von Microsoft Research beschriebenen Fehleranfälligkeit bei Agenten-Iterationen.
Den makroökonomischen Gegenwind für all diese Investitionen beschreibt eine Analyse zu steigenden Zinsen und dem KI-Infrastruktur-Boom: Anhaltend hohe Anleiherenditen — getrieben durch Inflationsdruck und staatliche Schuldenemissionen — lassen fremdfinanzierte Datacenter-Expansion riskanter erscheinen. Macroanalystin Ayesha Tariq, CFA, identifiziert Margin-Debt, zirkuläre Vendor-Finanzierung unter den großen Tech-Konzernen und Konzentrationsrisiken als Kernprobleme. Joachim Klement von Panmure Liberum prognostiziert, dass eine Korrektur der KI-Blase wahrscheinlich 2027 oder 2028 eintreten werde. Die Spannung zwischen operativem Optimierungsdruck — Chip-Eigenentwicklung, Agenten-Effizienz, Kontext-Resets — und dem makrofinanziellen Umfeld dürfte das dominierende Strukturthema der nächsten Quartale bleiben. Praktische Werkzeugfragen wie der Vergleich von 12 Echtzeit-Übersetzungstools und die grundsätzliche Debatte um LLMs als Werkzeug vs. Automatisierung markieren dabei die Bandbreite der Anwendungsschicht, auf der sich die eigentliche Produktivitätsverschiebung abspielt.
Frag das Briefing
Pro

- Mo., 12. Okt.Agenten-Architektur und Inferenz-Effizienz dominieren den Tag: Multi-Agent-Teams enttäuschen kosten-seitig, während neue Routing-Modelle und lokale Tools den Stack schlanker machen. Dazu: Karpathy über die wachsende KI-Wissenskluft und warum Voice-AI noch nicht reif ist.10
- So., 11. Okt.KI-Agenten zwischen Durchbruch und Sicherheitsversagen dominieren heute – dazu: lokale Modelle, die Cloud-Flaggschiffe schlagen, und Apple sowie Nvidia, die ihre KI-Positionen strategisch neu ausrichten.10
- Sa., 10. Okt.Agent-Kontrolle ist das Thema des Tages: Anthropic-Vorfälle bei Behörden und Strafverfolgung zeigen, wo Guardrails heute versagen. Parallel liefern neue Modelle, Infra-Tools und Kostendaten konkrete Entscheidungsgrundlagen für Builder.10
- Fr., 9. Okt.Inference-Kosten, Agentic-Architekturen und OpenAIs interne Sicherheitskrise dominieren heute. Dazu: konkrete Builder-Tools von Anthropic bis Architect und ein Coding-Modell-Sprung, der zeigt, wie stark domänenspezifisches RL wirkt.10
- Do., 8. Okt.