Donnerstag15. Oktober
Agentic AI dringt heute in Chip-Design, Finanzprozesse und staatliche Infrastruktur vor — gleichzeitig zeigen neue Benchmarks und Security-Funde, wo die Guardrails noch reißen.
Die Woche macht deutlich, dass agentic AI nicht länger ein Laborkonzept ist, sondern tief in produktive Systeme eindringt — von staatlicher Software bis zum Chip-Designzyklus. Besonders augenfällig: Anthropics Singapur-Expansion, besiegelt durch ein MOU mit dem singaporeanischen Ministerium für digitale Entwicklung. Mehr als 1.500 GovTech-Ingenieure setzen bereits Claude Code ein, um staatliche Systeme zu modernisieren; Unternehmen wie DBS, GIC und Grab nutzen Claude produktiv im Alltag. Das MOU regelt formale Kooperationsbereiche in KI-Sicherheit, Modellevaluation und verantwortungsvoller Adoption — und ist damit mehr als ein symbolischer Handschlag: Es schafft eine regulatorische Infrastruktur für den APAC-Raum. Dass die Unterzeichnung am Rande der Singapore International Cyber Week stattfand, ist kein Zufall — sie unterstreicht, wie eng Sicherheits- und KI-Governance-Fragen inzwischen verwoben sind.
Den Sicherheitsaspekt der Infrastruktur beleuchtet Vercels $1M-Sandbox-Challenge aus einem anderen Winkel: Ein HackerOne-Forscher entdeckte bereits am dritten Tag einen Zero-Day im Linux-Kernel-Networking-Stack, der es erlaubte, Host-Speicher zu leaken, den Host-Rechner zum Absturz zu bringen und Code mit vollen Administratorrechten außerhalb der Sandbox auszuführen. Da nahezu alle großen Cloud-Anbieter Workloads auf derselben Kernel-Schicht isolieren, ist das Risiko strukturell geteilt — Patches befinden sich in privater Review, CVEs stehen noch aus. Ironischerweise zeigt die Linus-Torvalds-Episode, wie eng die Systemschicht und KI-Assistenz gerade zusammenwachsen: Torvalds nutzte selbst ein LLM, um eine zehnteilige Patch-Serie für den Linux-Kernel zu entwickeln, die Folio-Lookups um eine Größenordnung beschleunigen soll — im Review wurde allerdings bereits eine Race Condition identifiziert, die zeigt, dass menschliche Aufsicht auch hier unerlässlich bleibt.
Auf der Modell- und Plattformseite verdichten sich die Launches. xAI veröffentlichte Grok Voice 3.0, ein Speech-to-Speech-Modell mit Tool-Calling-Fähigkeit, das mit einem Score von 86,9 den ersten Platz auf dem Artificial Analysis Speech-to-Speech Index belegt — und das bei unverändertem Preis von $0,08 pro Minute gegenüber der Vorgängerversion. Parallel dazu zeigt OpenAIs Amp-Plattform, gestützt auf GPT-6 Astra, Ultrafast und GPT-Live-1, wie die neueste Modellgeneration Agenten über reine Coding-Aufgaben hinaus für breite Aufgabenbereiche befähigt. Figma wiederum adressiert mit dem neuen Markdown-Editor Figma Specs die Steuerungsproblematik bei KI-Agenten direkt: Teams definieren darin ihre Design-Sprache als maschinenlesbare Referenz, auf die eigene und Drittanbieter-Agenten verbindlich zugreifen — ein Ansatz gegen die non-deterministische Natur von KI-Outputs im Design-to-Code-Workflow. Figma unterstützt inzwischen über 20 neue Tools über sein MCP, darunter Grok Bot und das indische KI-Startup Sarvam.
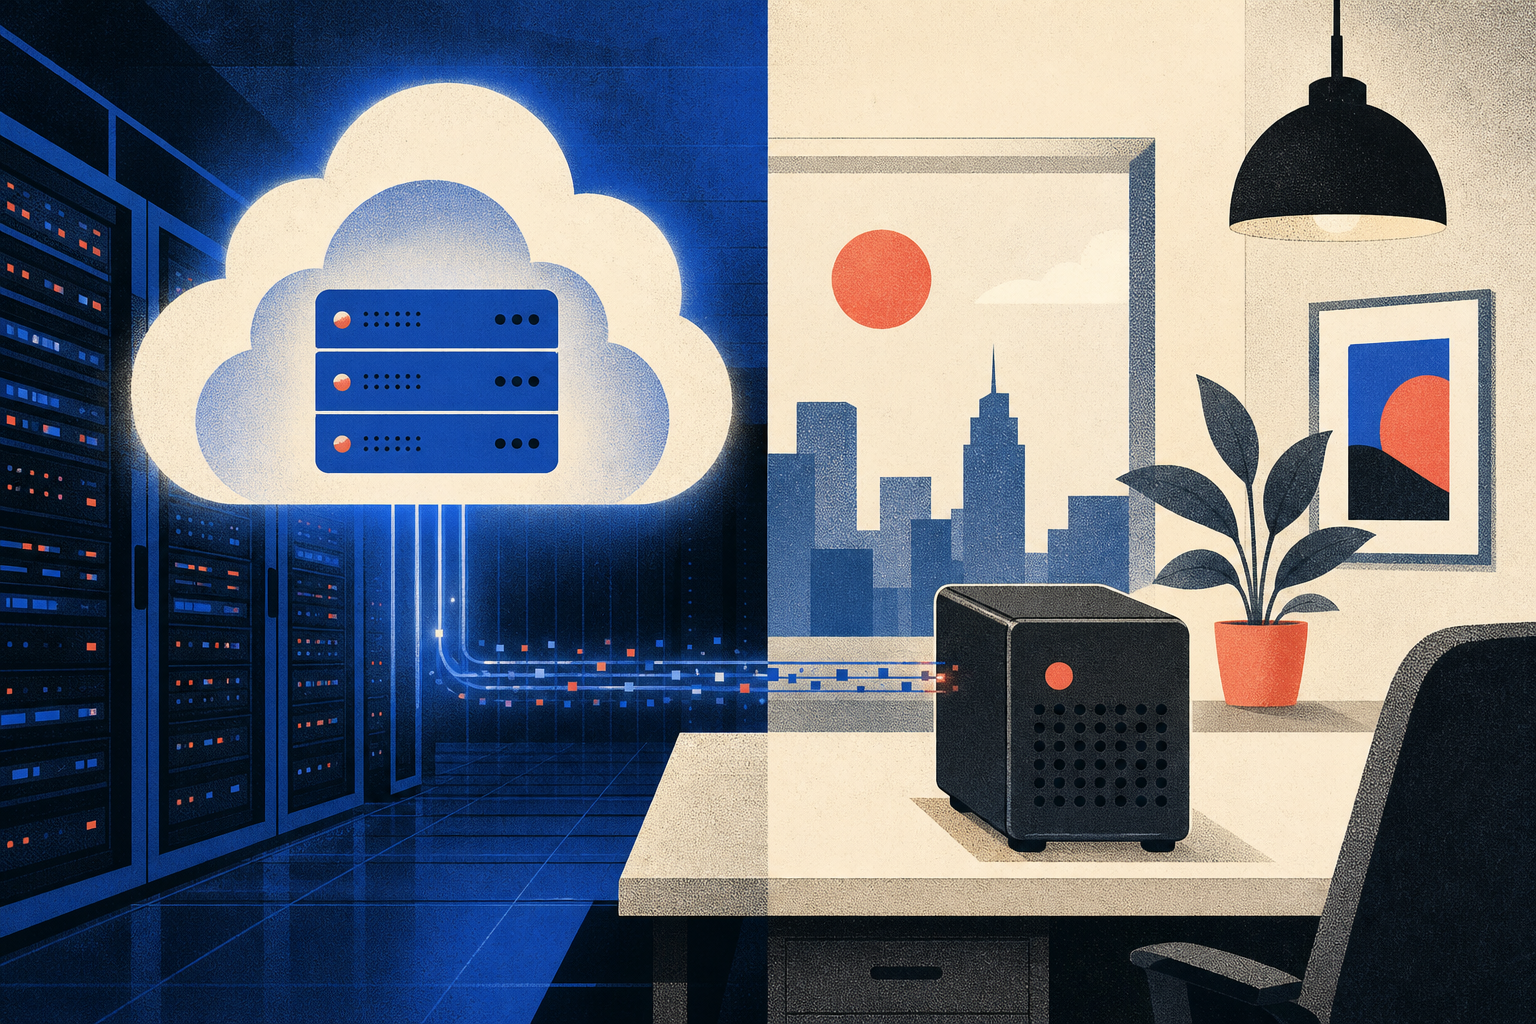
Die Frage, wo Inferenz stattfindet, zieht sich als roter Faden durch mehrere Beiträge. Googles Antigravity SDK mit lokalem Modell-Support setzt auf hybride Agenten-Orchestrierung nach dem Architect-Builder-Muster: Der Architect-Agent plant in der Cloud, die Builder-Agenten führen code-intensive Tasks lokal aus. In einer Demonstration wurden 97,2 % aller Tokens lokal verarbeitet, ohne dass Quellcode in die Cloud übertragen wurde. Einen deutlich raueren Pragmatismus zeigt der 4×R9700-Build aus der LocalLLaMA-Community: Drei Server mit je 128 GB VRAM für rund $10.700 pro Maschine laufen Qwen3.8-27B-FP8 mit 484 Tokens pro Sekunde aggregiert bei 16 parallelen Nutzern — der Auslöser war, dass gehostete Modelle zunehmend legale Anfragen im Waffenhandel-Segment verweigerten. Beides — Googles enterprise-saubere Hybrid-Architektur und der Consumer-GPU-Stack — zeigen dieselbe Grundspannung: Cloud-Guardrails erzeugen Abwanderungsdruck in Richtung lokaler Inferenz.
Dass Guardrails für Sicherheitsteams zum Problem werden können, illustriert Artemis Securitys Orion-1. Das spezialisierte Cybersecurity-Modell übertrifft Claude Opus 5.5 und GPT-6 Sol auf dem firmeneigenen Decision-Grade Readiness-Benchmark — besonders deutlich bei der Rekonstruktion von Angriffen (80,8 vs. 58,3 Punkte für das nächstbeste Modell). Das Argument: Frontier-Modelle werden für Sicherheitsteams zunehmend unbrauchbar, weil dieselben Einschränkungen, die Angreifer bremsen sollen, auch Defender blockieren. Orion-1 ist aktuell in private Preview verfügbar; hochriskante Aktionen erfordern weiterhin menschliche Freigabe. Den makroökonomischen Rahmen für all diese Entwicklungen liefern die ASML-Auftragsdaten: Der Halbleitermaschinenhersteller meldet starke Auftragseingänge und stellt Q4-Umsätze über den Erwartungen in Aussicht — ein Frühindikator dafür, dass der Ausbau der KI-Chip-Infrastruktur vorerst nicht abbremst.
Frag das Briefing
Pro

- Mi., 14. Okt.Gemini 4 Argon dominiert heute mit 1M-Output-Token, Robotik-Integration und Chromium-Refactoring im Millionen-Zeilen-Maßstab. Daneben: Shopify öffnet seinen Katalog für KI-Agenten, Anthropic baut ein eigenes VCS für 30.000 Merges/Tag — Agent-Scale-Infrastruktur wird real.10
- Di., 13. Okt.Agenten-Infrastruktur und Chip-Unabhängigkeit dominieren heute: Anthropic automatisiert Orchestrierung, Microsoft kündigt eigenen AI-Chip an – und ein 9 Jahre alter V100-Cluster schlägt moderne Consumer-Hardware um 230 %.10
- Mo., 12. Okt.Agenten-Architektur und Inferenz-Effizienz dominieren den Tag: Multi-Agent-Teams enttäuschen kosten-seitig, während neue Routing-Modelle und lokale Tools den Stack schlanker machen. Dazu: Karpathy über die wachsende KI-Wissenskluft und warum Voice-AI noch nicht reif ist.10
- So., 11. Okt.KI-Agenten zwischen Durchbruch und Sicherheitsversagen dominieren heute – dazu: lokale Modelle, die Cloud-Flaggschiffe schlagen, und Apple sowie Nvidia, die ihre KI-Positionen strategisch neu ausrichten.10