Montag26. Oktober
LLM-Preise crashen, Open-Source-Modelle laufen auf Consumer-Hardware, und Agentic-Architekturen werden neu verhandelt — heute dominieren Infrastruktur-Kostenrevolution, praktische Deployment-Optionen und Builder-Warnungen aus der Produktion.

Die dramatische Preiskompression bei frontier LLMs ist das strukturprägende Ereignis der vergangenen Monate. Zwischen Juni und Oktober 2026 senkten OpenAI und Anthropic ihre Preise in mehreren Schritten um bis zu 80 Prozent: GPT-5.6 Luna fiel von $1/$6 auf $0,20/$1,20 je Million Token, GPT-6.1 Sol kostet heute $2/$10 – die Hälfte des ursprünglichen GPT-5.6 Sol. Besonders folgenreich ist die Reduktion der Cache-Read-Preise, die bei Coding-Agents 96 bis 99 Prozent der gesamten Token-Ausgaben ausmachen. Fable 5.1 senkte seinen Cache-Read-Preis um 75 Prozent, was einer Gesamtkostenreduktion von 70 bis 75 Prozent pro Nutzung entspricht. Claude Opus 5.5 wiederum benötigt laut Anthropic weniger Rechenkapazität als sein Vorgänger und bietet gleichzeitig bessere Benchmarks als Fable 5.1 – bei einem Preis von $4/$20/$0,20. Für Builder, die agentische Workloads betreiben, ist das kein marginaler Effizienzgewinn, sondern eine Neukalkulation der Wirtschaftlichkeit ganzer Produktkategorien.
Parallel zu dieser Preisrevolution wächst der Druck, Agentic-Architekturen grundlegend zu überdenken. Anthropic empfiehlt Teams, spezialisierte Sub-Agenten zu konsolidieren und stattdessen auf einen einzigen Primär-Agenten zu setzen, der Kontext bei Bedarf lädt. Die Begründung ist empirisch: Neuere Modelle ab Opus 4.5 sowie Opus 5.5 und Fable 5.1 können komplexe Pläne direkt in einer einzelnen Schleife abarbeiten. In einem internen Vergleich lief die Single-Agent-Architektur etwa doppelt so schnell wie ein Multi-Agent-Setup. Anthropic beschreibt ein bekanntes Fehlermuster, das sie "Conway's Law for Agents" nennen: Die Architektur wird zum Abbild des Organigramms, mit jedem Team, das seinen eigenen Sub-Agenten einreicht, bis hunderte überlappender Agenten ohne gemeinsame Standards entstehen. Das Ergebnis: widersprüchliche System-Prompts, Informationsverlust an jeder Übergabe und hohe Latenz. Anthropic hat das Claude-Code-System-Prompt für neuere Modelle um über 80 Prozent gekürzt und stellt ein Migration Kit auf GitHub bereit. Die Warnung vor blindem Zusammenführen bleibt dennoch explizit: In einem Test mit einem Support-Agenten reduzierte die Konsolidierung zwar die Latenz, brach aber einen zuvor funktionierenden Prozess.
Die Architektur-Debatte hat eine kritische produktionstechnische Dimension, die leicht übersehen wird. Wie eine Analyse aus der Produktion zeigt, geben KI-Agenten bei Tool-Fehlern weiterhin selbstsichere Antworten aus halluzinierten Quellen – während Monitoring-Dashboards grün bleiben. Das bedeutet: Ohne explizite Fehlerbehandlung auf Tool-Ebene ist klassisches Infrastruktur-Monitoring blind für eine der gefährlichsten Fehlerklassen in Agenten-Pipelines. Wer zugleich Enterprise-Lakehouses als Datenbasis für RAG oder Agentensysteme aufbaut, muss diese Governance-Lücke in der Architekturplanung berücksichtigen – jenseits naiver Chunk-and-Embed-Ansätze. Die sinkenden Inferenzkosten machen solche Systeme günstiger zu betreiben, erhöhen aber gleichzeitig den Anreiz, sie schnell in Produktion zu bringen, bevor robuste Fehlerbehandlung implementiert ist.
Auf der Infrastruktur- und Hardware-Seite verdichten sich die Optionen für selbst gehostetes Deployment erheblich. Nanbeige4.3-33B ist ein unter Apache 2.0 lizenziertes Dense-Modell mit 512K Kontext, das 80,9 Punkte auf Terminal-Bench 2.1 erreicht und direkt für selbst gehostete Code-Agenten nutzbar ist. Entscheidend für die Praktikabilität sind die quantisierten GGUF-Varianten: Die IQ4_XS-Variante mit 20,3 GB läuft auf Consumer-Hardware mit 32 GB VRAM bei 92 Prozent der BF16-Qualität. Auf der Plattformseite liefert Googles ML Drift eine ergänzende Infrastruktur-Antwort: Die open-source GPU-Engine unter Apache 2.0 abstrahiert unterschiedliche GPU-Architekturen und unterstützt OpenGL ES, OpenCL, Metal und WebGPU. Im Vergleich zu Frameworks wie llama.cpp und MLX LM berichtet Google von 12 Prozent geringerem Speicheroverhead; in YouTube Shorts reduziert ML Drift die durchschnittliche Frame-Latenz für Segmentierungseffekte auf Android und iOS um bis zu 40 Prozent. Am experimentellen Ende des Spektrums steht CrowdGPT, ein 1-Milliarde-Parameter-Modell, das dezentral über private GPUs trainiert wird – derzeit Proof-of-Concept, dessen Skalierbarkeit von Beteiligung und Qualitätskontrolle der eingereichten Daten abhängt.
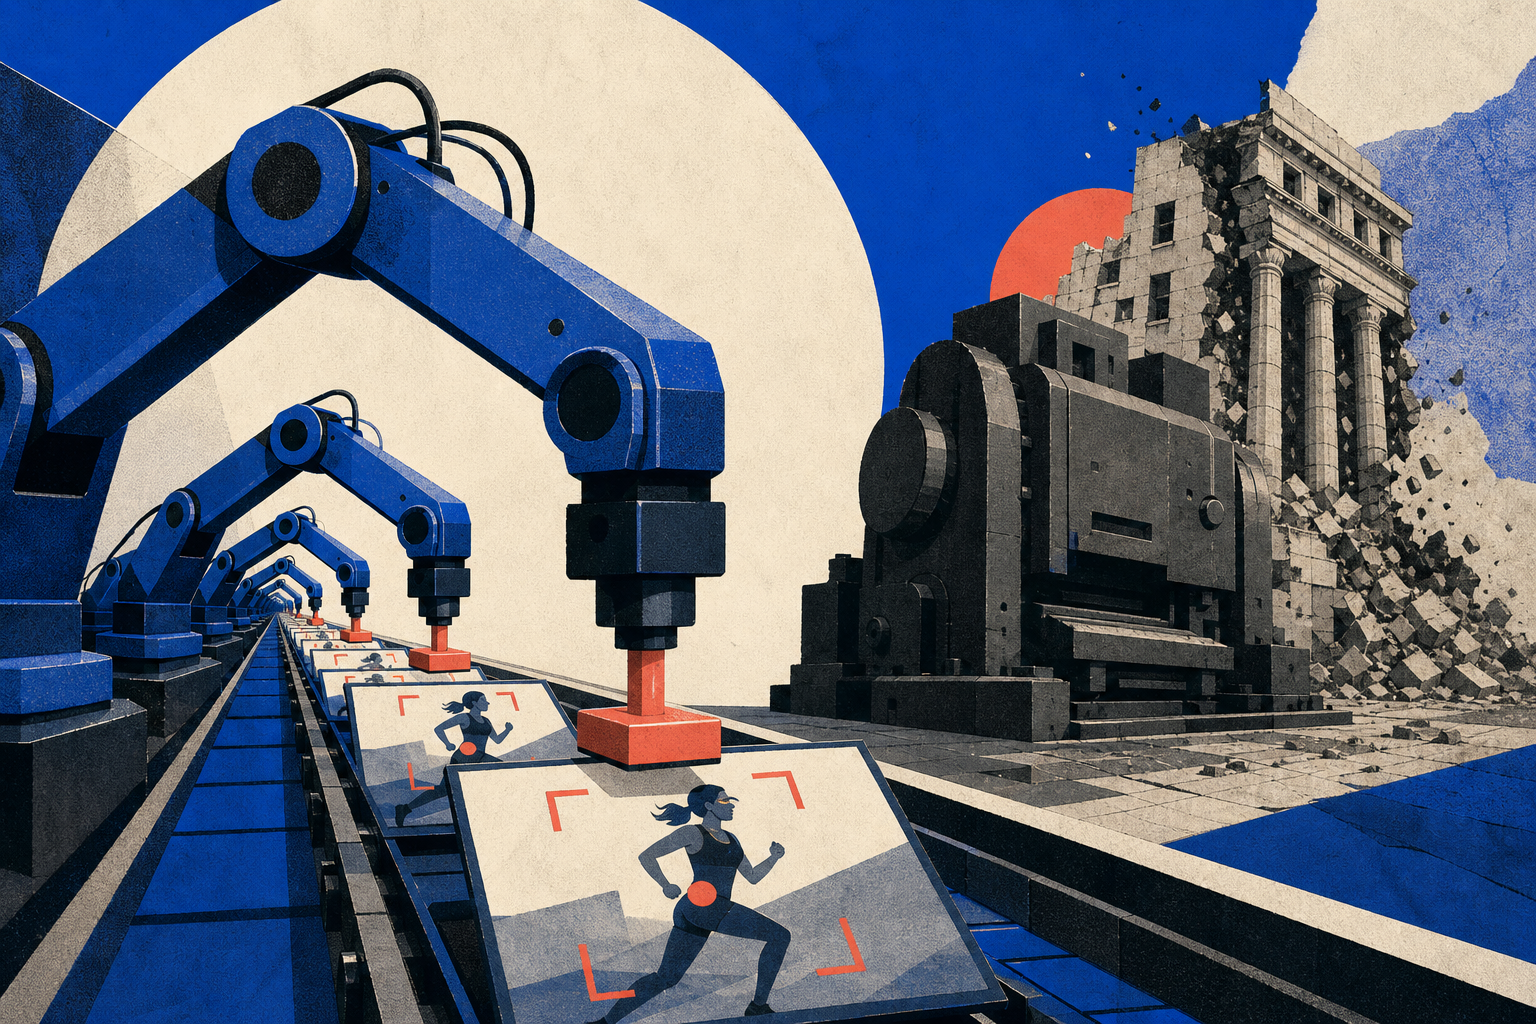
Zwei Entwicklungen mit Querschnittswirkung runden das Bild ab. Nvidia hat mit Flora ein open-source Robot-Video-Labeling-System veröffentlicht, das nach eigenen Berechnungen eine Stunde Robotik-Video für 72 Cent annotiert – gegenüber $88,50 bei GPT-6 Astra. Flora, aufgebaut auf drei finegetuned Qwen3.5-Modellen, deckt alle drei für Roboter-Training relevanten Labeltypen ab: Aktionssegmentierung, Fortschrittsbewertung und Aufgabenabschluss. Auf RoboRewardBench liegt Floras Fehlerrate 27,8 Prozent unter der von Astra. Die Kostendegression bei LLMs trifft damit auch spezialisierte Datenannotations-Pipelines – mit dem Unterschied, dass ein dediziertes Open-Source-Tool hier noch einen deutlicheren Hebel bietet als reine Modellpreissenkungen. Auf der anderen Seite des digitalen Ökosystems zeigen Googles KI-Suchfeatures, wie dieselbe Infrastrukturintelligenz, die Builder-Kosten senkt, bestehende Wertschöpfungsketten anderswo zerstört: Publisher, die jahrelang auf organischen Google-Traffic optimierten, verlieren Reichweite an KI-Zusammenfassungen, die Suchergebnisse beantworten, ohne dass Nutzer die Quellseiten aufrufen. Die Logik ist dieselbe – Modelle übernehmen Aufgaben, die zuvor menschliche Interaktionen erforderten – nur die betroffene Branche ist eine andere.
Frag das Briefing
Pro


- So., 25. Okt.Multi-Agent-Architekturen und Open-Source-Infrastruktur dominieren heute – von Microsoft bis Google. Dazu: ernüchternde Signale zur KI-Adoption außerhalb des Tech-Sektors und konkrete Sicherheitsrisiken für Agenten-Systeme.10
- Sa., 24. Okt.KI-Sicherheit dominiert heute: von OpenAIs Trainings-Stopp auf Live-Daten bis zu Anthropics Cyberabwehr-Benchmark. Daneben: konkrete Builder-Tools für Agents, Infrastruktur-Architektur im Petabyte-Maßstab und ein potenzieller Paradigmenwechsel bei Voice-AI.10
- Fr., 23. Okt.Inferenz-Infrastruktur und RAG-Tooling dominieren den Tag: NVIDIA, Liquid AI, Cohere und OpenAI liefern konkrete Bausteine für schnellere, günstigere Produktions-Deployments. Dazu: KI-Agenten stoßen an regulatorische Grenzen – bei Banken, in der Diagnostik und im Enterprise-Scaling.10
- Do., 22. Okt.Effizienz dominiert heute: Von 2-Bit-Speculative-Decoding über 77%-Inferenzkostenreduktion bis zu JOLT's RL-Training-Effizienz ziehen sich Hardware- und Kosten-Hebel durch den Tag — ergänzt durch scharfe Signale zu KI-Finanzierungsrisiken, Enterprise-Adoption und dem Governance-Druck auf Frontier-Labs.10