Byte-Level Transformer löst skriptübergreifende Namenssuche mit 0.775 MRR
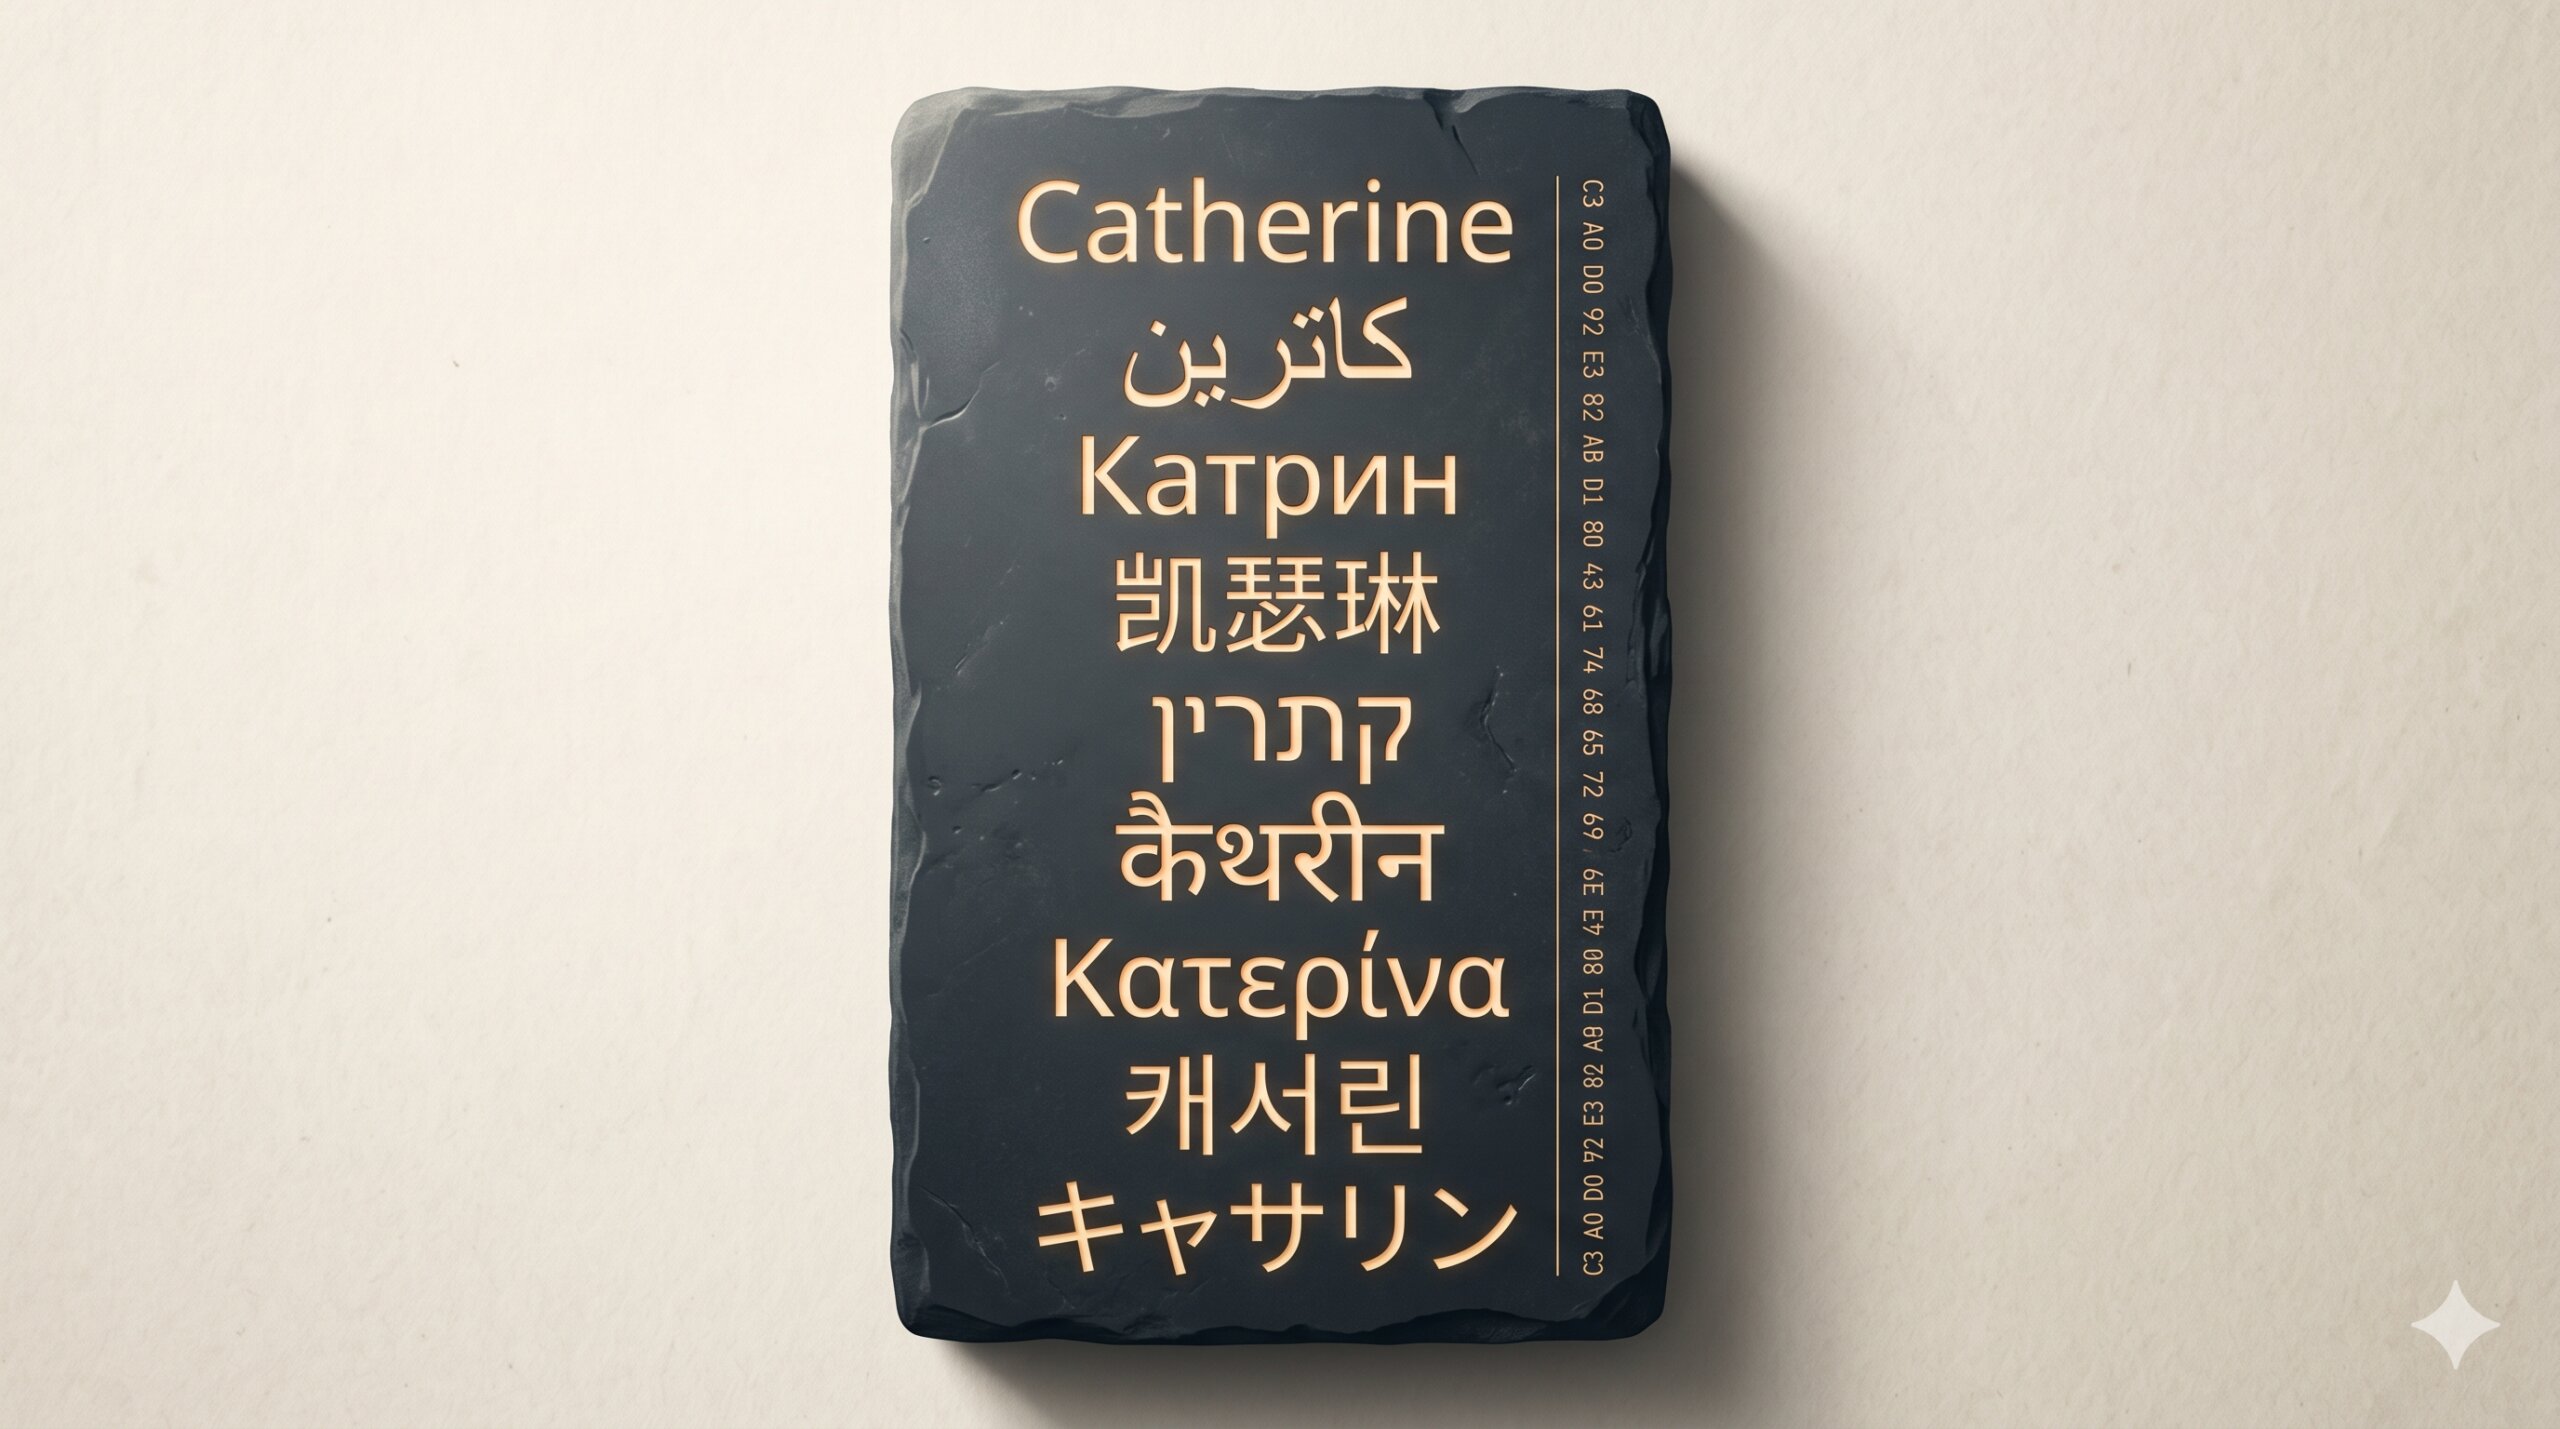
Das Kernproblem, das der Beitrag adressiert, ist strukturell: Strings wie „Владимир Путин" und „Vladimir Putin" teilen buchstäblich kein einziges Zeichen, weshalb klassische Ähnlichkeitsmaße wie Edit-Distance oder Soundex vollständig versagen. Autor Vedant Jumle beschreibt, wie statt eines großen multilingualen Sprachmodells ein schlanker Transformer-Encoder mit rund 4 Millionen Parametern von Grund auf auf rohen UTF-8-Bytes trainiert wurde – ohne Tokenizer, ohne vortrainiertes Backbone und ohne explizite Schrifterkennung. Die zentrale Beobachtung: Jedes Unicode-Zeichen zerlegt sich deterministisch in 1–4 Bytes aus einem fixen 256-Symbol-Alphabet, das universell für alle Schriften gilt. Das Trainingskorpus wurde mit einer vierstufigen LLM-Pipeline aufgebaut: Erst wurden 2 Millionen Personennamen-Entitäten stratifiziert aus Wikidata gesampelt, dann generierte Llama-3.1-8B phonetische Lateinvarianten, anschließend transliterierte Qwen3-Coder-30B-A3B-Instruct-FP8 diese in acht Nicht-Latin-Schriften (Arabisch, Russisch, Chinesisch, Japanisch, Hebräisch, Hindi, Griechisch, Koreanisch). Das Ergebnis: 119.040 Entitäten mit 4,67 Millionen positiven Paaren, klassifiziert in die Pair-Typen „phonetic", „script" und „combined". Die Modellarchitektur umfasst 6 Transformer-Layer, 8 Attention-Heads, Hidden-Dim 256 und FFN-Dim 1024. Negatives werden nicht statisch gespeichert, sondern dynamisch während des Trainings gemint. Das Verfahren richtet sich explizit an Compliance-, Migrations- und Krankenhaussysteme, die täglich skriptübergreifende Namensabgleiche durchführen müssen.
- Wikidata-Sampling: Stratifizierung nach Script-Coverage-Buckets (0, 1–2, 3–4, 5+ Nicht-Englisch-Labels) ergab 119.040 Entitäten mit balancierter Skriptabdeckung.
- Llama-3.1-8B-Instruct erzeugte pro Ankername exakt 4 phonetische Lateinvarianten via striktem JSON-Prompt – Spitznamen und Abkürzungen waren explizit verboten.
- Qwen3-Coder-30B-A3B-Instruct-FP8 übernahm die Transliteration in 8 Schriften; jede Pipeline-Stage ist unabhängig fortsetzbar und überspringt bereits verarbeitete Entity-IDs.
- Train/Val/Test-Split 80/10/10 erfolgt deterministisch per MD5-Hash der Entity-ID, sodass alle Varianten einer Identität in exakt eine Partition fallen.
- Verglichen mit der besten klassischen Baseline (z. B. Double Metaphone, ICU Transliterate) reduziert das Modell den Performance-Gap zwischen Latin- und Nicht-Latin-Queries um den Faktor 10.
Frag die KI zum Artikel
Folgefragen zu Headline, Quelle und Volltext — Antwort streamt in wenigen Sekunden.
Verwandte Beiträge
- FORSCHUNGarxiv.org3w
CyrillicQA: Wie phonetisch kodierte Sprache LLM-Leistung beeinflusst
- FORSCHUNGarxiv.org1w
SupraTok: Neuer Tokenizer übertrifft BPE um 17,5 % bei Kompression
- FORSCHUNGarxiv.org3w
Sprachfamilien-basierte Connector-Sharing-Strategie verbessert multilinguales ASR
- FORSCHUNGarxiv.org1d
ExpertHTR: Unified HTR mit Multi-Task-Learning und Sparse Mixture-of-Experts
Byte-Level Transformer löst skriptübergreifende Namenssuche mit 0.775 MRR
Das Kernproblem, das der Beitrag adressiert, ist strukturell: Strings wie „Владимир Путин" und „Vladimir Putin" teilen buchstäblich kein einziges Zeichen, weshalb klassische Ähnlichkeitsmaße wie Edit-Distance oder Soundex vollständig versagen. Autor Vedant Jumle beschreibt, wie statt eines großen multilingualen Sprachmodells ein schlanker Transformer-Encoder mit rund 4 Millionen Parametern von Grund auf auf rohen UTF-8-Bytes trainiert wurde – ohne Tokenizer, ohne vortrainiertes Backbone und ohne explizite Schrifterkennung. Die zentrale Beobachtung: Jedes Unicode-Zeichen zerlegt sich deterministisch in 1–4 Bytes aus einem fixen 256-Symbol-Alphabet, das universell für alle Schriften gilt. Das Trainingskorpus wurde mit einer vierstufigen LLM-Pipeline aufgebaut: Erst wurden 2 Millionen Personennamen-Entitäten stratifiziert aus Wikidata gesampelt, dann generierte Llama-3.1-8B phonetische Lateinvarianten, anschließend transliterierte Qwen3-Coder-30B-A3B-Instruct-FP8 diese in acht Nicht-Latin-Schriften (Arabisch, Russisch, Chinesisch, Japanisch, Hebräisch, Hindi, Griechisch, Koreanisch). Das Ergebnis: 119.040 Entitäten mit 4,67 Millionen positiven Paaren, klassifiziert in die Pair-Typen „phonetic", „script" und „combined". Die Modellarchitektur umfasst 6 Transformer-Layer, 8 Attention-Heads, Hidden-Dim 256 und FFN-Dim 1024. Negatives werden nicht statisch gespeichert, sondern dynamisch während des Trainings gemint. Das Verfahren richtet sich explizit an Compliance-, Migrations- und Krankenhaussysteme, die täglich skriptübergreifende Namensabgleiche durchführen müssen.
- Wikidata-Sampling: Stratifizierung nach Script-Coverage-Buckets (0, 1–2, 3–4, 5+ Nicht-Englisch-Labels) ergab 119.040 Entitäten mit balancierter Skriptabdeckung.
- Llama-3.1-8B-Instruct erzeugte pro Ankername exakt 4 phonetische Lateinvarianten via striktem JSON-Prompt – Spitznamen und Abkürzungen waren explizit verboten.
- Qwen3-Coder-30B-A3B-Instruct-FP8 übernahm die Transliteration in 8 Schriften; jede Pipeline-Stage ist unabhängig fortsetzbar und überspringt bereits verarbeitete Entity-IDs.
- Train/Val/Test-Split 80/10/10 erfolgt deterministisch per MD5-Hash der Entity-ID, sodass alle Varianten einer Identität in exakt eine Partition fallen.
- Verglichen mit der besten klassischen Baseline (z. B. Double Metaphone, ICU Transliterate) reduziert das Modell den Performance-Gap zwischen Latin- und Nicht-Latin-Queries um den Faktor 10.
Frag die KI zum Artikel
Folgefragen zu Headline, Quelle und Volltext — Antwort streamt in wenigen Sekunden.
Verwandte Beiträge
- FORSCHUNGarxiv.org3w
CyrillicQA: Wie phonetisch kodierte Sprache LLM-Leistung beeinflusst
- FORSCHUNGarxiv.org1w
SupraTok: Neuer Tokenizer übertrifft BPE um 17,5 % bei Kompression
- FORSCHUNGarxiv.org3w
Sprachfamilien-basierte Connector-Sharing-Strategie verbessert multilinguales ASR
- FORSCHUNGarxiv.org1d
ExpertHTR: Unified HTR mit Multi-Task-Learning und Sparse Mixture-of-Experts