Moonshot Kimi K2.6 aktualisiert: Open-Source-Modell erreicht Opus-4.6-Niveau
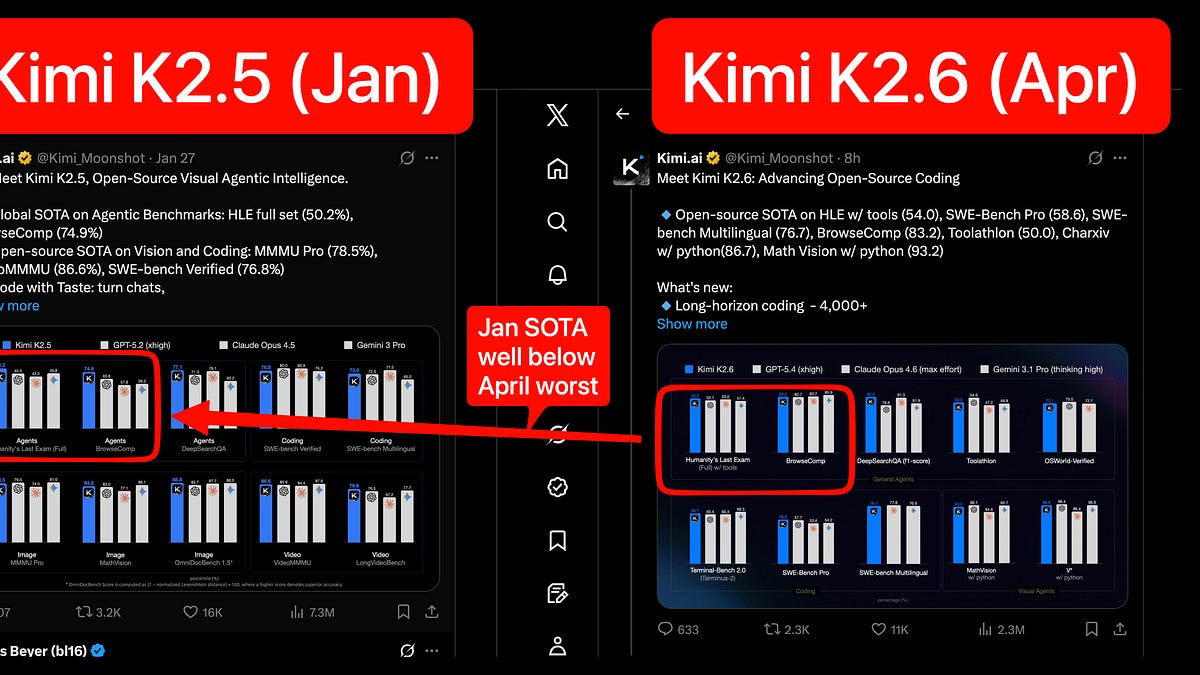
Kimi K2.6 ist ein Open-Weight-Modell mit einer Billion Parametern in einer Mixture-of-Experts-Architektur (32B aktive Parameter, 384 Experten bestehend aus 8 gerouteten und 1 geteilten), MLA-Attention, 256K Kontext und nativer Multimodalität. Das Modell baut auf dem im Januar 2026 veröffentlichten K2.5 auf, das Moonshot die Führung unter den chinesischen Open-Source-Labs einbrachte – eine Position, die das Lab seitdem hält, während DeepSeek seit v3.2 weitgehend schweigt. Technisch neu im Fokus stehen Langzeiteinsätze: K2.6 soll 4.000+ Tool-Calls, 12+ Stunden Dauerbetrieb und bis zu 300 parallele Sub-Agenten unterstützen; das hauseigene „Claw Groups"-Framework erweitert das frühere Agent-Swarm-RL-Konzept um strukturierte Multi-Agenten- und Human-in-the-Loop-Koordination. Auf Benchmarks beansprucht Moonshot Open-Source-SOTA bei HLE with Tools (54,0), SWE-Bench Pro (58,6), SWE-bench Multilingual (76,7) und BrowseComp (83,2). Im Frontend-Design-Bereich, der als Kerndomäne von Gemini gilt, weist Kimi eine Win+Tie-Rate von 68,6 % gegenüber Gemini 3.1 Pro aus. Day-0-Unterstützung besteht in vLLM, OpenRouter, Cloudflare Workers AI, Baseten, MLX, Hermes Agent und OpenCode. Die Community berichtet bereits von konkreten Einsätzen: einem fünftägigen autonomen Infra-Agent-Run, Kernel-Rewrites und einer Zig-basierten Inference-Engine, die LM Studio um 20 % TPS übertrifft.
- Architektur: 1T-Parameter MoE, 32B aktive Parameter, 384 Experten (8 geroutet + 1 geteilt), MLA-Attention, 256K Kontextfenster, INT4-Quantisierung
- Benchmark-Claims (Open-Source-SOTA): SWE-Bench Pro 58,6 – SWE-bench Multilingual 76,7 – BrowseComp 83,2 – Math Vision with Python 93,2
- Long-Horizon-Betrieb: 4.000+ Tool-Calls, 12+ Stunden Continuous Run, 300 parallele Sub-Agenten in einem einzigen Lauf dokumentiert
- Moonshot ist eines der drei chinesischen Labs, die Anthropic im Februar wegen Trainings-Praktiken (Modell-Distillation o. ä.) öffentlich beschuldigt hatte
- Alibaba Qwen3.6-Max-Preview erschien parallel: Qwen3.6 Plus erreichte Platz 7 im Code-Arena-Ranking, Alibaba rückte dort auf Lab-Platz 3 vor
Frag die KI zum Artikel
Folgefragen zu Headline, Quelle und Volltext — Antwort streamt in wenigen Sekunden.
Verwandte Beiträge
Moonshot Kimi K2.6 aktualisiert: Open-Source-Modell erreicht Opus-4.6-Niveau
Kimi K2.6 ist ein Open-Weight-Modell mit einer Billion Parametern in einer Mixture-of-Experts-Architektur (32B aktive Parameter, 384 Experten bestehend aus 8 gerouteten und 1 geteilten), MLA-Attention, 256K Kontext und nativer Multimodalität. Das Modell baut auf dem im Januar 2026 veröffentlichten K2.5 auf, das Moonshot die Führung unter den chinesischen Open-Source-Labs einbrachte – eine Position, die das Lab seitdem hält, während DeepSeek seit v3.2 weitgehend schweigt. Technisch neu im Fokus stehen Langzeiteinsätze: K2.6 soll 4.000+ Tool-Calls, 12+ Stunden Dauerbetrieb und bis zu 300 parallele Sub-Agenten unterstützen; das hauseigene „Claw Groups"-Framework erweitert das frühere Agent-Swarm-RL-Konzept um strukturierte Multi-Agenten- und Human-in-the-Loop-Koordination. Auf Benchmarks beansprucht Moonshot Open-Source-SOTA bei HLE with Tools (54,0), SWE-Bench Pro (58,6), SWE-bench Multilingual (76,7) und BrowseComp (83,2). Im Frontend-Design-Bereich, der als Kerndomäne von Gemini gilt, weist Kimi eine Win+Tie-Rate von 68,6 % gegenüber Gemini 3.1 Pro aus. Day-0-Unterstützung besteht in vLLM, OpenRouter, Cloudflare Workers AI, Baseten, MLX, Hermes Agent und OpenCode. Die Community berichtet bereits von konkreten Einsätzen: einem fünftägigen autonomen Infra-Agent-Run, Kernel-Rewrites und einer Zig-basierten Inference-Engine, die LM Studio um 20 % TPS übertrifft.
- Architektur: 1T-Parameter MoE, 32B aktive Parameter, 384 Experten (8 geroutet + 1 geteilt), MLA-Attention, 256K Kontextfenster, INT4-Quantisierung
- Benchmark-Claims (Open-Source-SOTA): SWE-Bench Pro 58,6 – SWE-bench Multilingual 76,7 – BrowseComp 83,2 – Math Vision with Python 93,2
- Long-Horizon-Betrieb: 4.000+ Tool-Calls, 12+ Stunden Continuous Run, 300 parallele Sub-Agenten in einem einzigen Lauf dokumentiert
- Moonshot ist eines der drei chinesischen Labs, die Anthropic im Februar wegen Trainings-Praktiken (Modell-Distillation o. ä.) öffentlich beschuldigt hatte
- Alibaba Qwen3.6-Max-Preview erschien parallel: Qwen3.6 Plus erreichte Platz 7 im Code-Arena-Ranking, Alibaba rückte dort auf Lab-Platz 3 vor
Frag die KI zum Artikel
Folgefragen zu Headline, Quelle und Volltext — Antwort streamt in wenigen Sekunden.