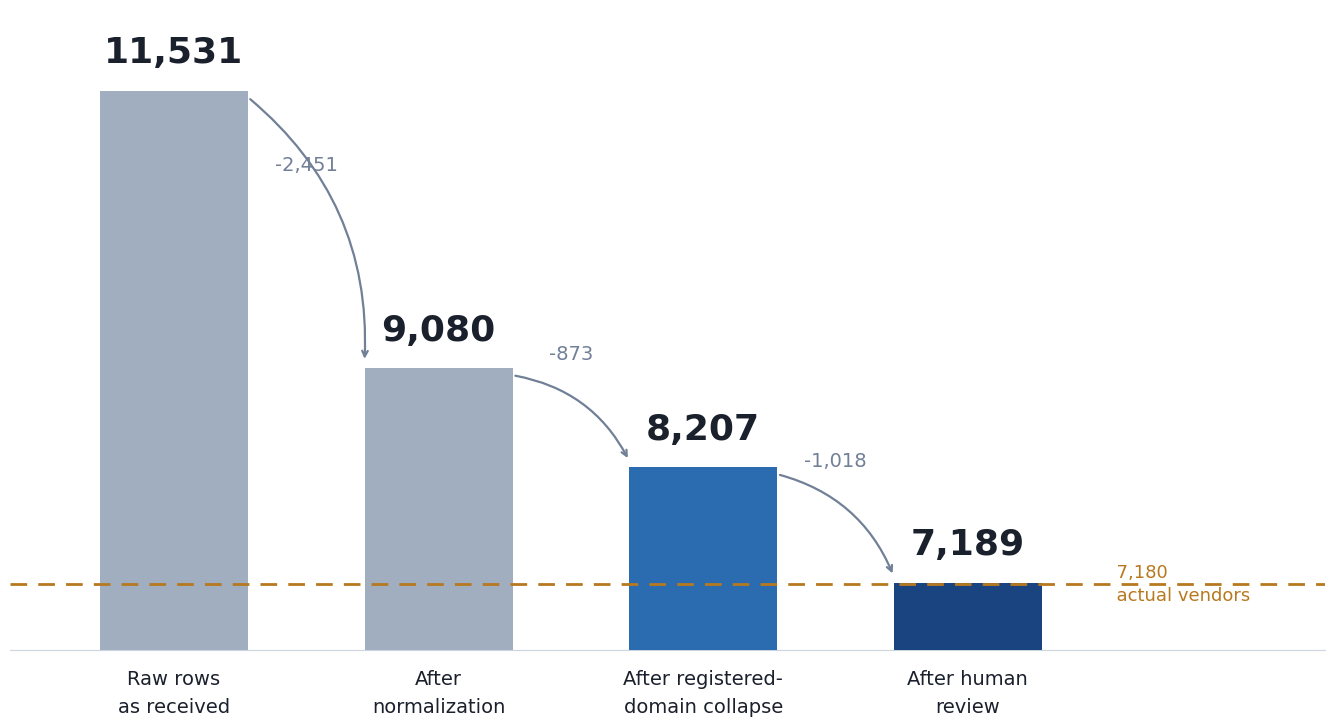
Deterministische Stufen schlagen Ähnlichkeits-Scores bei Duplikat-Erkennung
Warum es zählt
Wer Entity-Matching oder Datenbereinigungs-Pipelines baut, lernt, warum regelbasierte Vorfilter (z. B. Normalisierung, exakte Blöcke) zuverlässiger sind als ein einzelner Similarity-Score ohne klaren Schwellenwert.
— Lumeric Redaktion
Frag die KI zum Artikel
Folgefragen zu Headline, Quelle und Volltext — Antwort streamt in wenigen Sekunden.
Verwandte Beiträge
- MEINUNGtowardsdatascience.com2w
Entity Key Drift im Data Lake: Wenn Fuzzy Matching versagt
- FORSCHUNGarxiv.org3w
dedupT: Transformer-Modell reduziert Duplikate in Crash-Reports um 15 % MRR
- FORSCHUNGarxiv.org2w
PUFFER: Inkrementelles Fuzzy-Deduplication-System für LLM-Trainingsdaten
- FORSCHUNGarxiv.org1d
LLM-Pipeline für semantisches User-Profiling bei einer japanischen Großbank
Deterministische Stufen schlagen Ähnlichkeits-Scores bei Duplikat-Erkennung
Warum es zählt
Wer Entity-Matching oder Datenbereinigungs-Pipelines baut, lernt, warum regelbasierte Vorfilter (z. B. Normalisierung, exakte Blöcke) zuverlässiger sind als ein einzelner Similarity-Score ohne klaren Schwellenwert.
— Lumeric Redaktion
Frag die KI zum Artikel
Folgefragen zu Headline, Quelle und Volltext — Antwort streamt in wenigen Sekunden.
Verwandte Beiträge
- MEINUNGtowardsdatascience.com2w
Entity Key Drift im Data Lake: Wenn Fuzzy Matching versagt
- FORSCHUNGarxiv.org3w
dedupT: Transformer-Modell reduziert Duplikate in Crash-Reports um 15 % MRR
- FORSCHUNGarxiv.org2w
PUFFER: Inkrementelles Fuzzy-Deduplication-System für LLM-Trainingsdaten
- FORSCHUNGarxiv.org1d
LLM-Pipeline für semantisches User-Profiling bei einer japanischen Großbank