Nvidia Groq 3 LPX: 4× schneller als Cerebras – aber mit 64 Chips statt einem
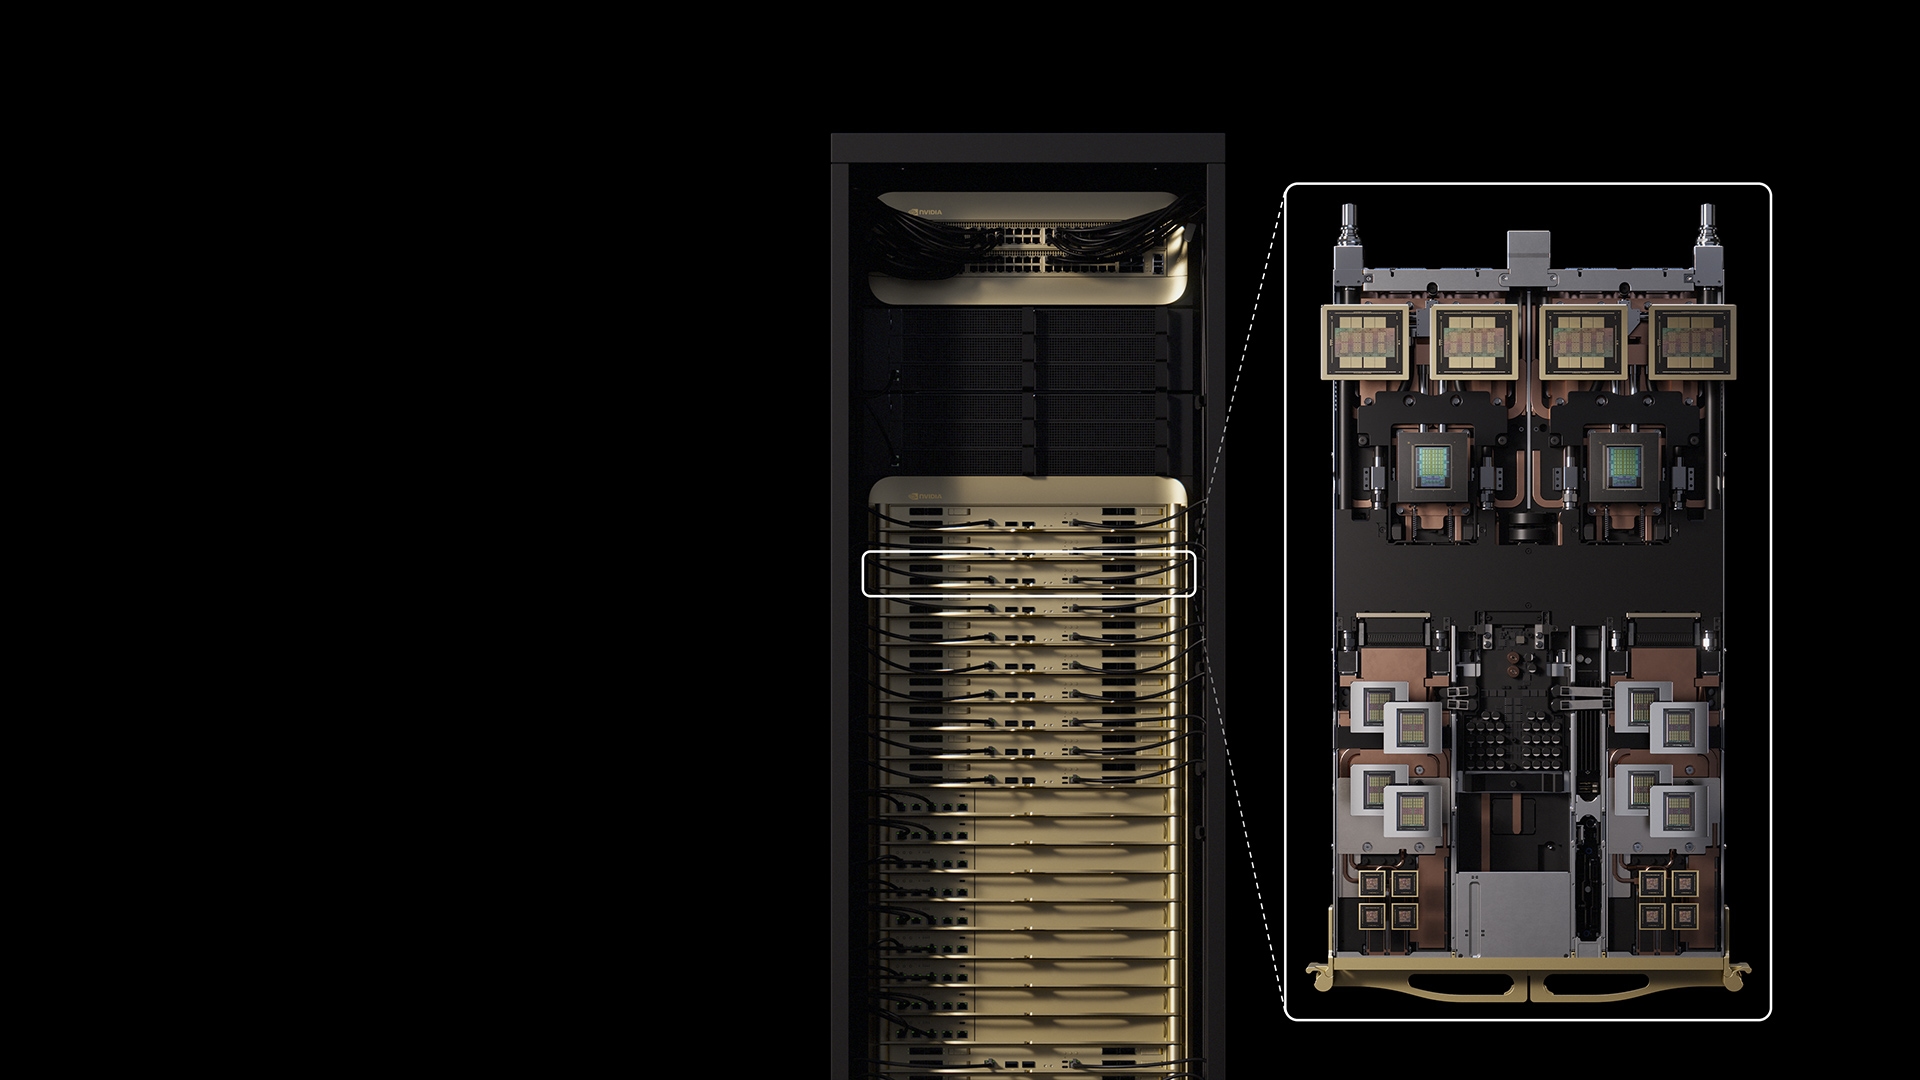
Nvidia hat seinen Groq 3 LPX-Inferenzchip in die Vollproduktion überführt und präsentiert dabei eine Benchmark-Zahl, die auf den ersten Blick beeindruckend klingt: 3.400 Tokens pro Sekunde auf dem Modell Gemma 4 31B – viermal mehr als Cerebras mit seiner konkurrierenden Lösung erreicht. Doch wie The Register herausarbeitete, vergleicht diese Zahl keine gleichwertigen Setups. Nvidia benötigt für diese Leistung mindestens 64 seiner Groq 3 LPX-Acceleratoren, während Cerebras dasselbe Benchmark-Ergebnis mit einem einzigen Chip – oder allenfalls zweien – erzielt. Das stellt die scheinbar klare Überlegenheit in ein anderes Licht: Die Gesamtkosten, der Energiebedarf und der Platzbedarf eines 64-Chip-Clusters sind naturgemäß erheblich höher als bei einer Ein-Chip-Lösung. Hinzu kommt, dass offen bleibt, wie gut der Groq 3 LPX mit großen Mixture-of-Experts-Modellen (MoE) skaliert – einem Architekturansatz, der bei modernen Frontier-Modellen zunehmend dominiert. Cerebras setzt mit seinem Wafer-Scale-Ansatz auf ein radikal anderes Designprinzip: ein einzelner, extrem großer Chip statt vieler koordinierter Einheiten. Für Käufer und Betreiber von KI-Infrastruktur bedeutet das, dass reine Token-Durchsatz-Zahlen ohne Kontext über Cluster-Größe und Effizienz pro Chip wenig aussagekräftig sind.
- Nvidia meldet 3.400 Tokens/Sekunde auf Gemma 4 31B – der Benchmark-Wert, auf den der 4×-Vergleich gegenüber Cerebras basiert.
- Für diesen Durchsatz sind mindestens 64 Groq 3 LPX-Acceleratoren notwendig, Cerebras erreicht vergleichbare Werte mit 1–2 Chips.
- Wie gut der Groq 3 LPX mit großen MoE-Modellen (Mixture of Experts) skaliert, bleibt laut Bericht eine offene Frage.
- Der Chip befindet sich nun in Vollproduktion – der genaue Produktionsstart und Verfügbarkeitszeitraum werden im Auszug nicht genannt.
- Die Analyse stammt wesentlich von The Register, das die Chip-Zahlen im Detail gegenübergestellt hat.
Frag die KI zum Artikel
Folgefragen zu Headline, Quelle und Volltext — Antwort streamt in wenigen Sekunden.
Verwandte Beiträge
Nvidia Groq 3 LPX: 4× schneller als Cerebras – aber mit 64 Chips statt einem
Nvidia hat seinen Groq 3 LPX-Inferenzchip in die Vollproduktion überführt und präsentiert dabei eine Benchmark-Zahl, die auf den ersten Blick beeindruckend klingt: 3.400 Tokens pro Sekunde auf dem Modell Gemma 4 31B – viermal mehr als Cerebras mit seiner konkurrierenden Lösung erreicht. Doch wie The Register herausarbeitete, vergleicht diese Zahl keine gleichwertigen Setups. Nvidia benötigt für diese Leistung mindestens 64 seiner Groq 3 LPX-Acceleratoren, während Cerebras dasselbe Benchmark-Ergebnis mit einem einzigen Chip – oder allenfalls zweien – erzielt. Das stellt die scheinbar klare Überlegenheit in ein anderes Licht: Die Gesamtkosten, der Energiebedarf und der Platzbedarf eines 64-Chip-Clusters sind naturgemäß erheblich höher als bei einer Ein-Chip-Lösung. Hinzu kommt, dass offen bleibt, wie gut der Groq 3 LPX mit großen Mixture-of-Experts-Modellen (MoE) skaliert – einem Architekturansatz, der bei modernen Frontier-Modellen zunehmend dominiert. Cerebras setzt mit seinem Wafer-Scale-Ansatz auf ein radikal anderes Designprinzip: ein einzelner, extrem großer Chip statt vieler koordinierter Einheiten. Für Käufer und Betreiber von KI-Infrastruktur bedeutet das, dass reine Token-Durchsatz-Zahlen ohne Kontext über Cluster-Größe und Effizienz pro Chip wenig aussagekräftig sind.
- Nvidia meldet 3.400 Tokens/Sekunde auf Gemma 4 31B – der Benchmark-Wert, auf den der 4×-Vergleich gegenüber Cerebras basiert.
- Für diesen Durchsatz sind mindestens 64 Groq 3 LPX-Acceleratoren notwendig, Cerebras erreicht vergleichbare Werte mit 1–2 Chips.
- Wie gut der Groq 3 LPX mit großen MoE-Modellen (Mixture of Experts) skaliert, bleibt laut Bericht eine offene Frage.
- Der Chip befindet sich nun in Vollproduktion – der genaue Produktionsstart und Verfügbarkeitszeitraum werden im Auszug nicht genannt.
- Die Analyse stammt wesentlich von The Register, das die Chip-Zahlen im Detail gegenübergestellt hat.
Frag die KI zum Artikel
Folgefragen zu Headline, Quelle und Volltext — Antwort streamt in wenigen Sekunden.