Google präsentiert zwei neue TPUs für das Agentic-AI-Zeitalter
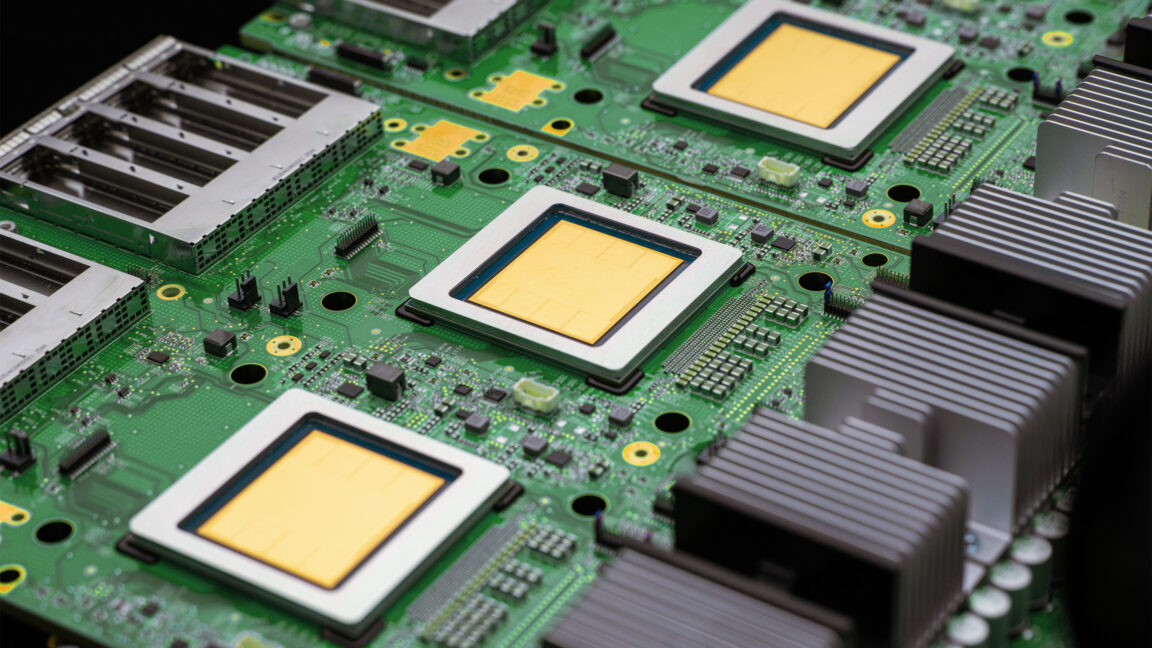
Mit der achten Generation seiner Tensor Processing Units vollzieht Google einen strategischen Schnitt: Statt einer einzigen verbesserten Chip-Variante gibt es erstmals zwei spezialisierte Designs – den TPU 8t für das Training von Frontier-Modellen und den TPU 8i für den Inferenz-Betrieb. Der TPU 8t ist in Pods mit je 9.600 Chips organisiert, die zusammen zwei Petabyte gemeinsamen Hochbandbreiten-Speicher bereitstellen und 121 FP4 EFlops Rechenleistung pro Pod liefern – fast dreimal so viel wie das Vorgängermodell Ironwood. Besonders hervorzuheben ist die lineare Skalierbarkeit: Google gibt an, bis zu einer Million Chips in einem einzigen logischen Cluster zusammenschalten zu können. Der TPU 8i hingegen ist auf den effizienten Parallelbetrieb mehrerer spezialisierter Agenten ausgelegt; seine Pods umfassen 1.152 Chips, gegenüber nur 256 beim Ironwood-Inferenzcluster, und der On-Chip-SRAM wurde auf 384 MB verdreifacht, was längere Kontextfenster begünstigt. Erstmals setzt Google beim Host-Prozessor vollständig auf seinen eigenen Axion-ARM-CPU, wobei eine CPU zwei TPUs bedient – beim Ironwood waren es noch vier TPUs pro x86-CPU. Google beansprucht außerdem eine „Goodpute"-Rate von 97 Prozent für den TPU 8t, was den Anteil tatsächlich nützlicher Rechenoperationen am Gesamtaufwand beschreibt. Beide Chips unterstützen gängige KI-Frameworks und sollen sowohl Googles eigene Gemini-Agenten als auch externe Entwickler auf Google Cloud bedienen.
- TPU 8t-Pods: 9.600 Chips, 2 Petabyte gemeinsamer HBM, 121 FP4 EFlops – knapp 3× so viel Training-Rechenleistung wie Ironwood.
- TPU 8i verdreifacht den On-Chip-SRAM auf 384 MB pro Chip, was größere Key-Value-Caches für lange Kontextfenster ermöglicht.
- Erstmals nutzt Google ausschließlich den eigenen Axion-ARM-CPU als Host: 1 CPU pro 2 TPUs (Ironwood: 1 x86-CPU pro 4 TPUs).
- Beide TPU-Generationen unterstützen JAX, MaxText, PyTorch, SGLang und vLLM; Leistung pro Watt soll doppelt so hoch sein wie bei Ironwood.
- Nvidias Aktie fiel nach der Ankündigung kurzzeitig um rund 1,5 Prozent, erholte sich jedoch schnell auf über 200 USD.
Frag die KI zum Artikel
Folgefragen zu Headline, Quelle und Volltext — Antwort streamt in wenigen Sekunden.
Verwandte Beiträge
Google präsentiert zwei neue TPUs für das Agentic-AI-Zeitalter
Mit der achten Generation seiner Tensor Processing Units vollzieht Google einen strategischen Schnitt: Statt einer einzigen verbesserten Chip-Variante gibt es erstmals zwei spezialisierte Designs – den TPU 8t für das Training von Frontier-Modellen und den TPU 8i für den Inferenz-Betrieb. Der TPU 8t ist in Pods mit je 9.600 Chips organisiert, die zusammen zwei Petabyte gemeinsamen Hochbandbreiten-Speicher bereitstellen und 121 FP4 EFlops Rechenleistung pro Pod liefern – fast dreimal so viel wie das Vorgängermodell Ironwood. Besonders hervorzuheben ist die lineare Skalierbarkeit: Google gibt an, bis zu einer Million Chips in einem einzigen logischen Cluster zusammenschalten zu können. Der TPU 8i hingegen ist auf den effizienten Parallelbetrieb mehrerer spezialisierter Agenten ausgelegt; seine Pods umfassen 1.152 Chips, gegenüber nur 256 beim Ironwood-Inferenzcluster, und der On-Chip-SRAM wurde auf 384 MB verdreifacht, was längere Kontextfenster begünstigt. Erstmals setzt Google beim Host-Prozessor vollständig auf seinen eigenen Axion-ARM-CPU, wobei eine CPU zwei TPUs bedient – beim Ironwood waren es noch vier TPUs pro x86-CPU. Google beansprucht außerdem eine „Goodpute"-Rate von 97 Prozent für den TPU 8t, was den Anteil tatsächlich nützlicher Rechenoperationen am Gesamtaufwand beschreibt. Beide Chips unterstützen gängige KI-Frameworks und sollen sowohl Googles eigene Gemini-Agenten als auch externe Entwickler auf Google Cloud bedienen.
- TPU 8t-Pods: 9.600 Chips, 2 Petabyte gemeinsamer HBM, 121 FP4 EFlops – knapp 3× so viel Training-Rechenleistung wie Ironwood.
- TPU 8i verdreifacht den On-Chip-SRAM auf 384 MB pro Chip, was größere Key-Value-Caches für lange Kontextfenster ermöglicht.
- Erstmals nutzt Google ausschließlich den eigenen Axion-ARM-CPU als Host: 1 CPU pro 2 TPUs (Ironwood: 1 x86-CPU pro 4 TPUs).
- Beide TPU-Generationen unterstützen JAX, MaxText, PyTorch, SGLang und vLLM; Leistung pro Watt soll doppelt so hoch sein wie bei Ironwood.
- Nvidias Aktie fiel nach der Ankündigung kurzzeitig um rund 1,5 Prozent, erholte sich jedoch schnell auf über 200 USD.
Frag die KI zum Artikel
Folgefragen zu Headline, Quelle und Volltext — Antwort streamt in wenigen Sekunden.