Warum lokale LLMs schlechter wirken als sie sind: Inferenz-Fallstricke erklärt
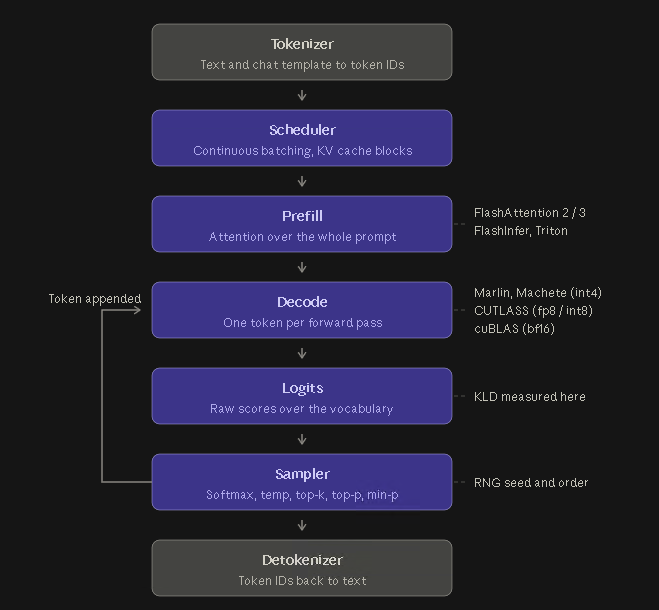
Der Level1Techs-Forenpost analysiert ein vielbeachtetes Problem in der lokalen LLM-Community: Modelle, die auf Referenzhardware mit der Originalimplementierung starke Benchmarks erzielen, können in der Praxis auf Consumer-Hardware deutlich schlechter wirken – ohne dass das Modell selbst schlechter geworden ist. Als zentrale Ursachen werden Hardware-bedingte Unterschiede im Rechenweg (z. B. abweichende Attention-Backends wie Flash Attention vs. naive Attention), unterschiedliche KV-Cache-Präzisionen sowie falsch gewählte Sampler-Einstellungen identifiziert. Quantisierung verschärft das Problem zusätzlich: Bereits kleine Abweichungen in der numerischen Darstellung akkumulieren sich über viele Schichten und führen zu messbarer KL-Divergenz gegenüber dem FP16-Referenzmodell. Die Autoren betonen, dass KLD-Angaben auf Modellkarten ohne Angabe der genauen Laufzeitumgebung, des Attention-Backends und der Sampler-Parameter kaum vergleichbar sind. Empfohlen wird, Sampler-Settings direkt aus der offiziellen Modellkarte zu übernehmen und KV-Cache-Präzision bewusst zu wählen, statt Standardwerte des Inference-Frameworks zu akzeptieren. Im Hintergrund steht auch der Beitrag des FreeToken-Projekts, das MoE-Serving auf Edge-Hardware neu denkt: Anstatt eine Consumer-Maschine als „kleines Datacenter-GPU" zu behandeln, wird sie als unified heterogenes System aus CPU, GPU und Arbeitsspeicher adressiert – was zusätzliche Variablen in die Inferenzpipeline einführt.
- KL-Divergenz (KLD) wird als Hauptmetrik genutzt, um Abweichungen vom FP16-Referenzmodell zu quantifizieren – aber nur im Kontext der vollständigen Laufzeitumgebung aussagekräftig.
- Attention-Backend-Wahl (z. B. Flash Attention vs. naive Attention) hat laut Post messbaren Einfluss auf die Token-Wahrscheinlichkeitsverteilung.
- KV-Cache-Präzision ist ein oft übersehener Parameter: niedrigere Präzision spart Speicher, erhöht aber systematisch die Divergenz vom Referenzoutput.
- FreeToken adressiert MoE-Serving auf Edge-Hardware durch bandwidth-adaptive Execution und behandelt die Maschine als unified System statt als skalierte Datacenter-GPU.
- Sampler-Settings aus Modellkarten (z. B. Temperature, Top-P, Min-P) werden explizit als kritische, häufig ignorierte Variable für reproduzierbare Ausgabequalität genannt.
Frag die KI zum Artikel
Folgefragen zu Headline, Quelle und Volltext — Antwort streamt in wenigen Sekunden.
Verwandte Beiträge
Warum lokale LLMs schlechter wirken als sie sind: Inferenz-Fallstricke erklärt
Der Level1Techs-Forenpost analysiert ein vielbeachtetes Problem in der lokalen LLM-Community: Modelle, die auf Referenzhardware mit der Originalimplementierung starke Benchmarks erzielen, können in der Praxis auf Consumer-Hardware deutlich schlechter wirken – ohne dass das Modell selbst schlechter geworden ist. Als zentrale Ursachen werden Hardware-bedingte Unterschiede im Rechenweg (z. B. abweichende Attention-Backends wie Flash Attention vs. naive Attention), unterschiedliche KV-Cache-Präzisionen sowie falsch gewählte Sampler-Einstellungen identifiziert. Quantisierung verschärft das Problem zusätzlich: Bereits kleine Abweichungen in der numerischen Darstellung akkumulieren sich über viele Schichten und führen zu messbarer KL-Divergenz gegenüber dem FP16-Referenzmodell. Die Autoren betonen, dass KLD-Angaben auf Modellkarten ohne Angabe der genauen Laufzeitumgebung, des Attention-Backends und der Sampler-Parameter kaum vergleichbar sind. Empfohlen wird, Sampler-Settings direkt aus der offiziellen Modellkarte zu übernehmen und KV-Cache-Präzision bewusst zu wählen, statt Standardwerte des Inference-Frameworks zu akzeptieren. Im Hintergrund steht auch der Beitrag des FreeToken-Projekts, das MoE-Serving auf Edge-Hardware neu denkt: Anstatt eine Consumer-Maschine als „kleines Datacenter-GPU" zu behandeln, wird sie als unified heterogenes System aus CPU, GPU und Arbeitsspeicher adressiert – was zusätzliche Variablen in die Inferenzpipeline einführt.
- KL-Divergenz (KLD) wird als Hauptmetrik genutzt, um Abweichungen vom FP16-Referenzmodell zu quantifizieren – aber nur im Kontext der vollständigen Laufzeitumgebung aussagekräftig.
- Attention-Backend-Wahl (z. B. Flash Attention vs. naive Attention) hat laut Post messbaren Einfluss auf die Token-Wahrscheinlichkeitsverteilung.
- KV-Cache-Präzision ist ein oft übersehener Parameter: niedrigere Präzision spart Speicher, erhöht aber systematisch die Divergenz vom Referenzoutput.
- FreeToken adressiert MoE-Serving auf Edge-Hardware durch bandwidth-adaptive Execution und behandelt die Maschine als unified System statt als skalierte Datacenter-GPU.
- Sampler-Settings aus Modellkarten (z. B. Temperature, Top-P, Min-P) werden explizit als kritische, häufig ignorierte Variable für reproduzierbare Ausgabequalität genannt.
Frag die KI zum Artikel
Folgefragen zu Headline, Quelle und Volltext — Antwort streamt in wenigen Sekunden.