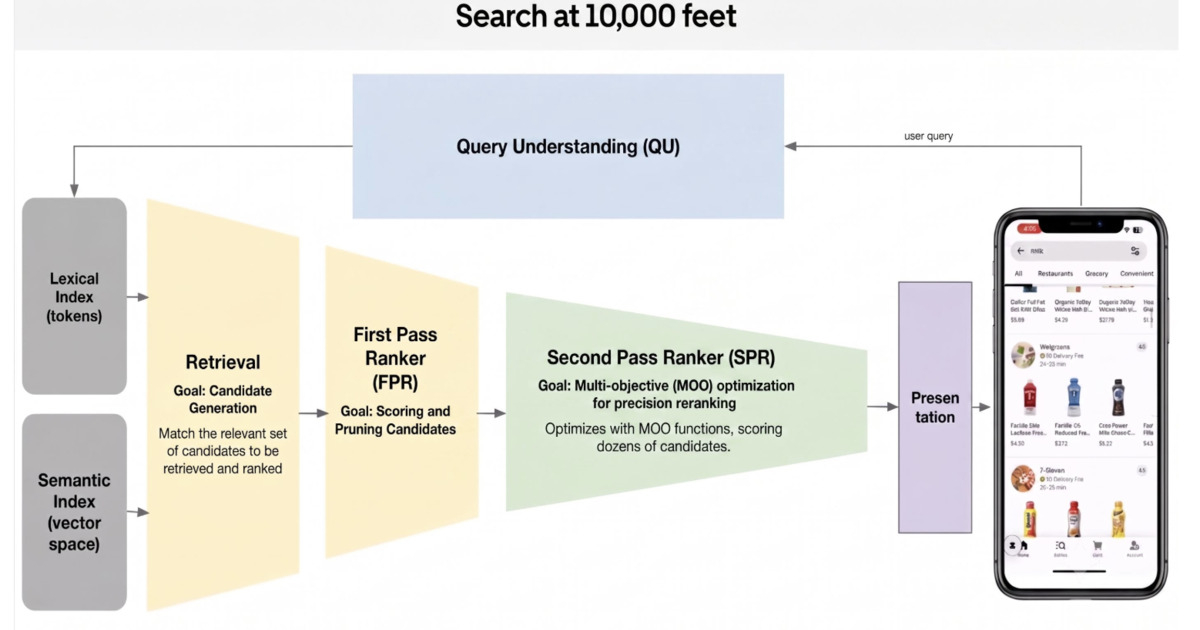
Uber Eats halbiert Suchlatenz durch Pipeline-Umbau
Frag die KI zum Artikel
Folgefragen zu Headline, Quelle und Volltext — Antwort streamt in wenigen Sekunden.
Verwandte Beiträge
- FORSCHUNGarxiv.org2w
MAPS: Memory-bewusstes Scheduling reduziert LLM-Latenz um bis zu 84,8 %
- FORSCHUNGhuggingface.co3w
OreoLook: Drei-Schicht-Caching für LLM-Websuche auf Standard-CPU-Hardware
- FORSCHUNGarxiv.org2w
FlashVector optimiert gesamten Model-Serving-Stack mit bis zu 2× Durchsatz
- FORSCHUNGarxiv.org3w
PACE: Framework senkt wahrgenommene Antwortlatenz in RAG-Dialogsystemen um Faktor 2,4