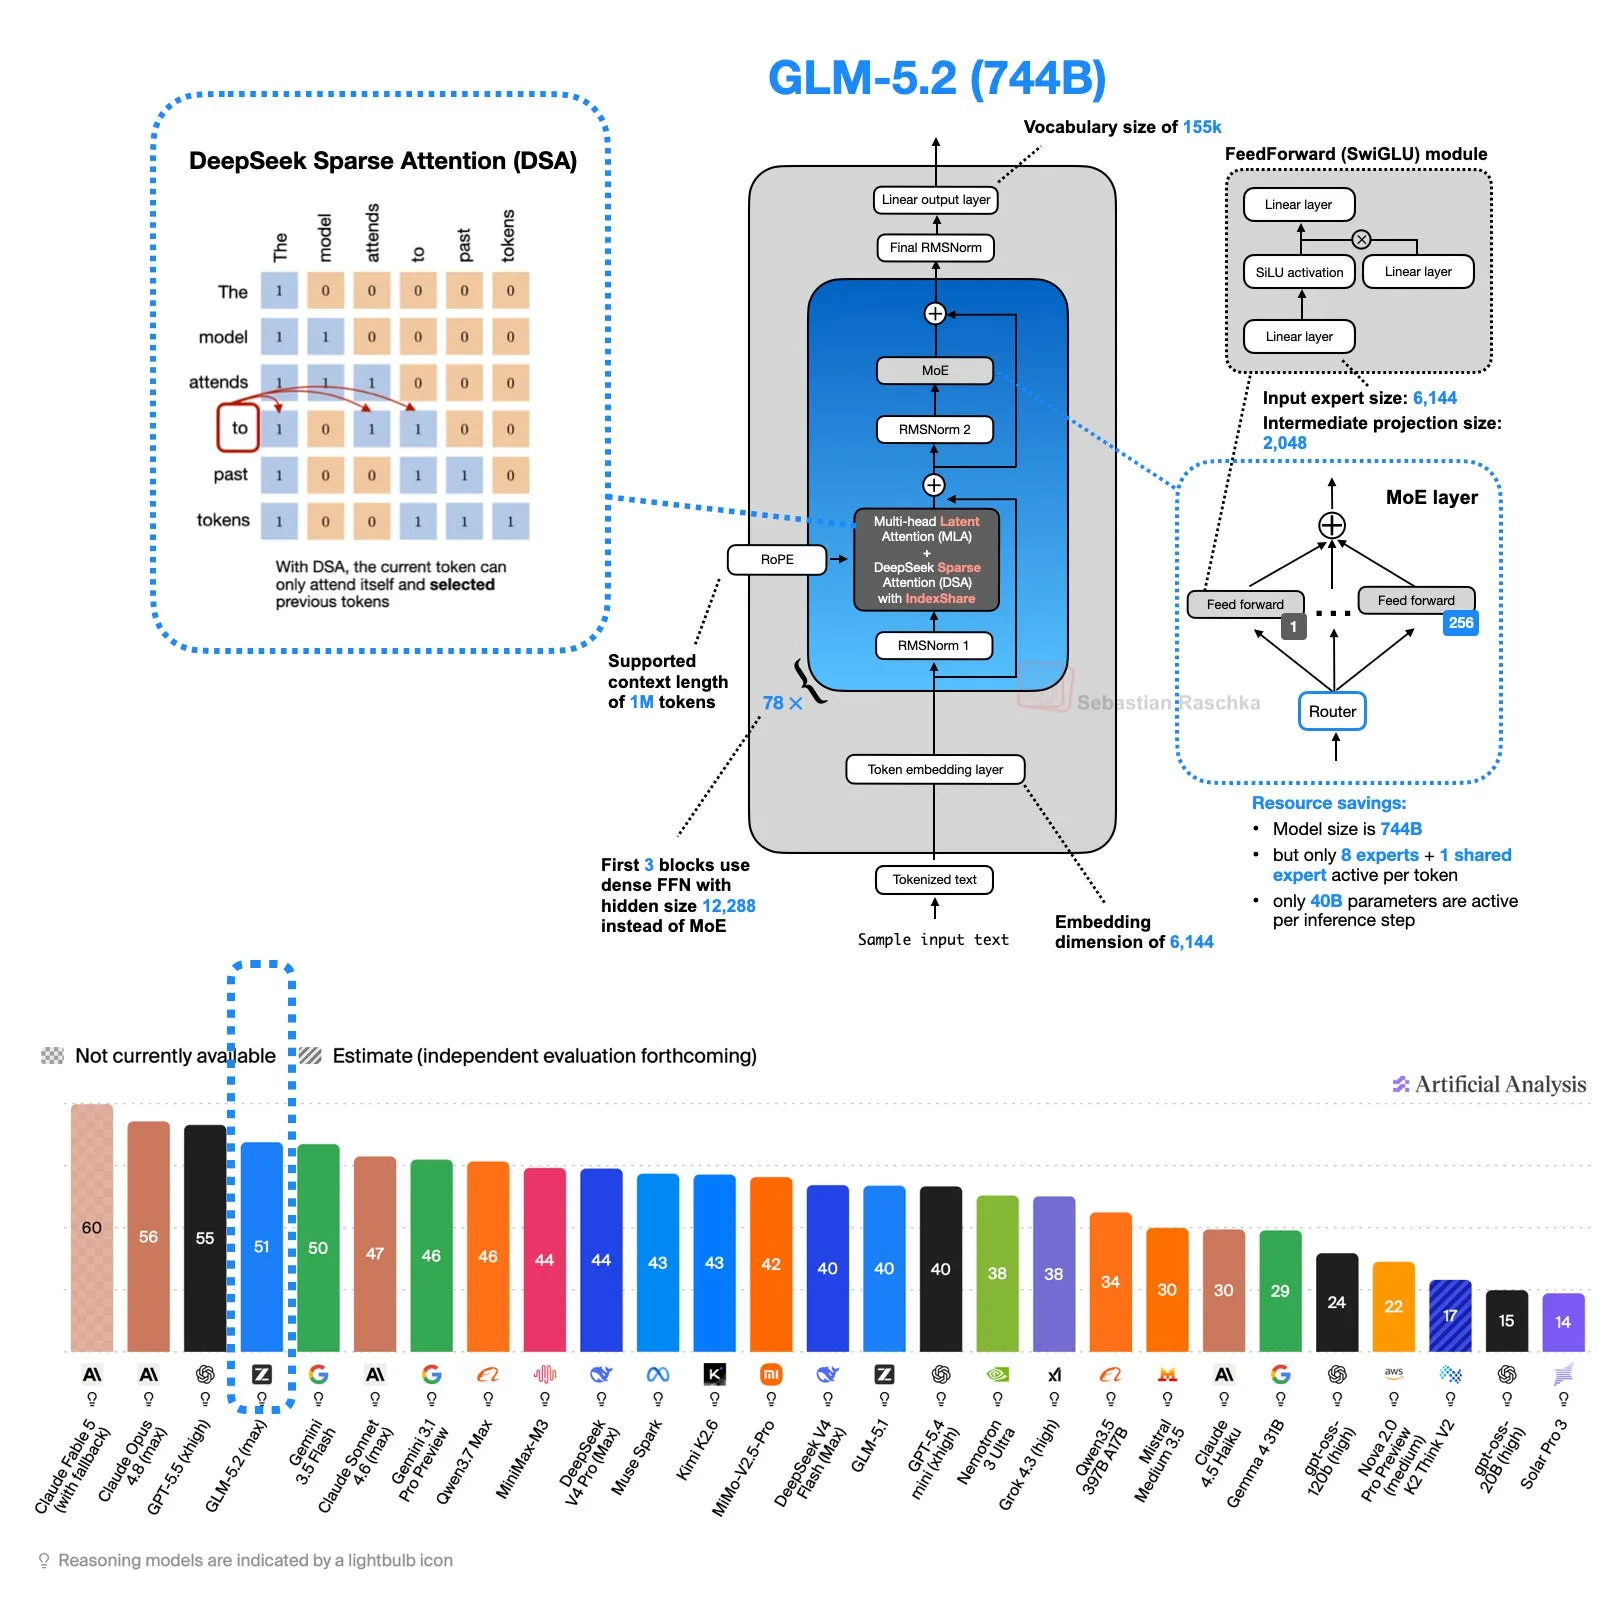
GLM-5.2 von Z.ai: IndexShare macht 1M-Token-Inferenz effizienter
ToolsDeepSeek
CompaniesDeepSeek
Warum es zählt
IndexShare reduziert den Rechenaufwand bei Sparse Attention für sehr lange Kontexte, indem Token-Indizes layerübergreifend wiederverwendet werden. Für Entwickler, die 1M-Token-Inferenz betreiben, senkt das direkt die Inferenzkosten ohne die adaptive Aufmerksamkeit grundlegend zu verändern.
— Lumeric Redaktion
Frag die KI zum Artikel
Folgefragen zu Headline, Quelle und Volltext — Antwort streamt in wenigen Sekunden.
Verwandte Beiträge
- FORSCHUNGarxiv.org1w
Prism Attention: 3,4× Decoding-Speedup bei 128K Kontextlänge
- FORSCHUNGarxiv.org1mo
SparseEngine: Sparse-First Inference Engine liefert 10× höheren Durchsatz
- FORSCHUNGarxiv.org3w
QUILT reduziert Sparse-Attention-Latenz um bis zu 55 % durch Query-Sharing
- FORSCHUNGarxiv.org3w
SAGA: Asymmetrische Sparse Attention für 2× schnelleres LLM-Decoding