Nathan Lambert veröffentlicht ATOM Report, RLHF-Buch und Post-Training-Kurs
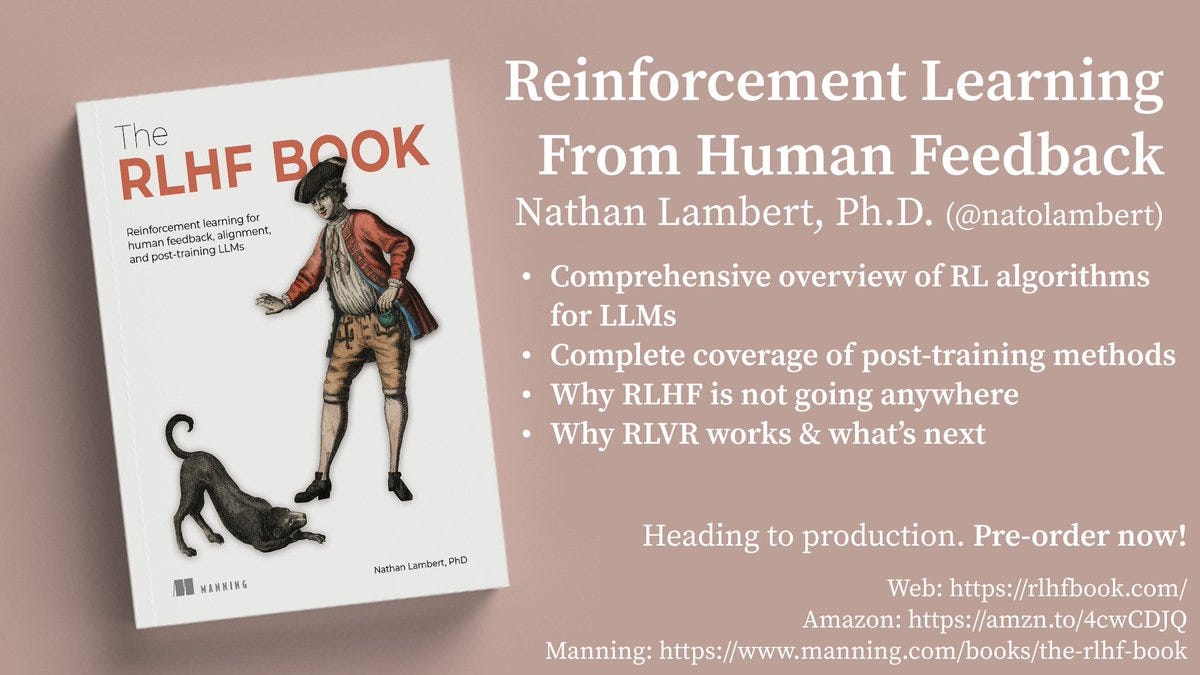
Der ATOM Report (arXiv: 2604.07190) wurde von Nathan Lambert und Florian als technischer Begleitbericht zum ATOM Project Memo veröffentlicht, das ursprünglich im August 2025 lanciert wurde und für mehr Investitionen in offene Modelle in den USA plädiert. Der Bericht analysiert das Open-LLM-Ökosystem umfassend: den Aufstieg von GPT-OSS, Marktanteile im Inference-Bereich sowie den Einfluss chinesischer Mittelfeld-Akteure wie Moonshot, Z.ai und MiniMax. Kernstück ist die aktualisierte Relative Adoption Metric (RAM), die Modell-Downloads größen- und zeitnormalisiert bewertet — ein RAM-Wert über 1 bedeutet, dass ein Modell auf Kurs liegt, zu den zehn meistgeladenen Modellen seiner Größenklasse aller Zeiten zu gehören. Besonders hervorgehoben wird die frühe Adoptionskurve von Gemma 4, die laut Lambert bemerkenswert stark ausfällt. Das RLHF-Buch (rlhfbook.com) wurde am 20. Mai 2024 ernsthaft begonnen und ist inzwischen zur Produktion beim Verlag Manning eingereicht; es soll in etwa zwei Monaten ab dem Veröffentlichungsdatum (April 2026) gedruckt vorliegen und ist bereits auf Amazon und Manning vorbestellbar. Ergänzend entsteht ein kostenloser YouTube-Kurs mit mindestens vier veröffentlichten Vorlesungen, der die Buchinhalte von RLHF-Grundlagen über Reward Modeling bis hin zur Implementierung von RL-Algorithmen für LLMs abdeckt. Zwei aktuelle Forschungspapiere, an denen Lambert mitgewirkt hat, behandeln Multi-Turn-Fähigkeiten von Sprachmodellen (TurnWise, Graf et al. 2026) sowie Meta-Reinforcement Learning mit Self-Reflection für agentisches Suchen (Xiao et al. 2026).
- RAM-Score: Wert >1 signalisiert, dass ein Modell auf Kurs für die Top-10 der meistgeladenen Modelle seiner Größenklasse ist — reduziert ein komplexes Ökosystem auf eine einzige Kennzahl.
- RLHF-Buch-Domain rlhfbook.com wurde am 20. Mai 2024 registriert; inhaltliche Lektoratsphase ist abgeschlossen, Drucklegung durch Manning ca. 2 Monate nach April 2026.
- YouTube-Kurs umfasst bisher 4 Vorlesungen: Überblick Post-Training, RLHF-Grundlagen/IFT/Reward Modeling/Rejection Sampling, Policy-Gradient-Algorithmen, RL-Implementierung für LLMs.
- TurnWise-Paper (arXiv 2603.16759, Graf et al. 2026) untersucht die Lücke zwischen Ein- und Mehr-Runden-Fähigkeiten von Sprachmodellen sowie Trainingsdaten-Erstellung zur Verbesserung.
- Meta-RL-Paper (arXiv 2603.11327, Xiao et al. 2026) rahmt RLVR als Meta-Learning-Problem, bei dem Kontext aus früheren Versuchen zukünftige Rollouts informiert — verwandt mit kontinuierlichem Lernen.
Frag die KI zum Artikel
Folgefragen zu Headline, Quelle und Volltext — Antwort streamt in wenigen Sekunden.
Verwandte Beiträge
Nathan Lambert veröffentlicht ATOM Report, RLHF-Buch und Post-Training-Kurs
Der ATOM Report (arXiv: 2604.07190) wurde von Nathan Lambert und Florian als technischer Begleitbericht zum ATOM Project Memo veröffentlicht, das ursprünglich im August 2025 lanciert wurde und für mehr Investitionen in offene Modelle in den USA plädiert. Der Bericht analysiert das Open-LLM-Ökosystem umfassend: den Aufstieg von GPT-OSS, Marktanteile im Inference-Bereich sowie den Einfluss chinesischer Mittelfeld-Akteure wie Moonshot, Z.ai und MiniMax. Kernstück ist die aktualisierte Relative Adoption Metric (RAM), die Modell-Downloads größen- und zeitnormalisiert bewertet — ein RAM-Wert über 1 bedeutet, dass ein Modell auf Kurs liegt, zu den zehn meistgeladenen Modellen seiner Größenklasse aller Zeiten zu gehören. Besonders hervorgehoben wird die frühe Adoptionskurve von Gemma 4, die laut Lambert bemerkenswert stark ausfällt. Das RLHF-Buch (rlhfbook.com) wurde am 20. Mai 2024 ernsthaft begonnen und ist inzwischen zur Produktion beim Verlag Manning eingereicht; es soll in etwa zwei Monaten ab dem Veröffentlichungsdatum (April 2026) gedruckt vorliegen und ist bereits auf Amazon und Manning vorbestellbar. Ergänzend entsteht ein kostenloser YouTube-Kurs mit mindestens vier veröffentlichten Vorlesungen, der die Buchinhalte von RLHF-Grundlagen über Reward Modeling bis hin zur Implementierung von RL-Algorithmen für LLMs abdeckt. Zwei aktuelle Forschungspapiere, an denen Lambert mitgewirkt hat, behandeln Multi-Turn-Fähigkeiten von Sprachmodellen (TurnWise, Graf et al. 2026) sowie Meta-Reinforcement Learning mit Self-Reflection für agentisches Suchen (Xiao et al. 2026).
- RAM-Score: Wert >1 signalisiert, dass ein Modell auf Kurs für die Top-10 der meistgeladenen Modelle seiner Größenklasse ist — reduziert ein komplexes Ökosystem auf eine einzige Kennzahl.
- RLHF-Buch-Domain rlhfbook.com wurde am 20. Mai 2024 registriert; inhaltliche Lektoratsphase ist abgeschlossen, Drucklegung durch Manning ca. 2 Monate nach April 2026.
- YouTube-Kurs umfasst bisher 4 Vorlesungen: Überblick Post-Training, RLHF-Grundlagen/IFT/Reward Modeling/Rejection Sampling, Policy-Gradient-Algorithmen, RL-Implementierung für LLMs.
- TurnWise-Paper (arXiv 2603.16759, Graf et al. 2026) untersucht die Lücke zwischen Ein- und Mehr-Runden-Fähigkeiten von Sprachmodellen sowie Trainingsdaten-Erstellung zur Verbesserung.
- Meta-RL-Paper (arXiv 2603.11327, Xiao et al. 2026) rahmt RLVR als Meta-Learning-Problem, bei dem Kontext aus früheren Versuchen zukünftige Rollouts informiert — verwandt mit kontinuierlichem Lernen.
Frag die KI zum Artikel
Folgefragen zu Headline, Quelle und Volltext — Antwort streamt in wenigen Sekunden.