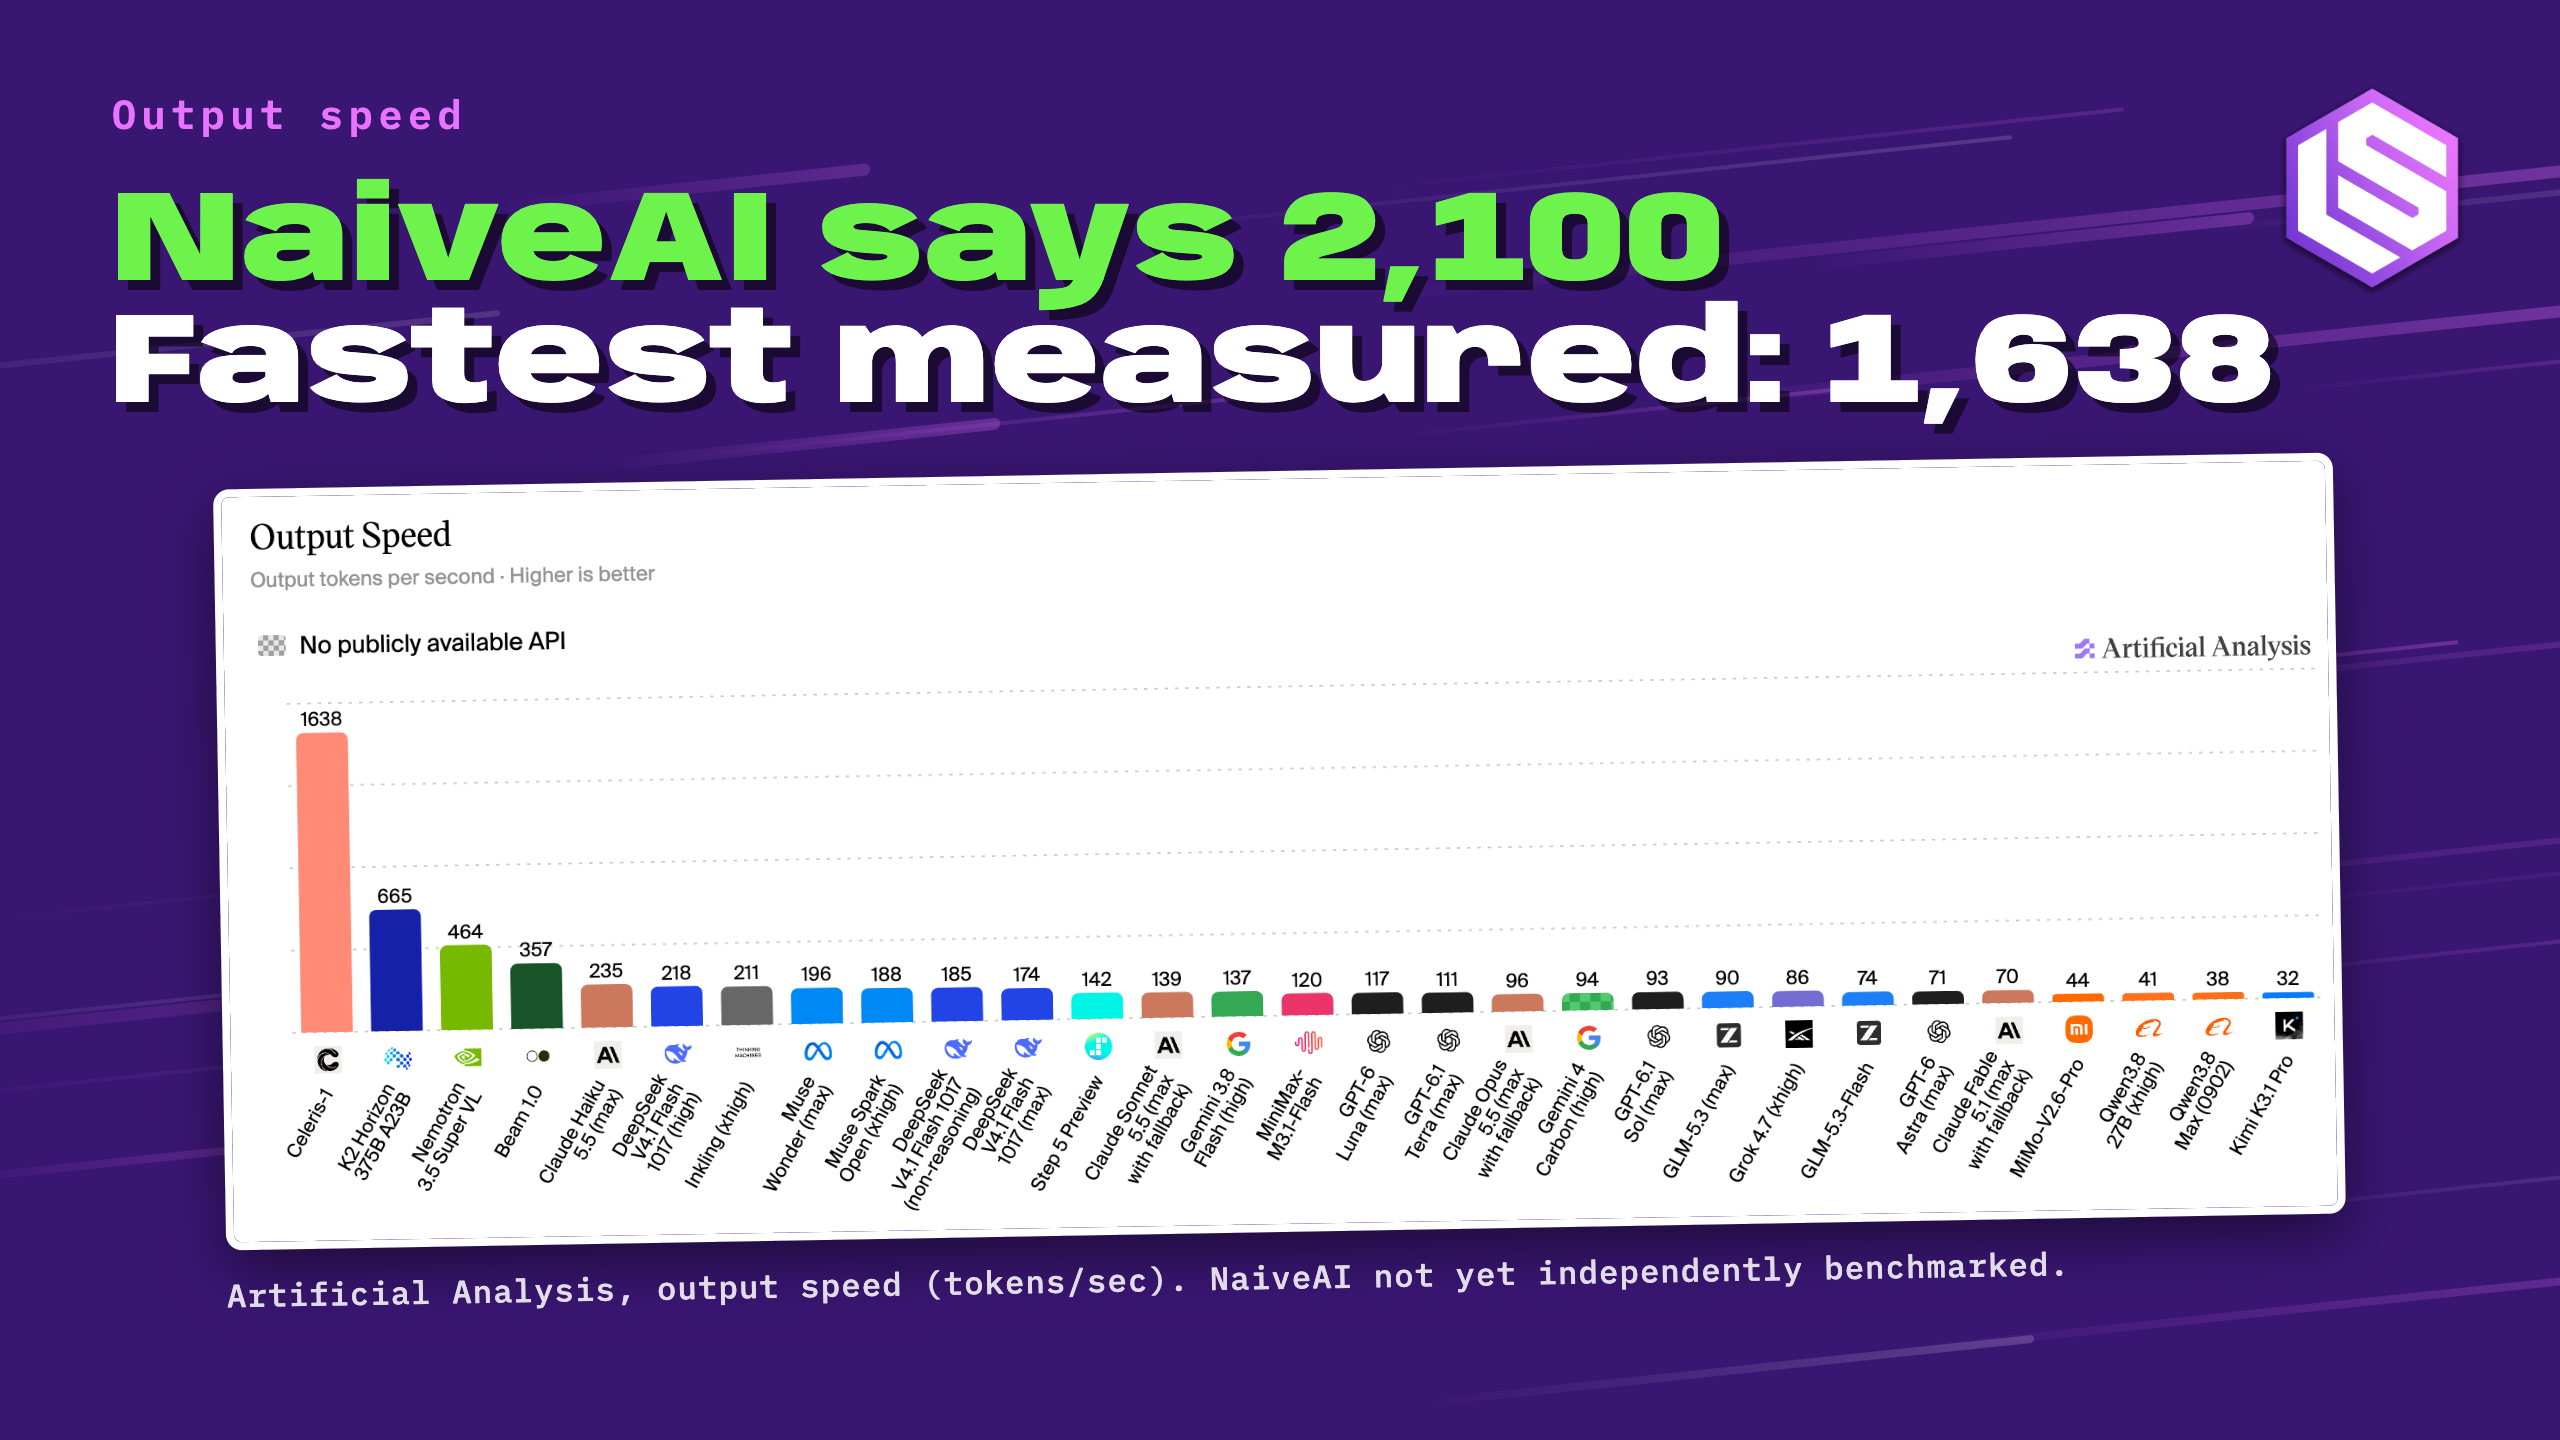
NaiveAI Naive-N0.5-Flash: 310B-MoE-Modell mit über 1.000 Token/Sekunde
CompaniesDeepSeek
Warum es zählt
Für Coding-Workflows relevant: Der Median der Antwortzeit liegt bei 3,1 s (vs. 5,3 s GLM, 10,1 s DeepSeek), allerdings erzeugt das Modell bei schweren Aufgaben extrem lange Reasoning-Traces (Ø 108.500 Tokens). Throughput-Zahlen sind nicht direkt vergleichbar, da unterschiedliche Messquellen genutzt wurden.
— Lumeric Redaktion
NL2Repo-Bench · Spitzenwert
56.3%
GLM-5.3-Flash
Frag die KI zum Artikel
Folgefragen zu Headline, Quelle und Volltext — Antwort streamt in wenigen Sekunden.
Verwandte Beiträge
NaiveAI Naive-N0.5-Flash: 310B-MoE-Modell mit über 1.000 Token/Sekunde
CompaniesDeepSeek
Warum es zählt
Für Coding-Workflows relevant: Der Median der Antwortzeit liegt bei 3,1 s (vs. 5,3 s GLM, 10,1 s DeepSeek), allerdings erzeugt das Modell bei schweren Aufgaben extrem lange Reasoning-Traces (Ø 108.500 Tokens). Throughput-Zahlen sind nicht direkt vergleichbar, da unterschiedliche Messquellen genutzt wurden.
— Lumeric Redaktion
NL2Repo-Bench · Spitzenwert
56.3%
GLM-5.3-Flash
Frag die KI zum Artikel
Folgefragen zu Headline, Quelle und Volltext — Antwort streamt in wenigen Sekunden.