Qwen3.6-27B: Flagship-Coding-Leistung in 27B Dense Model
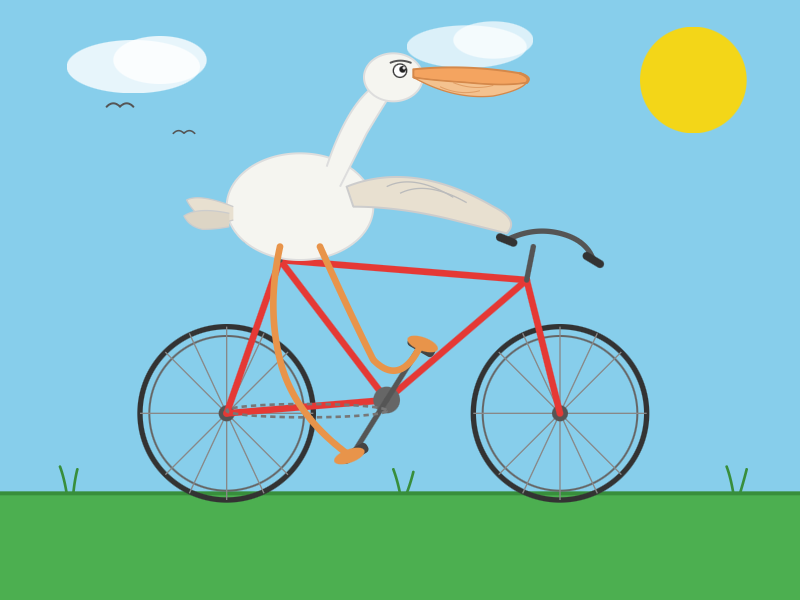
Qwen3.6-27B ist ein Dense-Modell (alle 27 Milliarden Parameter aktiv), das Alibabas Qwen-Team als direkten Nachfolger des bisherigen Open-Source-Flaggschiffs Qwen3.5-397B-A17B positioniert – einem Mixture-of-Experts-Modell mit 397 Milliarden Gesamtparametern, von denen 17 Milliarden pro Inferenzschritt aktiv sind. Laut Alibaba übertrifft Qwen3.6-27B diesen Vorgänger auf allen wichtigen Coding-Benchmarks, obwohl es dramatisch kleiner ist: Qwen3.5-397B-A17B belegt auf Hugging Face rund 807 GB, während Qwen3.6-27B nur 55,6 GB groß ist. Simon Willison testete das Modell lokal mit der Q4_K_M-Quantisierung von Unsloth, die lediglich 16,8 GB beansprucht, und betrieb es über llama-server, installiert per `brew install llama.cpp`. Der Inferenz-Befehl nutzte ein 65.536-Token-Kontextfenster, Thinking-Mode sowie spezifische Sampling-Parameter (Temperatur 0,6, Top-P 0,95, Top-K 20). Als qualitativen Test ließ Willison das Modell ein SVG eines Pelikans auf einem Fahrrad generieren und bezeichnete das Ergebnis als „outstanding" für ein 16,8-GB-Lokalmodell. Die gemessene Generierungsgeschwindigkeit lag bei rund 25,57 Tokens pro Sekunde; ein zweiter Test mit einem Opossum auf einem E-Scooter produzierte 6.575 Tokens in gut vier Minuten. Der Vergleich mit dem früheren GLM-5.1-Ergebnis unterstreicht, dass Qwen3.6-27B in der gleichen Leistungsklasse lokal laufender Modelle konkurrenzfähig ist.
- Quantisierte Variante Unsloth Qwen3.6-27B-GGUF:Q4_K_M wiegt nur 16,8 GB und wird beim ersten Start automatisch nach ~/.cache/huggingface/hub/ geladen.
- llama-server-Befehl von Hacker-News-User benob nutzt u.a. --reasoning on und preserve_thinking:true für sichtbare Chain-of-Thought-Ausgabe.
- Pelikan-SVG-Test: 4.444 Tokens generiert in 2 min 53 s bei 25,57 t/s; Lese-Phase: 20 Tokens in 0,4 s (54,32 t/s).
- Vorgänger Qwen3.5-397B-A17B (MoE) ist auf Hugging Face 807 GB groß – fast 15-mal größer als das neue Dense-Modell (55,6 GB).
- Willison startete llama-server per 'brew install llama.cpp' – kein Python-Setup nötig, Einstiegshürde für Mac-Nutzer besonders niedrig.
Frag die KI zum Artikel
Folgefragen zu Headline, Quelle und Volltext — Antwort streamt in wenigen Sekunden.
Verwandte Beiträge
Qwen3.6-27B: Flagship-Coding-Leistung in 27B Dense Model
Qwen3.6-27B ist ein Dense-Modell (alle 27 Milliarden Parameter aktiv), das Alibabas Qwen-Team als direkten Nachfolger des bisherigen Open-Source-Flaggschiffs Qwen3.5-397B-A17B positioniert – einem Mixture-of-Experts-Modell mit 397 Milliarden Gesamtparametern, von denen 17 Milliarden pro Inferenzschritt aktiv sind. Laut Alibaba übertrifft Qwen3.6-27B diesen Vorgänger auf allen wichtigen Coding-Benchmarks, obwohl es dramatisch kleiner ist: Qwen3.5-397B-A17B belegt auf Hugging Face rund 807 GB, während Qwen3.6-27B nur 55,6 GB groß ist. Simon Willison testete das Modell lokal mit der Q4_K_M-Quantisierung von Unsloth, die lediglich 16,8 GB beansprucht, und betrieb es über llama-server, installiert per `brew install llama.cpp`. Der Inferenz-Befehl nutzte ein 65.536-Token-Kontextfenster, Thinking-Mode sowie spezifische Sampling-Parameter (Temperatur 0,6, Top-P 0,95, Top-K 20). Als qualitativen Test ließ Willison das Modell ein SVG eines Pelikans auf einem Fahrrad generieren und bezeichnete das Ergebnis als „outstanding" für ein 16,8-GB-Lokalmodell. Die gemessene Generierungsgeschwindigkeit lag bei rund 25,57 Tokens pro Sekunde; ein zweiter Test mit einem Opossum auf einem E-Scooter produzierte 6.575 Tokens in gut vier Minuten. Der Vergleich mit dem früheren GLM-5.1-Ergebnis unterstreicht, dass Qwen3.6-27B in der gleichen Leistungsklasse lokal laufender Modelle konkurrenzfähig ist.
- Quantisierte Variante Unsloth Qwen3.6-27B-GGUF:Q4_K_M wiegt nur 16,8 GB und wird beim ersten Start automatisch nach ~/.cache/huggingface/hub/ geladen.
- llama-server-Befehl von Hacker-News-User benob nutzt u.a. --reasoning on und preserve_thinking:true für sichtbare Chain-of-Thought-Ausgabe.
- Pelikan-SVG-Test: 4.444 Tokens generiert in 2 min 53 s bei 25,57 t/s; Lese-Phase: 20 Tokens in 0,4 s (54,32 t/s).
- Vorgänger Qwen3.5-397B-A17B (MoE) ist auf Hugging Face 807 GB groß – fast 15-mal größer als das neue Dense-Modell (55,6 GB).
- Willison startete llama-server per 'brew install llama.cpp' – kein Python-Setup nötig, Einstiegshürde für Mac-Nutzer besonders niedrig.
Frag die KI zum Artikel
Folgefragen zu Headline, Quelle und Volltext — Antwort streamt in wenigen Sekunden.