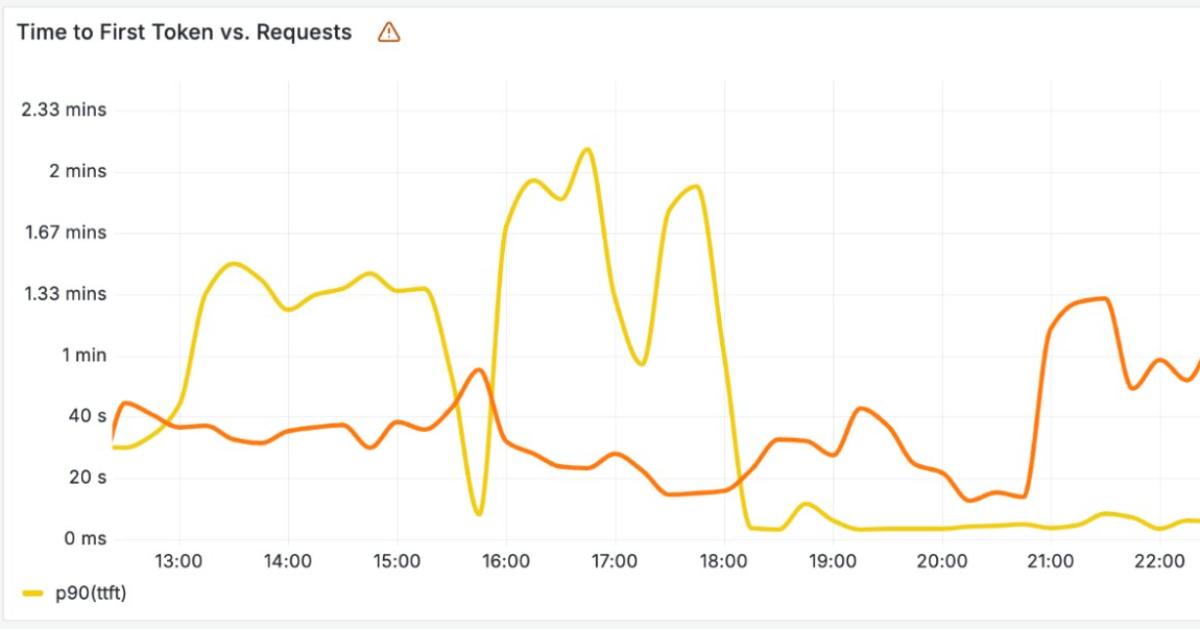
Cloudflare baut spezialisierte Infrastruktur für LLM-Inferenz
Cloudflare hat eine spezialisierte Infrastruktur für LLM-Inferenz entwickelt, die auf einer funktionalen Trennung zwischen Input-Verarbeitung (Prefill) und Output-Generierung (Decode) basiert. Dieses als „Disaggregated Inference" bekannte Architekturprinzip erlaubt es, unterschiedliche Hardware gezielt für die jeweilige Aufgabe einzusetzen: Prefill-Phasen sind rechenintensiv und profitieren von hoher Parallelisierung, während Decode-Phasen speicherintensiv sind und andere Optimierungen erfordern. Cloudflare verteilt diese Workloads über sein globales Netzwerk, das aus Hunderten von Rechenzentren in über 100 Ländern besteht, um Nutzeranfragen möglichst nah am Endnutzer zu verarbeiten. Die Initiative steht im Kontext von Cloudflares Workers AI-Plattform, über die Entwickler KI-Modelle ohne eigenes GPU-Management deployen können. Der Ansatz zielt darauf ab, die typischen Kostentreiber bei LLM-Inferenz – insbesondere teure GPU-Ressourcen – effizienter auszulasten, indem idle Kapazitäten im Netzwerk genutzt werden. Für Entwickler bedeutet das potenziell niedrigere Latenzzeiten und günstigere Preise im Vergleich zu zentralisierten Cloud-Anbietern. Der Artikel wurde von Renato Losio für InfoQ verfasst und im Mai 2026 veröffentlicht.
- Cloudflare trennt Prefill (Input-Verarbeitung) und Decode (Output-Generierung) auf separate, jeweils optimierte Hardwaresysteme.
- Die Infrastruktur nutzt Cloudflares globales Netzwerk mit Rechenzentren in über 100 Ländern für georedundante LLM-Inferenz.
- Grundlage ist die bestehende Workers AI-Plattform, über die Entwickler Modelle ohne eigenes GPU-Management betreiben können.
- Das Disaggregated-Inference-Modell soll idle GPU-Kapazitäten im Netzwerk besser auslasten und damit die Betriebskosten senken.
Frag die KI zum Artikel
Folgefragen zu Headline, Quelle und Volltext — Antwort streamt in wenigen Sekunden.
Verwandte Beiträge
- FORSCHUNGarxiv.org3w
LLM-basiertes Scheduling senkt Energieverbrauch in Rechenzentren um 32 %
- FORSCHUNGarxiv.org3w
Verteilte LLM-Inferenz über Intel AI PC Flotten via Pipeline-Parallelismus
- FORSCHUNGarxiv.org17h
LLM-Inferenz auf Flash-Speicher: 15× weniger KV-Cache-Traffic
- FORSCHUNGarxiv.org17h
FlexEE: Early-Exiting-Framework liefert bis zu 3,16× Speed-up für LLM-Inferenz
Cloudflare baut spezialisierte Infrastruktur für LLM-Inferenz
Cloudflare hat eine spezialisierte Infrastruktur für LLM-Inferenz entwickelt, die auf einer funktionalen Trennung zwischen Input-Verarbeitung (Prefill) und Output-Generierung (Decode) basiert. Dieses als „Disaggregated Inference" bekannte Architekturprinzip erlaubt es, unterschiedliche Hardware gezielt für die jeweilige Aufgabe einzusetzen: Prefill-Phasen sind rechenintensiv und profitieren von hoher Parallelisierung, während Decode-Phasen speicherintensiv sind und andere Optimierungen erfordern. Cloudflare verteilt diese Workloads über sein globales Netzwerk, das aus Hunderten von Rechenzentren in über 100 Ländern besteht, um Nutzeranfragen möglichst nah am Endnutzer zu verarbeiten. Die Initiative steht im Kontext von Cloudflares Workers AI-Plattform, über die Entwickler KI-Modelle ohne eigenes GPU-Management deployen können. Der Ansatz zielt darauf ab, die typischen Kostentreiber bei LLM-Inferenz – insbesondere teure GPU-Ressourcen – effizienter auszulasten, indem idle Kapazitäten im Netzwerk genutzt werden. Für Entwickler bedeutet das potenziell niedrigere Latenzzeiten und günstigere Preise im Vergleich zu zentralisierten Cloud-Anbietern. Der Artikel wurde von Renato Losio für InfoQ verfasst und im Mai 2026 veröffentlicht.
- Cloudflare trennt Prefill (Input-Verarbeitung) und Decode (Output-Generierung) auf separate, jeweils optimierte Hardwaresysteme.
- Die Infrastruktur nutzt Cloudflares globales Netzwerk mit Rechenzentren in über 100 Ländern für georedundante LLM-Inferenz.
- Grundlage ist die bestehende Workers AI-Plattform, über die Entwickler Modelle ohne eigenes GPU-Management betreiben können.
- Das Disaggregated-Inference-Modell soll idle GPU-Kapazitäten im Netzwerk besser auslasten und damit die Betriebskosten senken.
Frag die KI zum Artikel
Folgefragen zu Headline, Quelle und Volltext — Antwort streamt in wenigen Sekunden.
Verwandte Beiträge
- FORSCHUNGarxiv.org3w
LLM-basiertes Scheduling senkt Energieverbrauch in Rechenzentren um 32 %
- FORSCHUNGarxiv.org3w
Verteilte LLM-Inferenz über Intel AI PC Flotten via Pipeline-Parallelismus
- FORSCHUNGarxiv.org17h
LLM-Inferenz auf Flash-Speicher: 15× weniger KV-Cache-Traffic
- FORSCHUNGarxiv.org17h
FlexEE: Early-Exiting-Framework liefert bis zu 3,16× Speed-up für LLM-Inferenz