Simon Willison portiert LiteParse von LlamaIndex als Browser-Tool für PDF-Extraktion
LiteParse ist ein Open-Source-Projekt von LlamaIndex, das ursprünglich als Node.js-CLI-Tool zum Extrahieren von Text aus PDFs konzipiert wurde. Es verzichtet bewusst auf KI-Modelle und setzt stattdessen auf regelbasiertes „Spatial Text Parsing": Clevere Heuristiken erkennen Mehrspalten-Layouts und rekonstruieren einen sinnvollen linearen Textfluss – eine der kniffligsten Herausforderungen beim PDF-Parsen. Simon Willison portierte das Tool in eine reine Browser-App, die unter https://simonw.github.io/liteparse/ erreichbar ist und vollständig clientseitig läuft. Technische Basis sind PDF.js für die Renderlogik und Tesseract.js für den OCR-Fallback bei bild-basierten PDFs – beides Bibliotheken, die Willison bereits früher im Browser eingesetzt hatte. Den Entwicklungsprozess steuerte er überwiegend mit Claude Code und dem Modell Opus 4.7: Er begann die Erkundung in der regulären Claude-App auf dem iPhone, wechselte dann zum Laptop und ließ Claude Code weitgehend autonom arbeiten, während er zwischendurch andere Projekte verfolgte und Duolingo nutzte. Besonders betont Willison das Muster „Visual Citations with Bounding Boxes" aus der LiteParse-Dokumentation: Antworten aus RAG-Pipelines lassen sich dabei mit ausgeschnittenen, hervorgehobenen PDF-Seitenbildern belegen, was die Nachvollziehbarkeit erhöht. Die Entwicklung folgte einem Red/Green-TDD-Ansatz mit Playwright, und ein Safari-spezifischer Bug beim Lesen von ReadableStreams musste gesondert behoben werden.
- LiteParse wird als globales npm-Paket installiert: `npm i -g @llamaindex/liteparse`, Aufruf via `lit parse document.pdf`.
- Willison startete die Erkundung mit einem PDF-Upload in der Claude-iPhone-App und einem direkten GitHub-Clone-Prompt — ohne lokalen Laptop.
- Die Implementierungsplanung lief über eine plan.md-Datei im Repo; Willison iterierte die Planung explizit, bevor er Claude Code mit 'build it' losschickte.
- Ein Safari-Bug ('undefined is not a function near readableStream') wurde entdeckt, weil Playwright-Tests in Chrome liefen, der Fehler aber nur in Safari auftrat.
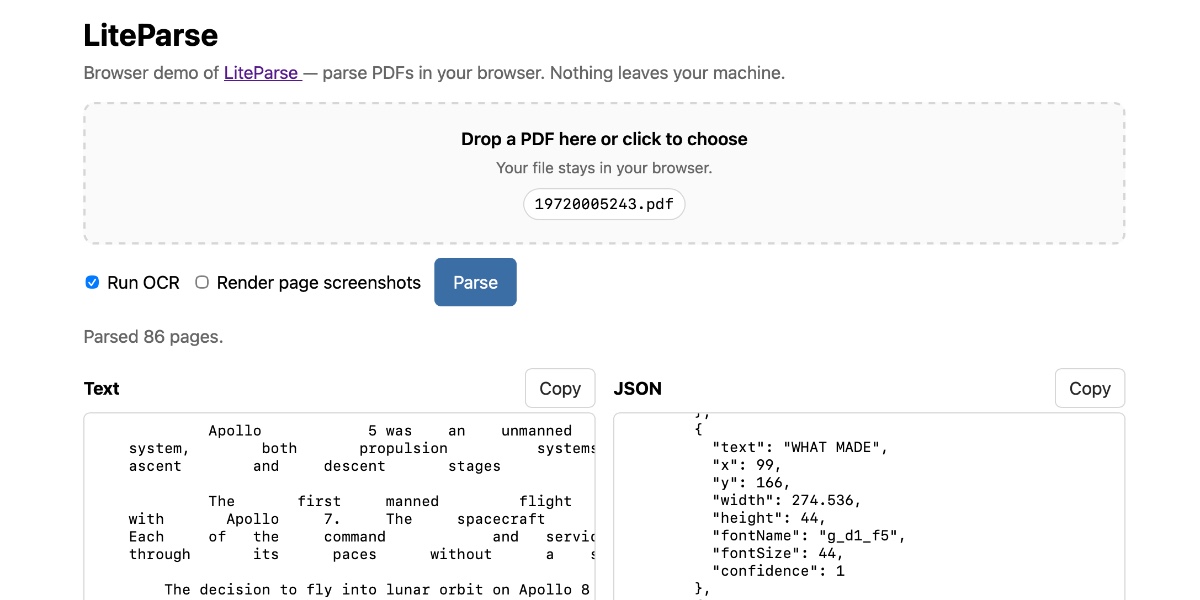
- Die fertige Web-App zeigt sowohl formatierten Text als auch Pretty-Printed-JSON-Output in separaten Textareas, jeweils mit Copy-to-Clipboard-Button, und ist mobilfreundlich.
Frag die KI zum Artikel
Folgefragen zu Headline, Quelle und Volltext — Antwort streamt in wenigen Sekunden.
Verwandte Beiträge
Simon Willison portiert LiteParse von LlamaIndex als Browser-Tool für PDF-Extraktion
LiteParse ist ein Open-Source-Projekt von LlamaIndex, das ursprünglich als Node.js-CLI-Tool zum Extrahieren von Text aus PDFs konzipiert wurde. Es verzichtet bewusst auf KI-Modelle und setzt stattdessen auf regelbasiertes „Spatial Text Parsing": Clevere Heuristiken erkennen Mehrspalten-Layouts und rekonstruieren einen sinnvollen linearen Textfluss – eine der kniffligsten Herausforderungen beim PDF-Parsen. Simon Willison portierte das Tool in eine reine Browser-App, die unter https://simonw.github.io/liteparse/ erreichbar ist und vollständig clientseitig läuft. Technische Basis sind PDF.js für die Renderlogik und Tesseract.js für den OCR-Fallback bei bild-basierten PDFs – beides Bibliotheken, die Willison bereits früher im Browser eingesetzt hatte. Den Entwicklungsprozess steuerte er überwiegend mit Claude Code und dem Modell Opus 4.7: Er begann die Erkundung in der regulären Claude-App auf dem iPhone, wechselte dann zum Laptop und ließ Claude Code weitgehend autonom arbeiten, während er zwischendurch andere Projekte verfolgte und Duolingo nutzte. Besonders betont Willison das Muster „Visual Citations with Bounding Boxes" aus der LiteParse-Dokumentation: Antworten aus RAG-Pipelines lassen sich dabei mit ausgeschnittenen, hervorgehobenen PDF-Seitenbildern belegen, was die Nachvollziehbarkeit erhöht. Die Entwicklung folgte einem Red/Green-TDD-Ansatz mit Playwright, und ein Safari-spezifischer Bug beim Lesen von ReadableStreams musste gesondert behoben werden.
- LiteParse wird als globales npm-Paket installiert: `npm i -g @llamaindex/liteparse`, Aufruf via `lit parse document.pdf`.
- Willison startete die Erkundung mit einem PDF-Upload in der Claude-iPhone-App und einem direkten GitHub-Clone-Prompt — ohne lokalen Laptop.
- Die Implementierungsplanung lief über eine plan.md-Datei im Repo; Willison iterierte die Planung explizit, bevor er Claude Code mit 'build it' losschickte.
- Ein Safari-Bug ('undefined is not a function near readableStream') wurde entdeckt, weil Playwright-Tests in Chrome liefen, der Fehler aber nur in Safari auftrat.
- Die fertige Web-App zeigt sowohl formatierten Text als auch Pretty-Printed-JSON-Output in separaten Textareas, jeweils mit Copy-to-Clipboard-Button, und ist mobilfreundlich.
Frag die KI zum Artikel
Folgefragen zu Headline, Quelle und Volltext — Antwort streamt in wenigen Sekunden.