Microsoft VibeVoice: Whisper-Alternative mit Speaker-Diarization, MIT-lizenziert
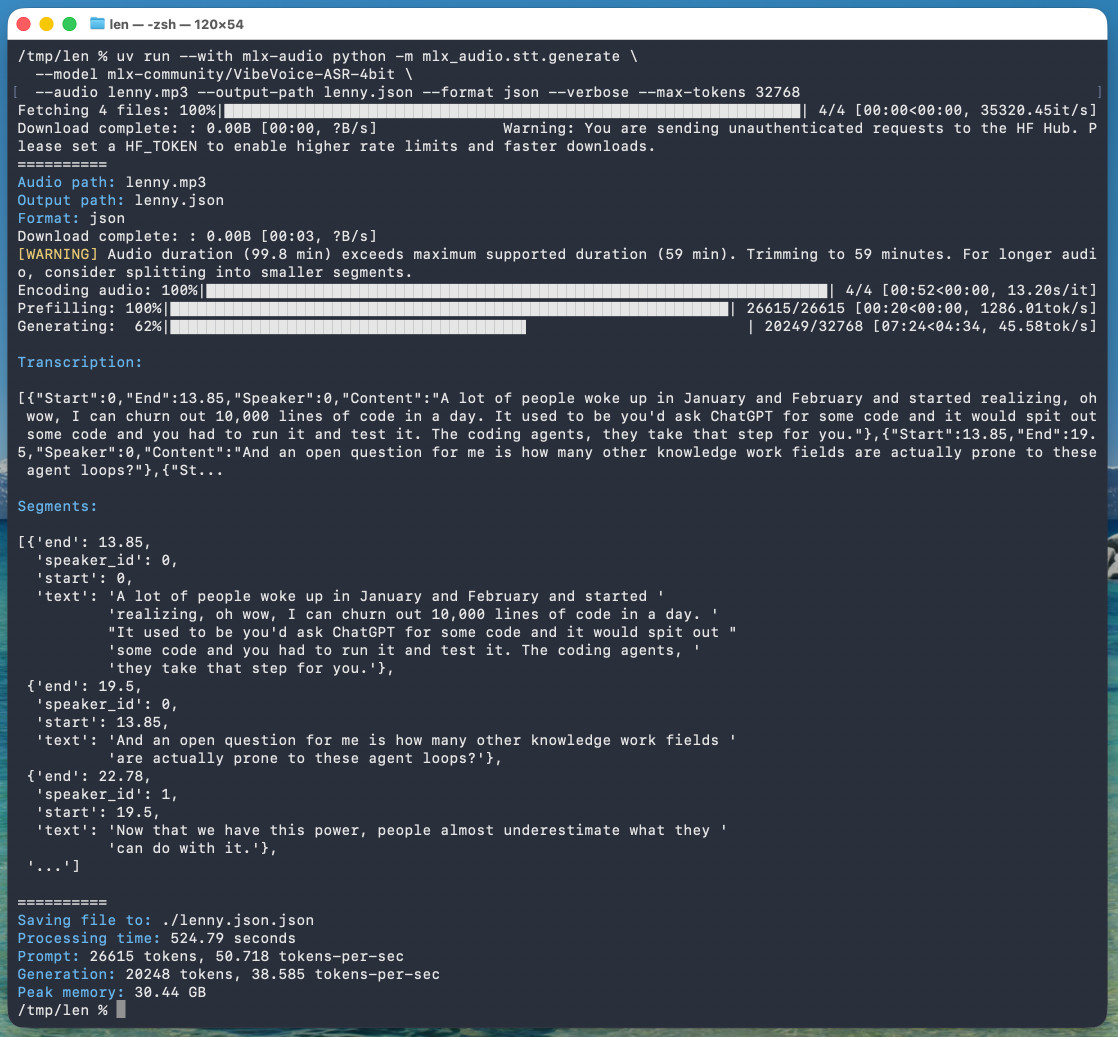
Microsoft veröffentlichte VibeVoice am 21. Januar 2026, doch Simon Willison testete das Modell erst im April. VibeVoice ist ein Whisper-artiges Speech-to-Text-Modell, das Speaker-Diarization direkt im Modell integriert – ohne nachgelagerte Klassifikationsschritte. Die 4-Bit-quantisierte MLX-Variante (mlx-community/VibeVoice-ASR-4bit) belegt 5,71 GB, während das Ausgangsmodell VibeVoice-ASR 17,3 GB groß ist; die Konvertierung stammt von Prince Canuma über das mlx-audio-Projekt. Willison transkribierte seinen Podcast-Auftritt bei Lenny Rachitsky: Bei einer Stunde Audio betrug die Verarbeitungszeit 524,79 Sekunden (rund 8:45 Min.) auf einem M5-Max-MacBook-Pro mit 128 GB RAM. Der RAM-Verbrauch war zweiphasig: Während des Prefill-Schritts maß Activity Monitor 61,5 GB, in der Generierungsphase nur noch ~18 GB – das Modell selbst meldete 30,44 GB Peak. Das Ausgabe-JSON enthält pro Segment Text, Start/End-Zeitstempel, Dauer und eine speaker_id; Willison öffnete das Array direkt in Datasette Lite zur komfortablen Durchsicht. Dabei erkannte das Modell drei Speaker: Lenny Rachitsky, Willison selbst – und Lenny ein zweites Mal für die Intro- und Sponsor-Lesung in verändertem Tonfall.
- Standardwert für --max-tokens ist 8192, was für ca. 25 Minuten Audio reicht; Willison setzte ihn auf 32768, um eine volle Stunde zu erfassen.
- Promptverarbeitung: 26.615 Tokens à 50,7 tok/s; Generierung: 20.248 Tokens à 38,6 tok/s.
- Das Modell unterstützt .wav und .mp3 als Eingabeformate; andere Formate wurden im Test nicht erwähnt.
- Für Audio über eine Stunde muss die Datei manuell gesplittet werden – empfohlen mit ~1 Minute Überlappung, um Wortfehler an Schnittstellen zu vermeiden.
- Die 4-Bit-MLX-Konvertierung wurde von Prince Canuma unter dem mlx-audio-Projekt bereitgestellt und liegt auf der mlx-community auf Hugging Face.
Frag die KI zum Artikel
Folgefragen zu Headline, Quelle und Volltext — Antwort streamt in wenigen Sekunden.
Verwandte Beiträge
Microsoft VibeVoice: Whisper-Alternative mit Speaker-Diarization, MIT-lizenziert
Microsoft veröffentlichte VibeVoice am 21. Januar 2026, doch Simon Willison testete das Modell erst im April. VibeVoice ist ein Whisper-artiges Speech-to-Text-Modell, das Speaker-Diarization direkt im Modell integriert – ohne nachgelagerte Klassifikationsschritte. Die 4-Bit-quantisierte MLX-Variante (mlx-community/VibeVoice-ASR-4bit) belegt 5,71 GB, während das Ausgangsmodell VibeVoice-ASR 17,3 GB groß ist; die Konvertierung stammt von Prince Canuma über das mlx-audio-Projekt. Willison transkribierte seinen Podcast-Auftritt bei Lenny Rachitsky: Bei einer Stunde Audio betrug die Verarbeitungszeit 524,79 Sekunden (rund 8:45 Min.) auf einem M5-Max-MacBook-Pro mit 128 GB RAM. Der RAM-Verbrauch war zweiphasig: Während des Prefill-Schritts maß Activity Monitor 61,5 GB, in der Generierungsphase nur noch ~18 GB – das Modell selbst meldete 30,44 GB Peak. Das Ausgabe-JSON enthält pro Segment Text, Start/End-Zeitstempel, Dauer und eine speaker_id; Willison öffnete das Array direkt in Datasette Lite zur komfortablen Durchsicht. Dabei erkannte das Modell drei Speaker: Lenny Rachitsky, Willison selbst – und Lenny ein zweites Mal für die Intro- und Sponsor-Lesung in verändertem Tonfall.
- Standardwert für --max-tokens ist 8192, was für ca. 25 Minuten Audio reicht; Willison setzte ihn auf 32768, um eine volle Stunde zu erfassen.
- Promptverarbeitung: 26.615 Tokens à 50,7 tok/s; Generierung: 20.248 Tokens à 38,6 tok/s.
- Das Modell unterstützt .wav und .mp3 als Eingabeformate; andere Formate wurden im Test nicht erwähnt.
- Für Audio über eine Stunde muss die Datei manuell gesplittet werden – empfohlen mit ~1 Minute Überlappung, um Wortfehler an Schnittstellen zu vermeiden.
- Die 4-Bit-MLX-Konvertierung wurde von Prince Canuma unter dem mlx-audio-Projekt bereitgestellt und liegt auf der mlx-community auf Hugging Face.
Frag die KI zum Artikel
Folgefragen zu Headline, Quelle und Volltext — Antwort streamt in wenigen Sekunden.