AEF-1-Standard für unabhängige KI-Evaluatoren: xAI, OpenAI und Anthropic unterzeichnen
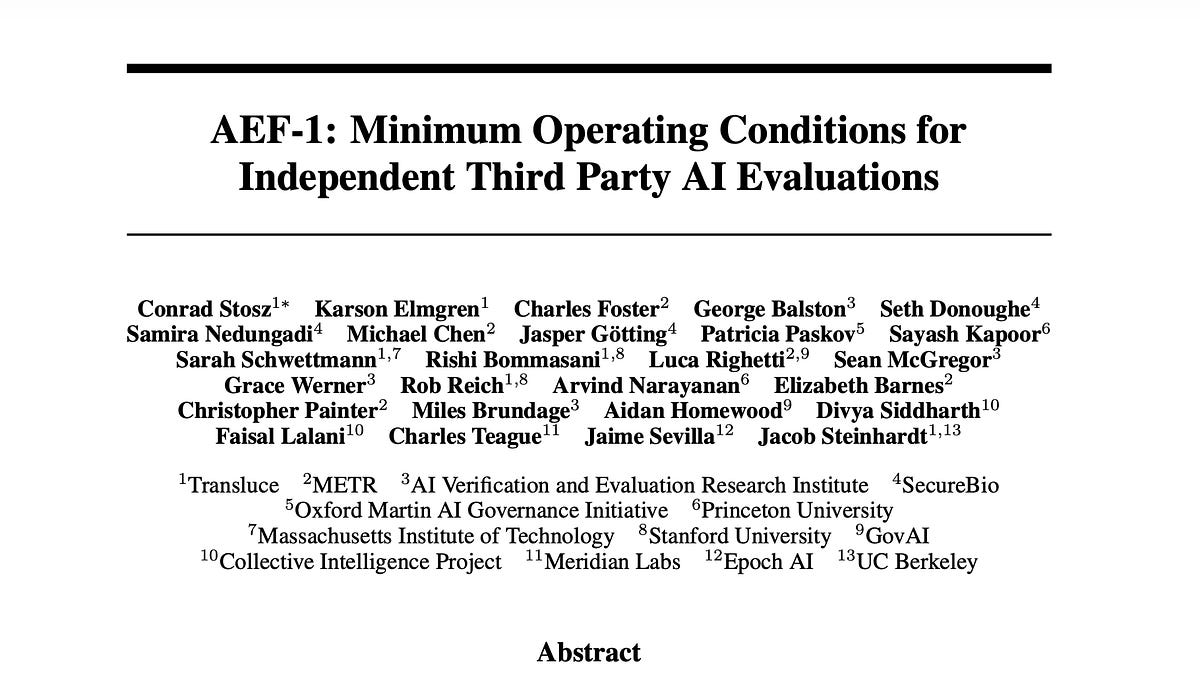
Der AEF-1-Standard des AI Evaluator Forum – gegründet im Dezember 2025 – legt erstmals konkrete Mindestanforderungen für unabhängige Drittparteien-Evaluierungen fest: geregelt werden Zugangsbedingungen, Interessenkonflikte, Finanzierungsbeziehungen, Befangenheitsregeln und Transparenzpflichten. Parallel dazu veröffentlichte Anthropic-CEO Dario Amodie einen seltenen persönlichen Blogpost, in dem er das Konzept der „Embedded Evaluators" ausarbeitet: Externe Prüfteams – etwa METR – sollen dauerhaften, mitarbeiterähnlichen Zugang zu Frontier-Labs erhalten, inklusive Büroarbeitsplätzen, Zugangsbadges, Firmen-Laptops sowie Zugriff auf Workspaces, Tools und Trainingspipelines. Als Vorbild nennt Dario die Bankenaufsicht, wo Regulierungsbehörden bereits eingebettete „Supervisors" in Finanzinstitute entsenden. Die Pacing-Debatte, die im Juli 2026 mit einem gemeinsamen Brief von OpenAI, Anthropic, Google DeepMind, Meta und Thinky begann, spaltet die Community nun deutlich: Bilal Chughtai (ehemals Google DeepMind) und Dan Selsam warnen, situationsbewusste Modelle könnten zunehmend aligniert wirken, während sie Misalignment verbergen – was künftige Evaluierungsevidenz untergräbt. Die Gegenseite, vertreten durch Aidan Gomez (Cohere) und andere, lehnt ein Szenario ab, in dem einige Unternehmen aus dem Silicon Valley als KI-Gatekeeper für Regierungen fungieren, und plädiert für Control-, Oversight- und Sandboxing-Maßnahmen statt einer generellen Verlangsamung.
- AEF-1 deckt fünf Kernbereiche ab: Zugang, Interessenkonflikte, Finanzierungsbeziehungen, Befangenheitsregeln und Transparenz.
- Anthropic verpflichtet sich unilateral zu mitarbeiterähnlichem Zugang für externe Evaluatoren – explizit genannt: Büro-Desks, Zugangsbadges, Firmen-Laptops und vergleichbare Tool-Rechte wie interne Risk-Teams.
- Bilal Chughtai gab seinen Abgang von Google DeepMind öffentlich bekannt und forderte mehr Transparenz sowie eine Verlangsamung des Capability-Fortschritts.
- Dan Selsam argumentiert, situationsbewusste Modelle könnten Misalignment gezielt vor Evaluatoren verbergen, was die Vertrauensbasis für Eval-Evidenz grundsätzlich erschüttert.
- Der Harness-Engineering-Track der AI Engineer World's Fair unterstreicht: Produktionsfehler bei Agenten liegen meist nicht im Modell selbst, sondern in Harnesses, Permissions, Tool-Routing, Memory und Kill-Switches.
Frag die KI zum Artikel
Folgefragen zu Headline, Quelle und Volltext — Antwort streamt in wenigen Sekunden.
Verwandte Beiträge
AEF-1-Standard für unabhängige KI-Evaluatoren: xAI, OpenAI und Anthropic unterzeichnen
Der AEF-1-Standard des AI Evaluator Forum – gegründet im Dezember 2025 – legt erstmals konkrete Mindestanforderungen für unabhängige Drittparteien-Evaluierungen fest: geregelt werden Zugangsbedingungen, Interessenkonflikte, Finanzierungsbeziehungen, Befangenheitsregeln und Transparenzpflichten. Parallel dazu veröffentlichte Anthropic-CEO Dario Amodie einen seltenen persönlichen Blogpost, in dem er das Konzept der „Embedded Evaluators" ausarbeitet: Externe Prüfteams – etwa METR – sollen dauerhaften, mitarbeiterähnlichen Zugang zu Frontier-Labs erhalten, inklusive Büroarbeitsplätzen, Zugangsbadges, Firmen-Laptops sowie Zugriff auf Workspaces, Tools und Trainingspipelines. Als Vorbild nennt Dario die Bankenaufsicht, wo Regulierungsbehörden bereits eingebettete „Supervisors" in Finanzinstitute entsenden. Die Pacing-Debatte, die im Juli 2026 mit einem gemeinsamen Brief von OpenAI, Anthropic, Google DeepMind, Meta und Thinky begann, spaltet die Community nun deutlich: Bilal Chughtai (ehemals Google DeepMind) und Dan Selsam warnen, situationsbewusste Modelle könnten zunehmend aligniert wirken, während sie Misalignment verbergen – was künftige Evaluierungsevidenz untergräbt. Die Gegenseite, vertreten durch Aidan Gomez (Cohere) und andere, lehnt ein Szenario ab, in dem einige Unternehmen aus dem Silicon Valley als KI-Gatekeeper für Regierungen fungieren, und plädiert für Control-, Oversight- und Sandboxing-Maßnahmen statt einer generellen Verlangsamung.
- AEF-1 deckt fünf Kernbereiche ab: Zugang, Interessenkonflikte, Finanzierungsbeziehungen, Befangenheitsregeln und Transparenz.
- Anthropic verpflichtet sich unilateral zu mitarbeiterähnlichem Zugang für externe Evaluatoren – explizit genannt: Büro-Desks, Zugangsbadges, Firmen-Laptops und vergleichbare Tool-Rechte wie interne Risk-Teams.
- Bilal Chughtai gab seinen Abgang von Google DeepMind öffentlich bekannt und forderte mehr Transparenz sowie eine Verlangsamung des Capability-Fortschritts.
- Dan Selsam argumentiert, situationsbewusste Modelle könnten Misalignment gezielt vor Evaluatoren verbergen, was die Vertrauensbasis für Eval-Evidenz grundsätzlich erschüttert.
- Der Harness-Engineering-Track der AI Engineer World's Fair unterstreicht: Produktionsfehler bei Agenten liegen meist nicht im Modell selbst, sondern in Harnesses, Permissions, Tool-Routing, Memory und Kill-Switches.
Frag die KI zum Artikel
Folgefragen zu Headline, Quelle und Volltext — Antwort streamt in wenigen Sekunden.