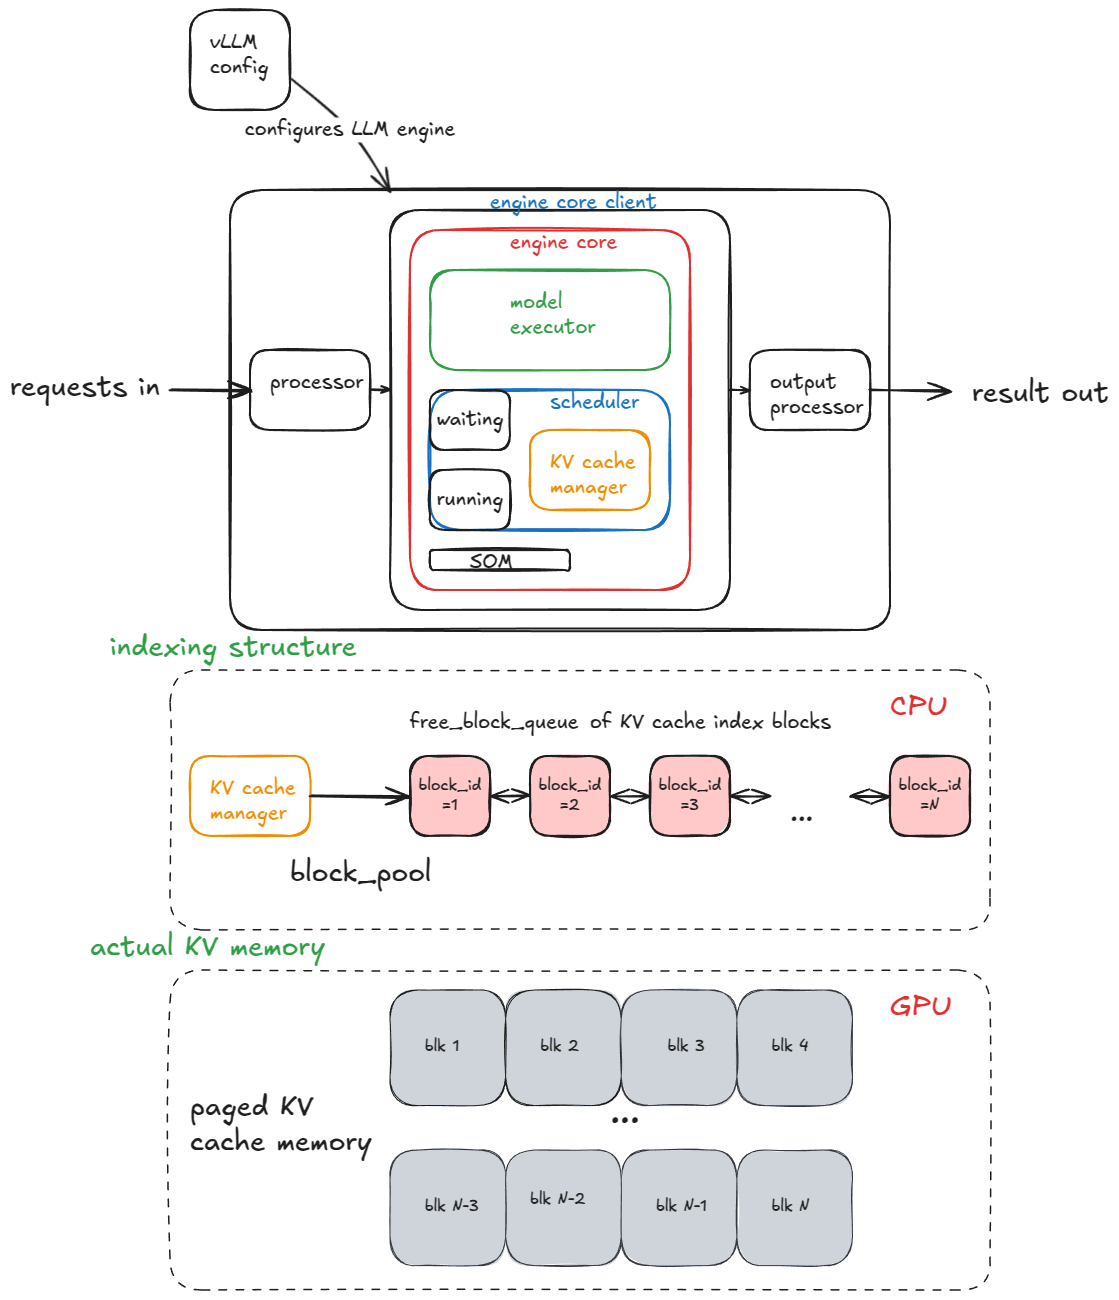
vLLM-Internals: Technischer Deep-Dive in High-Throughput LLM-Inferenz
Frag die KI zum Artikel
Folgefragen zu Headline, Quelle und Volltext — Antwort streamt in wenigen Sekunden.
Verwandte Beiträge
- FORSCHUNGarxiv.org3d
Systematischer Review: LLM-Serving in der Cloud – Architektur, Orchestrierung, Inferenz
- MEINUNGreddit.com3w
Community-Diskussion: Einstieg in vLLM für lokale Inferenz
- FORSCHUNGarxiv.org2w
Framework zur optimalen Parallelisierung von LLM-Inferenz unter SLO-Anforderungen
- FORSCHUNGarxiv.org1w
Lokale LLM-Inferenz auf langen Kontexten: GPU-Ressourcen stark unterausgelastet