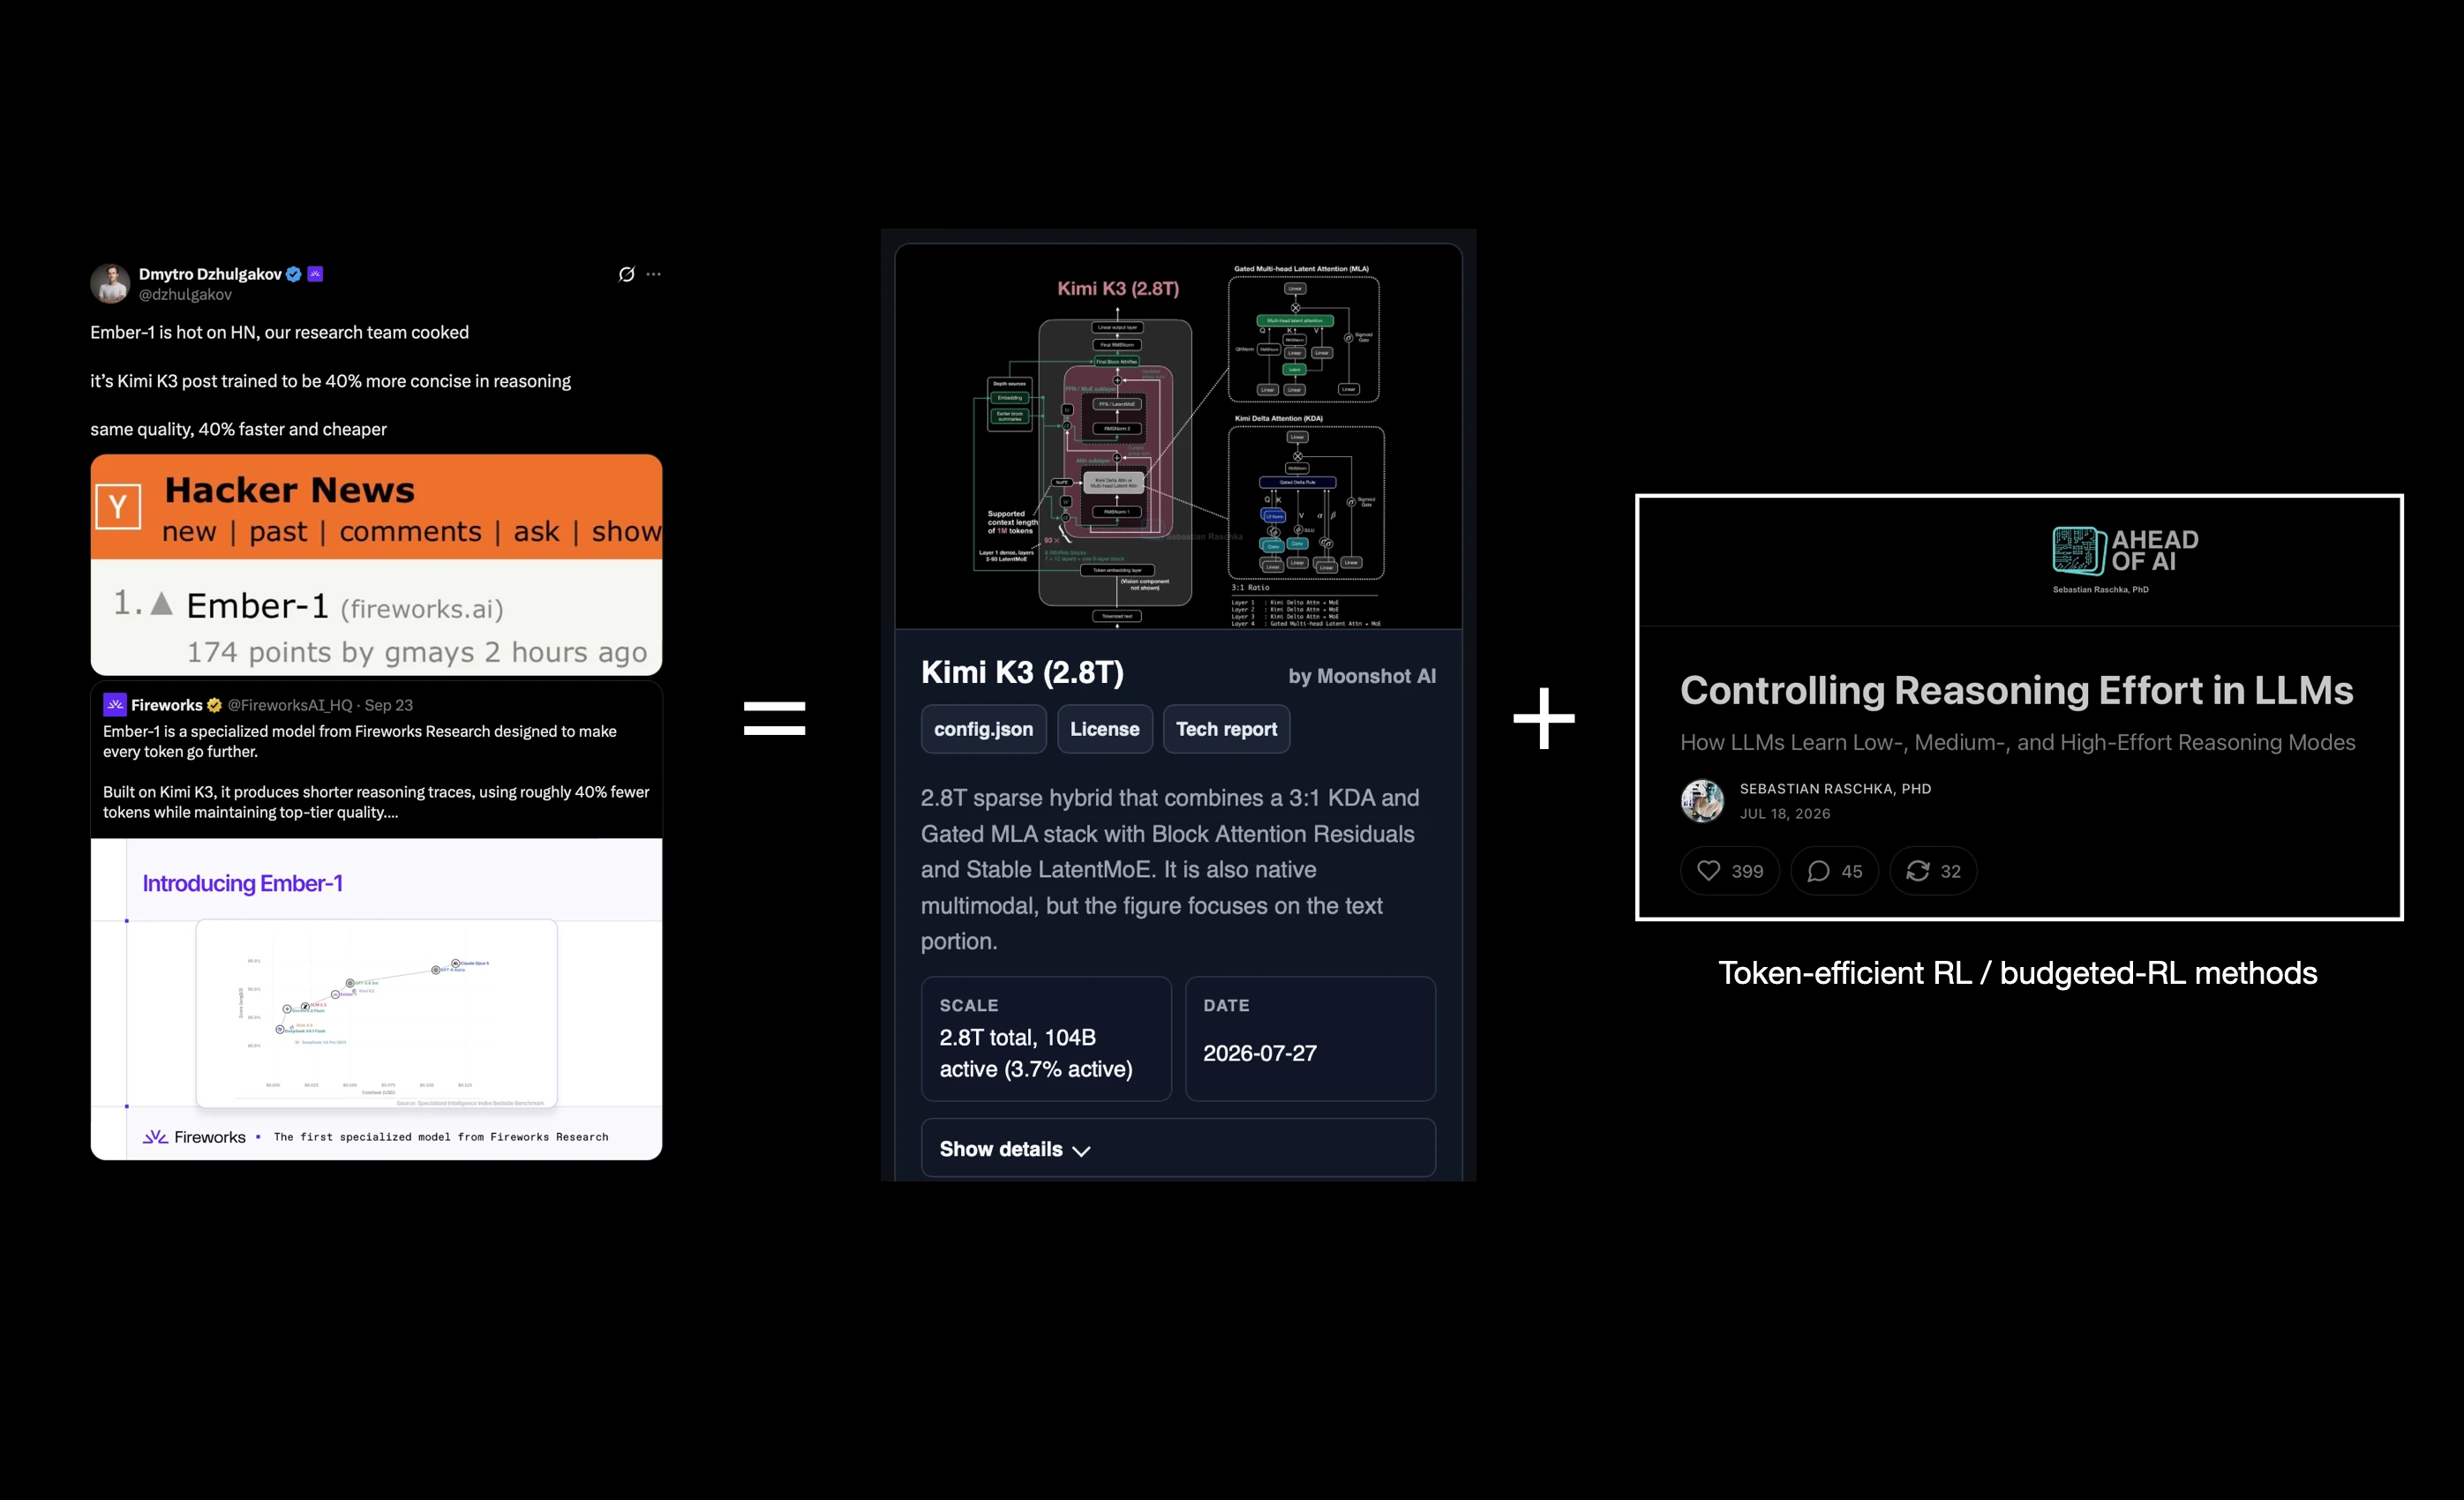
Ember-1: Post-Training reduziert Reasoning-Token-Verbrauch um 40%
ToolsFireworks AI
Warum es zählt
Wer mit begrenztem Budget kompetitive LLMs bauen will, sollte laut Raschka auf Post-Training offener Modelle setzen statt auf Pretraining. Ember-1 zeigt konkret, dass token-effizientes RL die Inferenzkosten deutlich senken kann, ohne Qualität zu opfern.
— Lumeric Redaktion
−40% Tokens
kürzere Reasoning-Traces bei Ember-1
Frag die KI zum Artikel
Folgefragen zu Headline, Quelle und Volltext — Antwort streamt in wenigen Sekunden.
Verwandte Beiträge
- FORSCHUNGarxiv.org1w
Offline RL-Post-Training verbessert Code-LLMs ohne Online-Sampling
- FORSCHUNGhuggingface.co2w
Verkürzte Reasoning-Traces verbessern LLM-Training effizienter
- FORSCHUNGarxiv.org2d
CARE reduziert Reasoning-Länge um 37 % bei besserem Pass@1
- FORSCHUNGarxiv.org2w
OverRep: Strukturiertes LLM-Pruning mit überparametrisierter Recovery-Phase