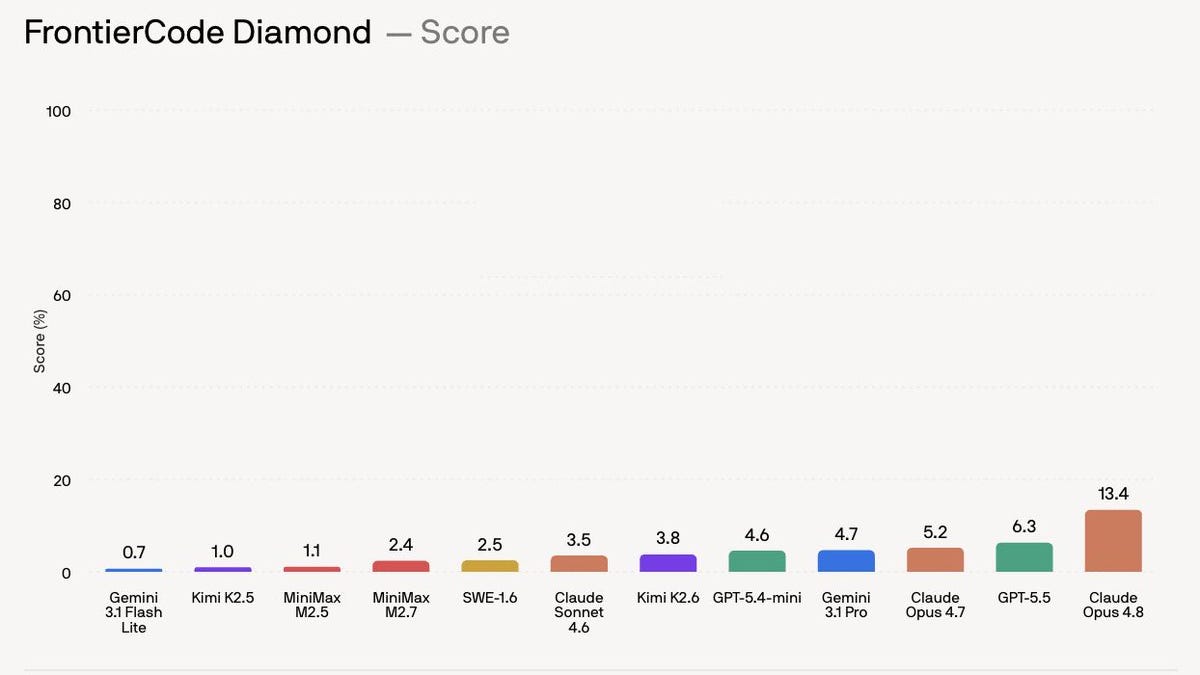
FrontierCode: Neues Benchmark misst ob Code wirklich merge-würdig ist
Frag die KI zum Artikel
Folgefragen zu Headline, Quelle und Volltext — Antwort streamt in wenigen Sekunden.
Verwandte Beiträge
- FORSCHUNGarxiv.org3w
Robustheit von Code-Agents gegenüber semantikerhaltenden Code-Transformationen untersucht
- FORSCHUNGhuggingface.co3w
SWE-bench Science: Neuer Benchmark für Coding Agents in wissenschaftlicher Software
- BENCHMARKwithspecific.com3d
Real-SWE: Benchmark für KI-Coding-Agenten auf echten Enterprise-Codebases
- FORSCHUNGarxiv.org3w
SWE Refactor Bench: Nur 5,4% der Coding-Agent-Runs meistern Ganzes-Repository-Migrationen
FrontierCode: Neues Benchmark misst ob Code wirklich merge-würdig ist
Frag die KI zum Artikel
Folgefragen zu Headline, Quelle und Volltext — Antwort streamt in wenigen Sekunden.
Verwandte Beiträge
- FORSCHUNGarxiv.org3w
Robustheit von Code-Agents gegenüber semantikerhaltenden Code-Transformationen untersucht
- FORSCHUNGhuggingface.co3w
SWE-bench Science: Neuer Benchmark für Coding Agents in wissenschaftlicher Software
- BENCHMARKwithspecific.com3d
Real-SWE: Benchmark für KI-Coding-Agenten auf echten Enterprise-Codebases
- FORSCHUNGarxiv.org3w
SWE Refactor Bench: Nur 5,4% der Coding-Agent-Runs meistern Ganzes-Repository-Migrationen