Deepgram Python SDK: Tutorial zu Transkription, TTS und Async Audio
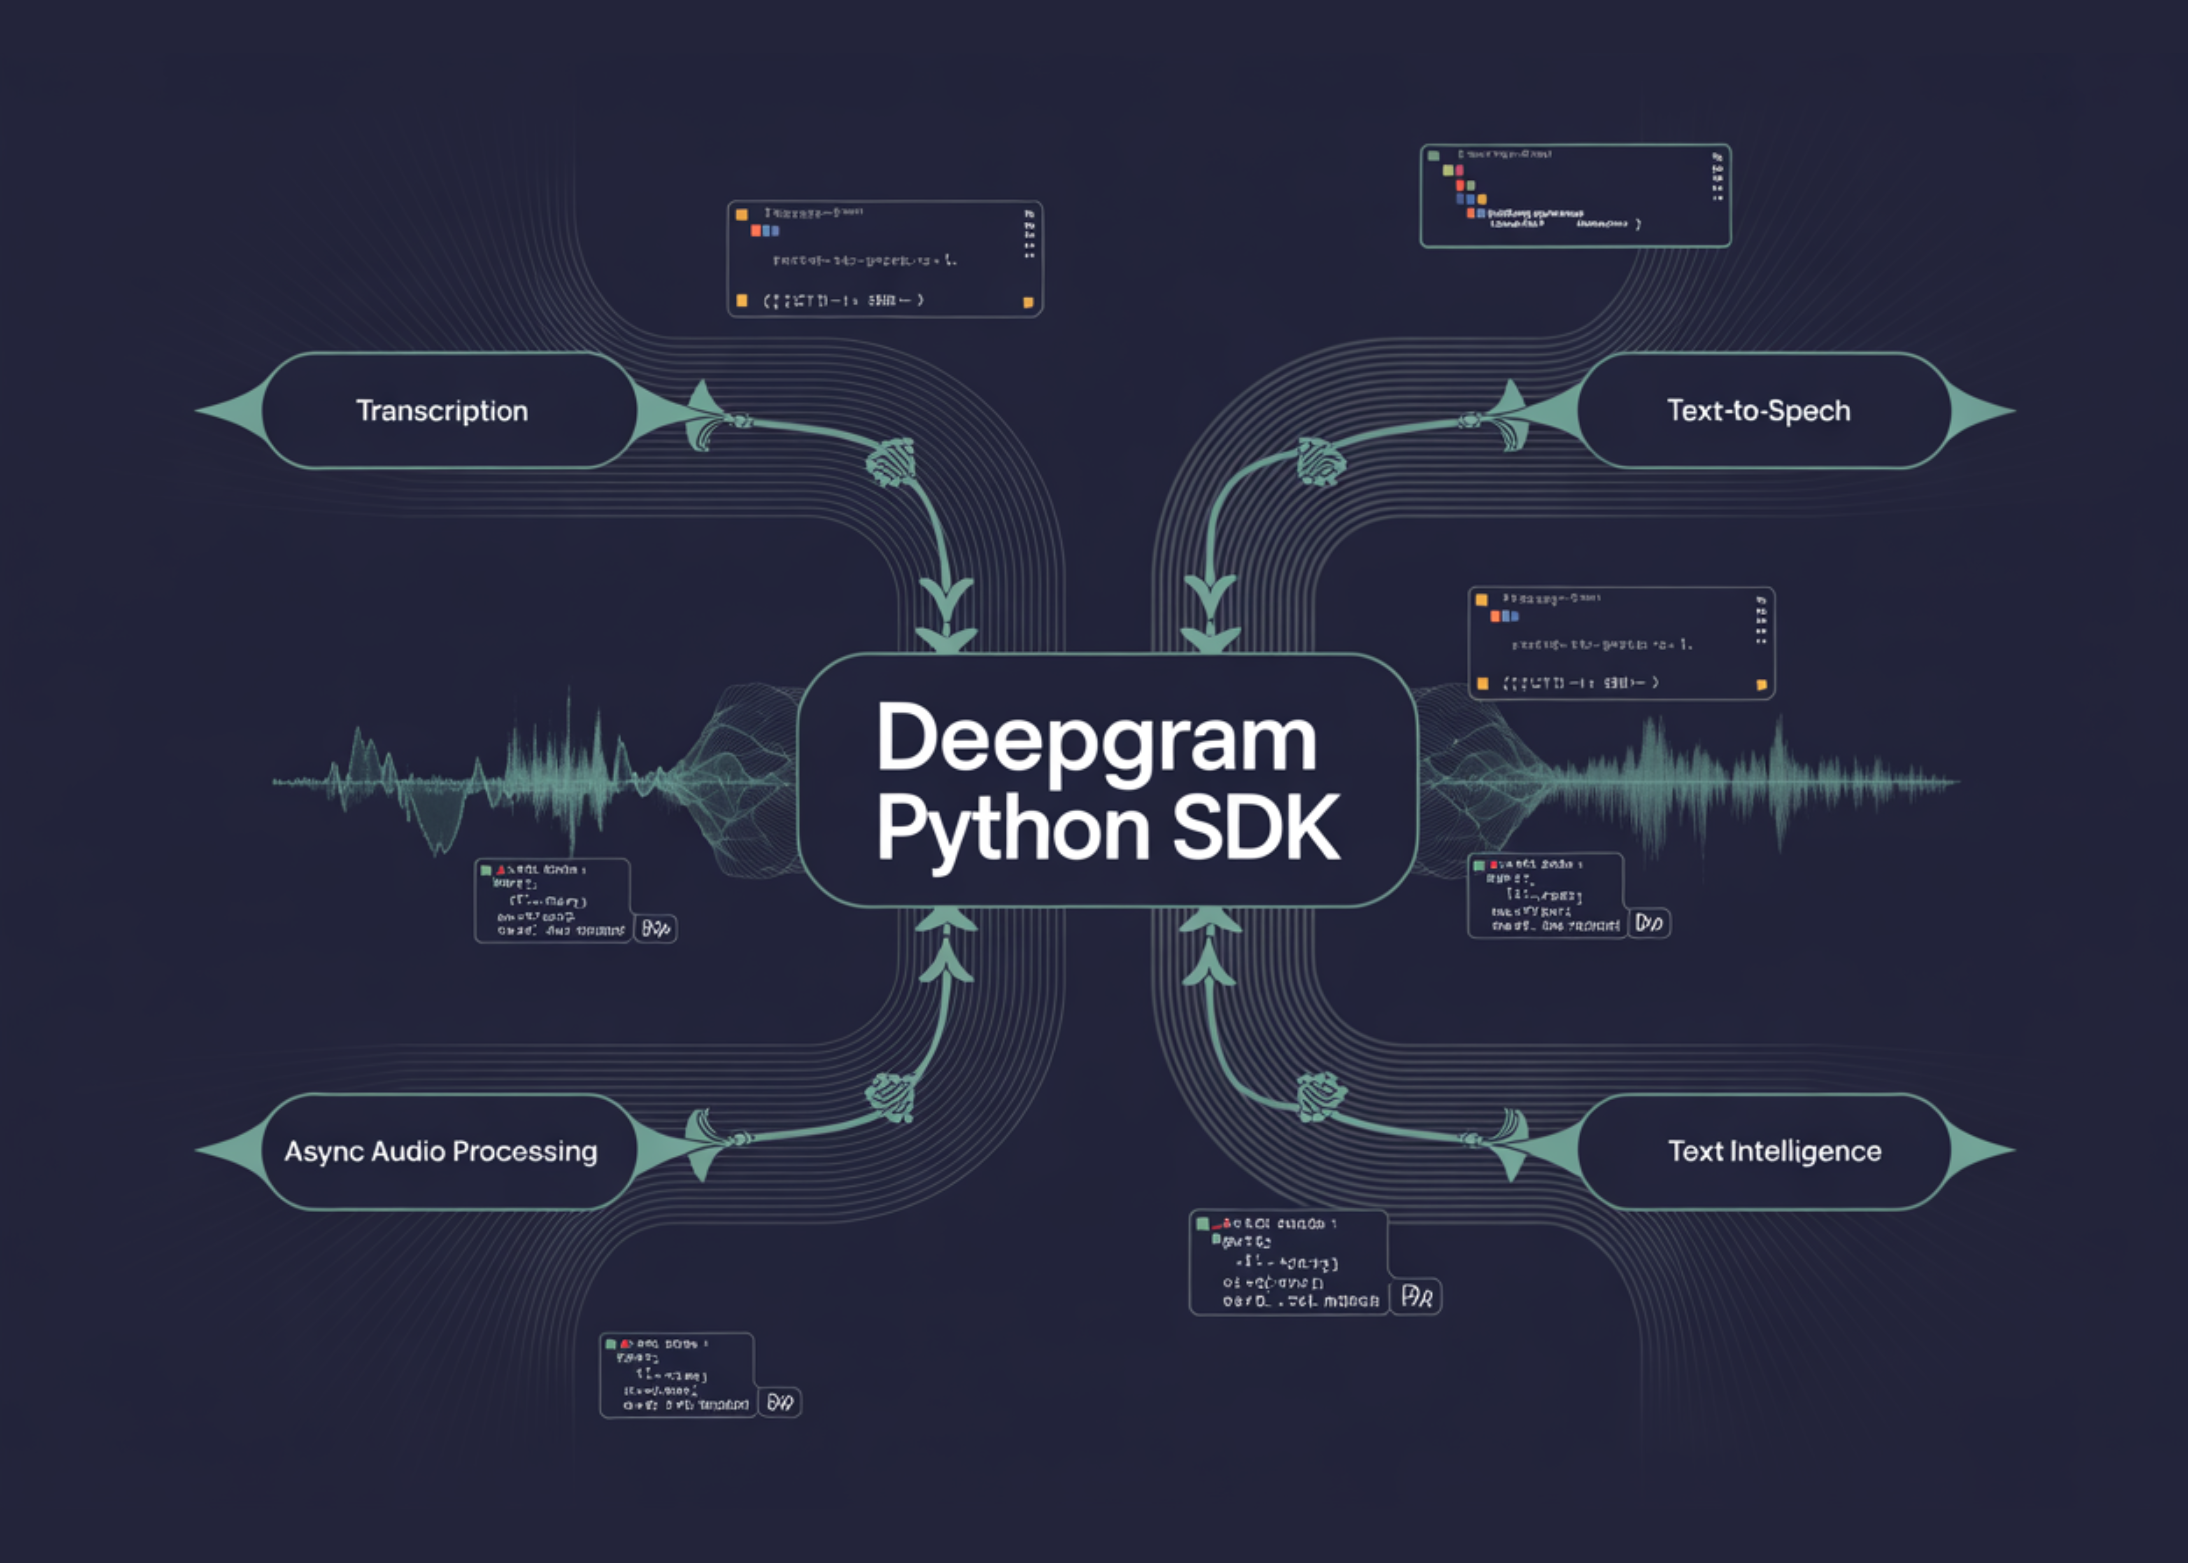
Das Deepgram Python SDK bündelt mehrere Voice-AI-Funktionen – Transkription, Text-to-Speech (TTS), asynchrone Audioverarbeitung und sogenannte Text-Intelligence – unter einer einheitlichen Schnittstelle. Das Tutorial auf MarkTechPost führt Schritt für Schritt durch den Aufbau eines vollständigen Workflows: Zunächst wird die Authentifizierung via API-Key eingerichtet, anschließend werden sowohl ein synchroner als auch ein asynchroner Deepgram-Client instanziiert. Der synchrone Client eignet sich für klassische sequenzielle Abläufe, während der Async-Client auf Pythons asyncio-Ökosystem aufsetzt und parallele Audioverarbeitung ermöglicht. Für die Transkription verarbeitet das SDK reale Audiodaten direkt, ohne dass zusätzliche Drittbibliotheken nötig sind. Die TTS-Komponente wandelt Text in Sprache um und gibt das Ergebnis als Audiodatei zurück. Text-Intelligence umfasst weiterführende NLP-Operationen wie Zusammenfassung, Sentiment-Analyse oder Topic-Detection, die Deepgram serverseitig auf transkribierten Texten ausführt. Das Tutorial richtet sich an Entwickler, die Voice-AI-Pipelines ohne komplexe Bibliotheksverbünde produktiv einsetzen wollen.
- Deepgram SDK unterstützt sowohl synchrone als auch asynchrone Clients – letztere basieren auf Pythons asyncio-Bibliothek.
- Text-Intelligence-Features umfassen serverseitige NLP-Operationen wie Zusammenfassung, Sentiment-Analyse und Topic-Detection direkt auf transkribierten Texten.
- Authentifizierung erfolgt über einen API-Key, der beim SDK-Setup einmalig konfiguriert wird – kein separates Auth-Framework erforderlich.
- TTS-Ausgabe wird als Audiodatei zurückgeliefert, die sich nahtlos in nachgelagerte Audioverarbeitungsschritte einbinden lässt.
- Das Tutorial arbeitet mit echten Audiodaten, um das Verhalten des SDK unter realistischen Bedingungen zu demonstrieren.
Frag die KI zum Artikel
Folgefragen zu Headline, Quelle und Volltext — Antwort streamt in wenigen Sekunden.
Verwandte Beiträge
Deepgram Python SDK: Tutorial zu Transkription, TTS und Async Audio
Das Deepgram Python SDK bündelt mehrere Voice-AI-Funktionen – Transkription, Text-to-Speech (TTS), asynchrone Audioverarbeitung und sogenannte Text-Intelligence – unter einer einheitlichen Schnittstelle. Das Tutorial auf MarkTechPost führt Schritt für Schritt durch den Aufbau eines vollständigen Workflows: Zunächst wird die Authentifizierung via API-Key eingerichtet, anschließend werden sowohl ein synchroner als auch ein asynchroner Deepgram-Client instanziiert. Der synchrone Client eignet sich für klassische sequenzielle Abläufe, während der Async-Client auf Pythons asyncio-Ökosystem aufsetzt und parallele Audioverarbeitung ermöglicht. Für die Transkription verarbeitet das SDK reale Audiodaten direkt, ohne dass zusätzliche Drittbibliotheken nötig sind. Die TTS-Komponente wandelt Text in Sprache um und gibt das Ergebnis als Audiodatei zurück. Text-Intelligence umfasst weiterführende NLP-Operationen wie Zusammenfassung, Sentiment-Analyse oder Topic-Detection, die Deepgram serverseitig auf transkribierten Texten ausführt. Das Tutorial richtet sich an Entwickler, die Voice-AI-Pipelines ohne komplexe Bibliotheksverbünde produktiv einsetzen wollen.
- Deepgram SDK unterstützt sowohl synchrone als auch asynchrone Clients – letztere basieren auf Pythons asyncio-Bibliothek.
- Text-Intelligence-Features umfassen serverseitige NLP-Operationen wie Zusammenfassung, Sentiment-Analyse und Topic-Detection direkt auf transkribierten Texten.
- Authentifizierung erfolgt über einen API-Key, der beim SDK-Setup einmalig konfiguriert wird – kein separates Auth-Framework erforderlich.
- TTS-Ausgabe wird als Audiodatei zurückgeliefert, die sich nahtlos in nachgelagerte Audioverarbeitungsschritte einbinden lässt.
- Das Tutorial arbeitet mit echten Audiodaten, um das Verhalten des SDK unter realistischen Bedingungen zu demonstrieren.
Frag die KI zum Artikel
Folgefragen zu Headline, Quelle und Volltext — Antwort streamt in wenigen Sekunden.