WhatsApp testet On-Device-ML zur Betrugserkennung mit Privacy-Schutz
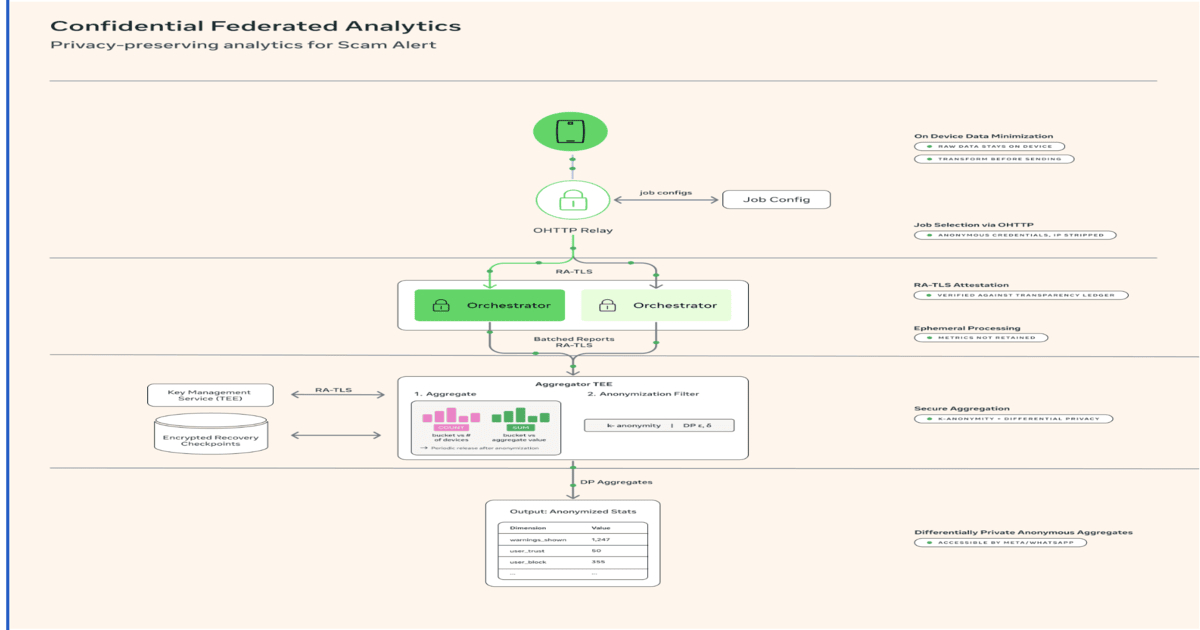
WhatsApp testet unter dem Namen „Scam Alert" eine neue Sicherheitsfunktion, die maschinelles Lernen direkt auf dem Gerät der Nutzer ausführt, um potenziell betrügerische Nachrichten von unbekannten Absendern zu erkennen. Der entscheidende Unterschied zu klassischen Ansätzen: Nachrichteninhalte verlassen das Gerät zu keinem Zeitpunkt – die gesamte Inferenz findet lokal statt. Um dennoch die Leistungsfähigkeit des Modells messen und verbessern zu können, setzt Meta auf eine Kombination aus mehreren Datenschutztechniken. Confidential Computing sorgt dafür, dass serverseitige Verarbeitung in abgeschirmten Umgebungen (Trusted Execution Environments) stattfindet. Oblivious HTTP (OHTTP) entkoppelt die Netzwerkidentität der Nutzer von den übermittelten Signalen, sodass Meta keine Verbindung zwischen IP-Adresse und Gerätedaten herstellen kann. Differential Privacy wird eingesetzt, um aggregierte Metriken statistisch zu verrauschen und Rückschlüsse auf Einzelpersonen zu verhindern. Zusätzlich setzt Meta auf Model Transparency, um nachvollziehbar zu machen, wie das Erkennungsmodell aufgebaut ist und geliefert wird. Die Funktion befindet sich derzeit in einer limitierten Beta-Phase und richtet sich zunächst an Nachrichten von Nicht-Kontakten.
- On-Device-Inferenz: Das ML-Modell läuft vollständig auf dem Gerät – Nachrichteninhalte werden nicht an Meta-Server übertragen.
- Oblivious HTTP (OHTTP) trennt Netzwerkidentität und Gerätesignale, um Nutzer-Rückverfolgung beim Reporting zu verhindern.
- Differential Privacy verrauscht aggregierte Leistungsmetriken, sodass keine Rückschlüsse auf individuelle Nutzer möglich sind.
- Confidential Computing (Trusted Execution Environments) schützt serverseitige Modellaktualisierungen und Metriken vor Zugriff auch durch Meta selbst.
- Die Beta-Phase ist limitiert und zielt zunächst auf Nachrichten von Nicht-Kontakten als Hochrisiko-Quelle für Betrug ab.
Frag die KI zum Artikel
Folgefragen zu Headline, Quelle und Volltext — Antwort streamt in wenigen Sekunden.
Verwandte Beiträge
WhatsApp testet On-Device-ML zur Betrugserkennung mit Privacy-Schutz
WhatsApp testet unter dem Namen „Scam Alert" eine neue Sicherheitsfunktion, die maschinelles Lernen direkt auf dem Gerät der Nutzer ausführt, um potenziell betrügerische Nachrichten von unbekannten Absendern zu erkennen. Der entscheidende Unterschied zu klassischen Ansätzen: Nachrichteninhalte verlassen das Gerät zu keinem Zeitpunkt – die gesamte Inferenz findet lokal statt. Um dennoch die Leistungsfähigkeit des Modells messen und verbessern zu können, setzt Meta auf eine Kombination aus mehreren Datenschutztechniken. Confidential Computing sorgt dafür, dass serverseitige Verarbeitung in abgeschirmten Umgebungen (Trusted Execution Environments) stattfindet. Oblivious HTTP (OHTTP) entkoppelt die Netzwerkidentität der Nutzer von den übermittelten Signalen, sodass Meta keine Verbindung zwischen IP-Adresse und Gerätedaten herstellen kann. Differential Privacy wird eingesetzt, um aggregierte Metriken statistisch zu verrauschen und Rückschlüsse auf Einzelpersonen zu verhindern. Zusätzlich setzt Meta auf Model Transparency, um nachvollziehbar zu machen, wie das Erkennungsmodell aufgebaut ist und geliefert wird. Die Funktion befindet sich derzeit in einer limitierten Beta-Phase und richtet sich zunächst an Nachrichten von Nicht-Kontakten.
- On-Device-Inferenz: Das ML-Modell läuft vollständig auf dem Gerät – Nachrichteninhalte werden nicht an Meta-Server übertragen.
- Oblivious HTTP (OHTTP) trennt Netzwerkidentität und Gerätesignale, um Nutzer-Rückverfolgung beim Reporting zu verhindern.
- Differential Privacy verrauscht aggregierte Leistungsmetriken, sodass keine Rückschlüsse auf individuelle Nutzer möglich sind.
- Confidential Computing (Trusted Execution Environments) schützt serverseitige Modellaktualisierungen und Metriken vor Zugriff auch durch Meta selbst.
- Die Beta-Phase ist limitiert und zielt zunächst auf Nachrichten von Nicht-Kontakten als Hochrisiko-Quelle für Betrug ab.
Frag die KI zum Artikel
Folgefragen zu Headline, Quelle und Volltext — Antwort streamt in wenigen Sekunden.