Selektionseffekt statt KI-Wirkung: Warum Adoption-Metriken trügen
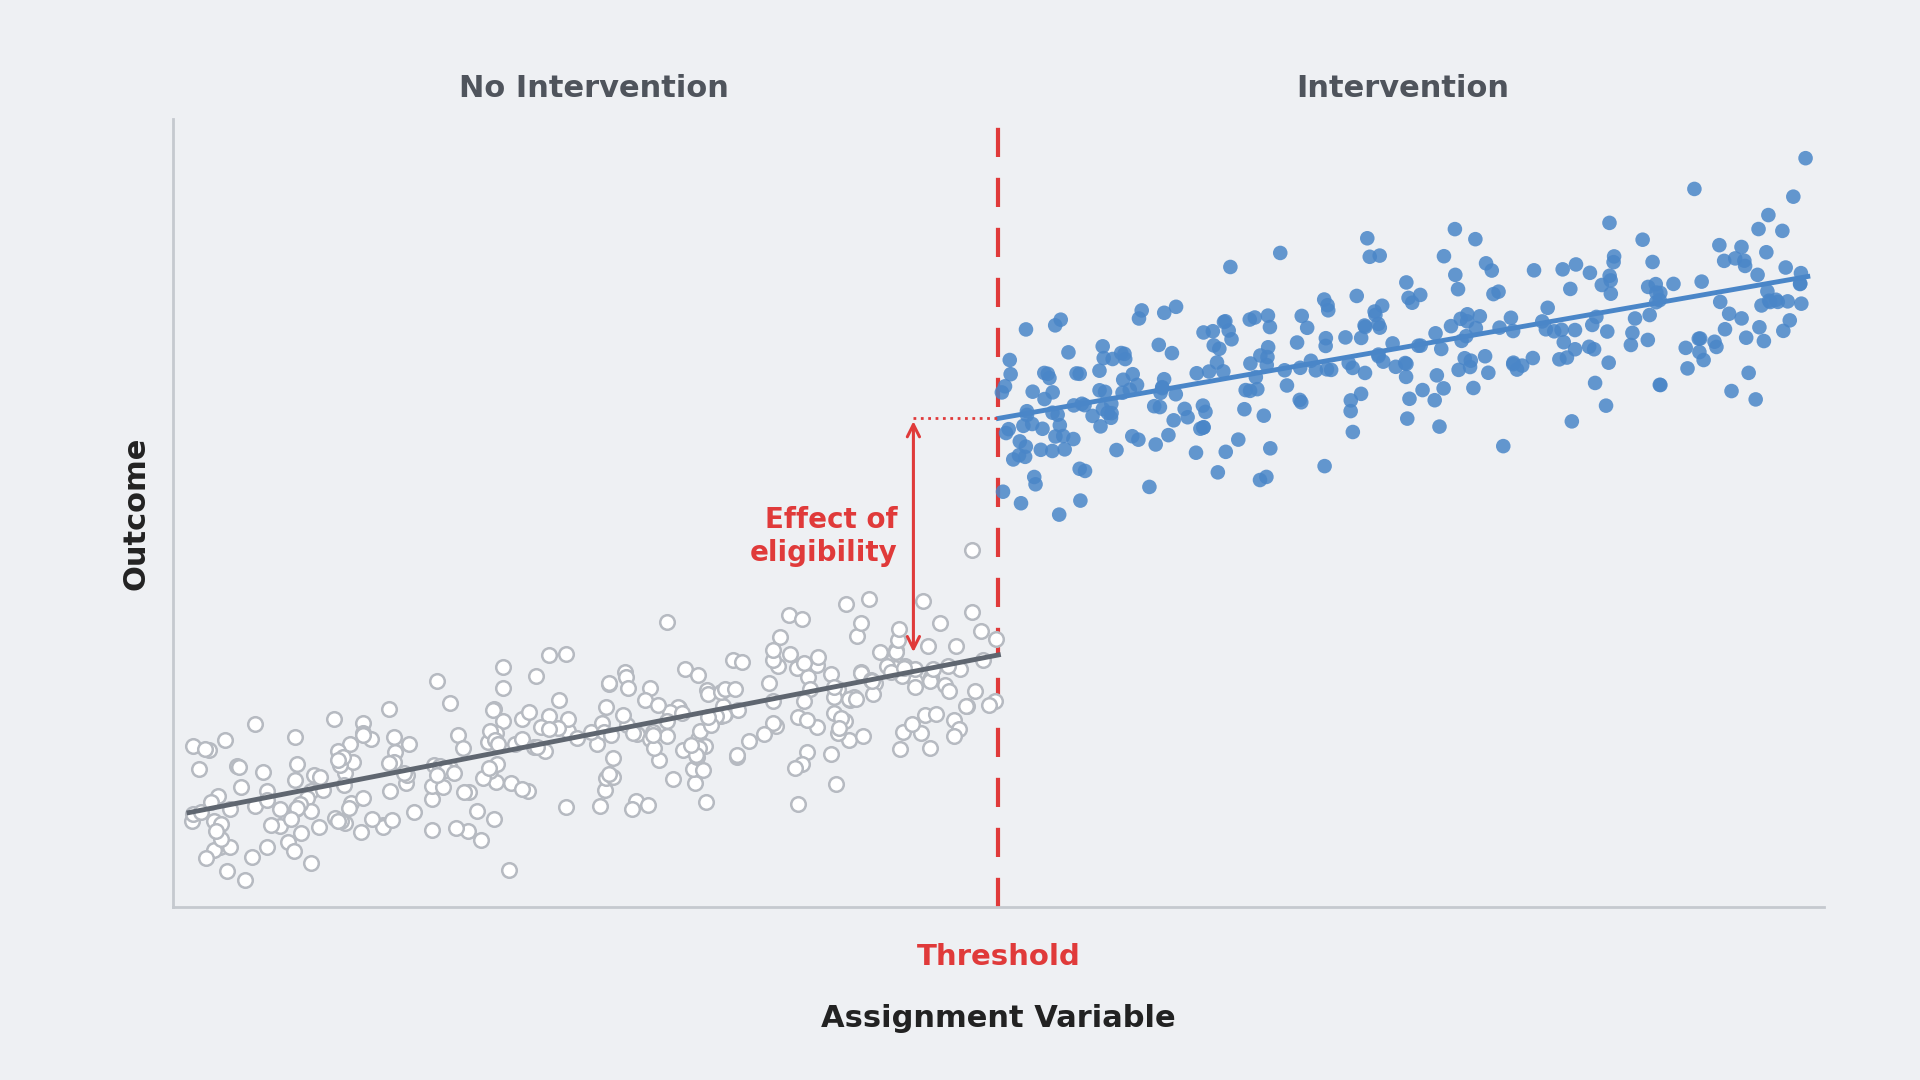
Das Problem ist grundlegend: Wenn ein KI-Feature als Opt-in ausgerollt wird, entscheiden sich systematisch jene Nutzer dafür, die bereits engagierter, technisch versierter oder organisatorisch reifer sind – genau die Accounts, die auch ohne das Feature besser performen würden. Der Artikel beschreibt dieses Phänomen am Beispiel eines simulierten B2B-SaaS-Szenarios, in dem der naive Vergleich zwischen Adoptern und Nicht-Adoptern einen Retention-Lift von +15,4 Prozentpunkten suggeriert, während der tatsächlich kausale Effekt nach sauberer Adjustierung nur 4 Prozentpunkte beträgt – eine Überschätzung um fast das Vierfache. Der Kernmechanismus ist ein Selektionseffekt: Unternehmen, die KI-Features früh adoptieren, unterscheiden sich in unbeobachteten Merkmalen systematisch von denen, die es nicht tun. Als Gegenmittel schlägt der Autor vor, Eligibility-Rules – also die Regeln, die bestimmen, wer Zugang zu einem Feature erhält – als natürliche Experimente zu nutzen. Diese Diskontinuitäten in der Zugangsberechtigung erzeugen lokale Quasi-Randomisierung und erlauben eine glaubwürdigere Kausalidentifikation ohne echtes A/B-Testing. Der Ansatz ist besonders relevant in B2B-Kontexten, wo Randomisierung auf Account-Ebene oft praktisch oder politisch nicht durchsetzbar ist. Der Artikel richtet sich explizit an Data-Science- und Analytics-Praktiker, die Rollout-Entscheidungen auf Basis von Beobachtungsdaten treffen müssen.
- Naiver Adopter-Vergleich im B2B-Beispiel: +15,4 Prozentpunkte Retention-Lift – nach Kausalkorrektur verbleiben nur 4 Prozentpunkte.
- Eligibility-Rules (Zugangsbeschränkungen für Features) werden als natürliche Experimente vorgeschlagen, um Quasi-Randomisierung zu erzeugen.
- Der Artikel positioniert sich explizit als Practitioner's Guide für Situationen ohne randomisiertes Experiment.
- Selektionseffekte entstehen laut Autor, weil Früh-Adopter sich in unbeobachteten Dimensionen wie Organisationsreife und technischer Kompetenz unterscheiden.
- Das beschriebene Verfahren ist auf jedes Opt-in-Feature anwendbar, bei dem Zugangskriterien eine natürliche Trennlinie zwischen Gruppen erzeugen.
Frag die KI zum Artikel
Folgefragen zu Headline, Quelle und Volltext — Antwort streamt in wenigen Sekunden.
Verwandte Beiträge
Selektionseffekt statt KI-Wirkung: Warum Adoption-Metriken trügen
Das Problem ist grundlegend: Wenn ein KI-Feature als Opt-in ausgerollt wird, entscheiden sich systematisch jene Nutzer dafür, die bereits engagierter, technisch versierter oder organisatorisch reifer sind – genau die Accounts, die auch ohne das Feature besser performen würden. Der Artikel beschreibt dieses Phänomen am Beispiel eines simulierten B2B-SaaS-Szenarios, in dem der naive Vergleich zwischen Adoptern und Nicht-Adoptern einen Retention-Lift von +15,4 Prozentpunkten suggeriert, während der tatsächlich kausale Effekt nach sauberer Adjustierung nur 4 Prozentpunkte beträgt – eine Überschätzung um fast das Vierfache. Der Kernmechanismus ist ein Selektionseffekt: Unternehmen, die KI-Features früh adoptieren, unterscheiden sich in unbeobachteten Merkmalen systematisch von denen, die es nicht tun. Als Gegenmittel schlägt der Autor vor, Eligibility-Rules – also die Regeln, die bestimmen, wer Zugang zu einem Feature erhält – als natürliche Experimente zu nutzen. Diese Diskontinuitäten in der Zugangsberechtigung erzeugen lokale Quasi-Randomisierung und erlauben eine glaubwürdigere Kausalidentifikation ohne echtes A/B-Testing. Der Ansatz ist besonders relevant in B2B-Kontexten, wo Randomisierung auf Account-Ebene oft praktisch oder politisch nicht durchsetzbar ist. Der Artikel richtet sich explizit an Data-Science- und Analytics-Praktiker, die Rollout-Entscheidungen auf Basis von Beobachtungsdaten treffen müssen.
- Naiver Adopter-Vergleich im B2B-Beispiel: +15,4 Prozentpunkte Retention-Lift – nach Kausalkorrektur verbleiben nur 4 Prozentpunkte.
- Eligibility-Rules (Zugangsbeschränkungen für Features) werden als natürliche Experimente vorgeschlagen, um Quasi-Randomisierung zu erzeugen.
- Der Artikel positioniert sich explizit als Practitioner's Guide für Situationen ohne randomisiertes Experiment.
- Selektionseffekte entstehen laut Autor, weil Früh-Adopter sich in unbeobachteten Dimensionen wie Organisationsreife und technischer Kompetenz unterscheiden.
- Das beschriebene Verfahren ist auf jedes Opt-in-Feature anwendbar, bei dem Zugangskriterien eine natürliche Trennlinie zwischen Gruppen erzeugen.
Frag die KI zum Artikel
Folgefragen zu Headline, Quelle und Volltext — Antwort streamt in wenigen Sekunden.