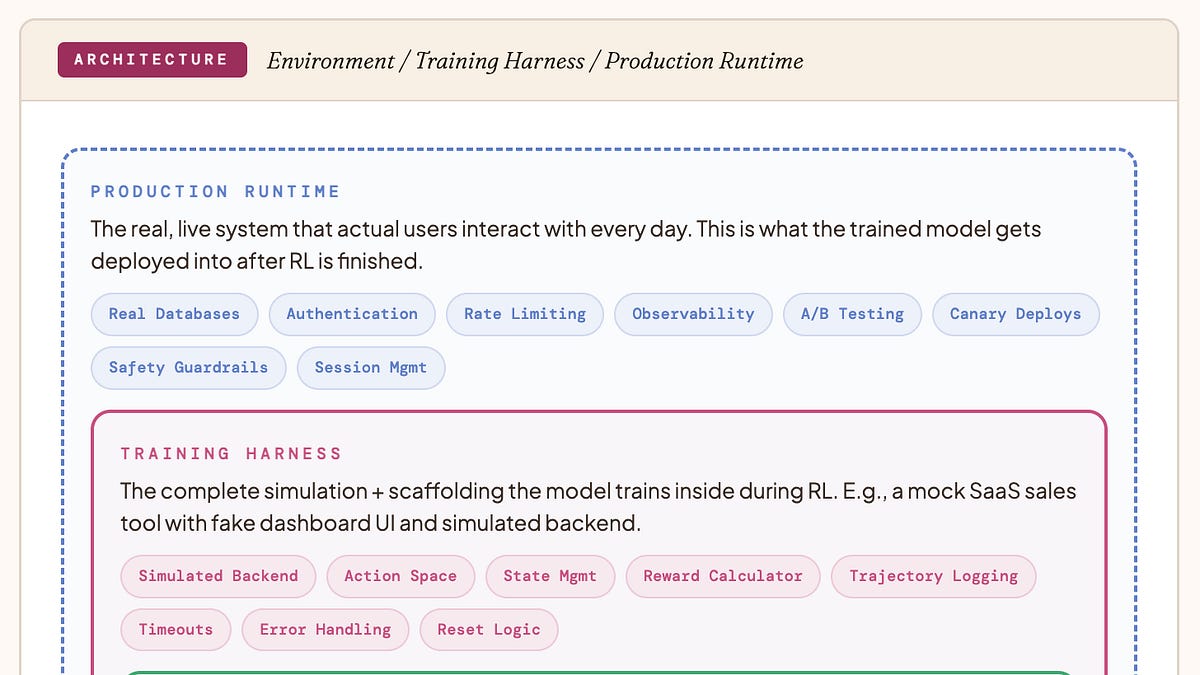
Fehlerhafte RL-Environments ruinieren Trainingsdaten – eine Praxis-Analyse
Frag die KI zum Artikel
Folgefragen zu Headline, Quelle und Volltext — Antwort streamt in wenigen Sekunden.
Verwandte Beiträge
- FORSCHUNGarxiv.org3w
RobustTests: RL-Framework verbessert Code-Generierung mit fehlergetriebenem Testcase-Ansatz
- FORSCHUNGhuggingface.co3w
EnvHarness: Dynamische Trainingsumgebungen für RL-Agenten ohne Neubau
- FORSCHUNGarxiv.org3w
RL-Framework reduziert Explorationsbias beim Multi-Instruction-Following in LLMs
- FORSCHUNGarxiv.org2d
Countdown-Code: Testumgebung zur Messung von Reward Hacking in RLVR
Fehlerhafte RL-Environments ruinieren Trainingsdaten – eine Praxis-Analyse
Frag die KI zum Artikel
Folgefragen zu Headline, Quelle und Volltext — Antwort streamt in wenigen Sekunden.
Verwandte Beiträge
- FORSCHUNGarxiv.org3w
RobustTests: RL-Framework verbessert Code-Generierung mit fehlergetriebenem Testcase-Ansatz
- FORSCHUNGhuggingface.co3w
EnvHarness: Dynamische Trainingsumgebungen für RL-Agenten ohne Neubau
- FORSCHUNGarxiv.org3w
RL-Framework reduziert Explorationsbias beim Multi-Instruction-Following in LLMs
- FORSCHUNGarxiv.org2d
Countdown-Code: Testumgebung zur Messung von Reward Hacking in RLVR