Megakernels in der Inference: Debatte über Sinn und Ende der Kernel-Fusion
Die Debatte um Megakernels – monolithisch fusionierte GPU-Kernels für schnellere Inference – wurde in der Latent Space Inference Engineering Masterclass neu entfacht. Der Nutzer „ali" (alias @waterloo_intern) hatte im Podcast provokante Thesen aufgestellt und rechtfertigte sich anschließend via Thread mit rund 380.000 Impressionen. Kernpunkt: Der klassische Nutzen von Megakernels besteht darin, Launch-Overhead und schlechtes Inter-Kernel-Overlap zu eliminieren – ein aufwändiger Prozess, der laut Ali oft zwei Monate Entwicklungszeit kostet. Praktisch scheitert der Ansatz aber daran, dass bei Tensor-Parallelismus ohnehin GPU-übergreifende Kommunikation für Nichtlinearitäten wie Softmax erzwungen wird und ein fusionierter Kernel dieses Hindernis nicht umgeht. NVIDIA-Engineer Kyle Kranen enthüllte in einem Tweet vom 21. Juli 2026, dass Rubins Architektur „Tile-level Dependency Triggers" einführt: Kernels können nun starten, sobald die benötigten Daten einer bestimmten Tile-Einheit verfügbar sind, ohne auf den Abschluss des gesamten vorherigen Kernels zu warten – das beseitigt das sogenannte Straggler-CTA-Problem hardwareseitig. Ali zufolge haben selbst Unternehmen, die intern an Megakernels gearbeitet haben, diese oft nicht in Produktion gebracht, da separat optimierte TensorRT-LLM-Kernels durch Parallelisierung schneller sind. Bemerkenswert ist zudem, dass Ben Spectors Megakernel-Mitautor Stuart Sul inzwischen ein eigenes Projekt leitet – was die personelle Abkehr vom Ansatz symbolisiert.
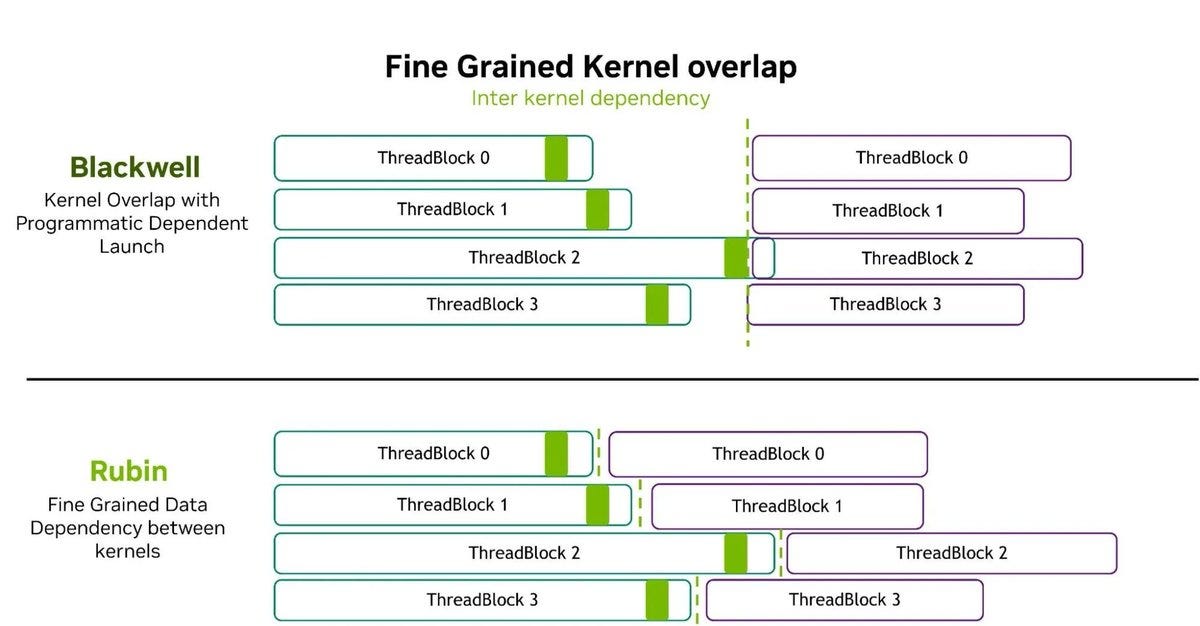
- Nvidia Rubins 'Tile-level Dependency Triggers' erlauben den Start von Kernel 2, sobald die ersten verfügbaren Tiles aus Kernel 1 fertig sind — ohne auf straggling CTAs zu warten.
- Kyle Kranens Tweet zu Rubin-Dependency-Triggers (21. Juli 2026) erzielte 27.200 Views, 8 Reposts und 98 Likes.
- Ali (@waterloo_intern) argumentiert: Bei Tensor-Parallelismus erzwingt Softmax ohnehin GPU-Kommunikation — ein Megakernel kann diesen Synchronisierungspunkt nicht eliminieren.
- Stuart Sul, Mitautor von Ben Spectors Megakernel-Paper, leitet nun das Team hinter 'Mixture of Kittens', einem separaten Inference-Projekt.
- Alis ursprünglicher Thread erzielte rund 380.000 Impressionen sowie 1.280 Likes und 67 Reposts auf X.
Frag die KI zum Artikel
Folgefragen zu Headline, Quelle und Volltext — Antwort streamt in wenigen Sekunden.
Verwandte Beiträge
Megakernels in der Inference: Debatte über Sinn und Ende der Kernel-Fusion
Die Debatte um Megakernels – monolithisch fusionierte GPU-Kernels für schnellere Inference – wurde in der Latent Space Inference Engineering Masterclass neu entfacht. Der Nutzer „ali" (alias @waterloo_intern) hatte im Podcast provokante Thesen aufgestellt und rechtfertigte sich anschließend via Thread mit rund 380.000 Impressionen. Kernpunkt: Der klassische Nutzen von Megakernels besteht darin, Launch-Overhead und schlechtes Inter-Kernel-Overlap zu eliminieren – ein aufwändiger Prozess, der laut Ali oft zwei Monate Entwicklungszeit kostet. Praktisch scheitert der Ansatz aber daran, dass bei Tensor-Parallelismus ohnehin GPU-übergreifende Kommunikation für Nichtlinearitäten wie Softmax erzwungen wird und ein fusionierter Kernel dieses Hindernis nicht umgeht. NVIDIA-Engineer Kyle Kranen enthüllte in einem Tweet vom 21. Juli 2026, dass Rubins Architektur „Tile-level Dependency Triggers" einführt: Kernels können nun starten, sobald die benötigten Daten einer bestimmten Tile-Einheit verfügbar sind, ohne auf den Abschluss des gesamten vorherigen Kernels zu warten – das beseitigt das sogenannte Straggler-CTA-Problem hardwareseitig. Ali zufolge haben selbst Unternehmen, die intern an Megakernels gearbeitet haben, diese oft nicht in Produktion gebracht, da separat optimierte TensorRT-LLM-Kernels durch Parallelisierung schneller sind. Bemerkenswert ist zudem, dass Ben Spectors Megakernel-Mitautor Stuart Sul inzwischen ein eigenes Projekt leitet – was die personelle Abkehr vom Ansatz symbolisiert.
- Nvidia Rubins 'Tile-level Dependency Triggers' erlauben den Start von Kernel 2, sobald die ersten verfügbaren Tiles aus Kernel 1 fertig sind — ohne auf straggling CTAs zu warten.
- Kyle Kranens Tweet zu Rubin-Dependency-Triggers (21. Juli 2026) erzielte 27.200 Views, 8 Reposts und 98 Likes.
- Ali (@waterloo_intern) argumentiert: Bei Tensor-Parallelismus erzwingt Softmax ohnehin GPU-Kommunikation — ein Megakernel kann diesen Synchronisierungspunkt nicht eliminieren.
- Stuart Sul, Mitautor von Ben Spectors Megakernel-Paper, leitet nun das Team hinter 'Mixture of Kittens', einem separaten Inference-Projekt.
- Alis ursprünglicher Thread erzielte rund 380.000 Impressionen sowie 1.280 Likes und 67 Reposts auf X.
Frag die KI zum Artikel
Folgefragen zu Headline, Quelle und Volltext — Antwort streamt in wenigen Sekunden.