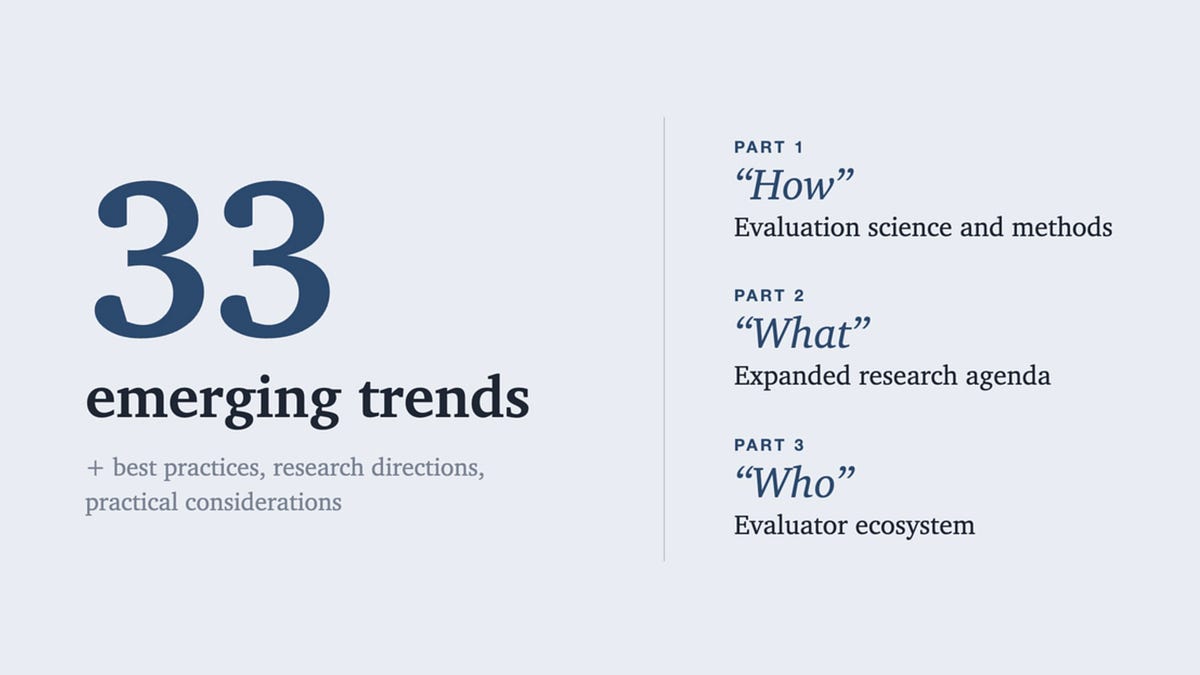
Princeton-Paper: 33 Trends bei der Evaluation von KI-Agenten
Warum es zählt
Agenten-Evaluation ist deutlich teurer und komplexer als Modell-Evaluation; einzelne Benchmarks wie ExploitBench kosten zehntausende Dollar. Unabhängige Evaluatoren verlieren durch steigende Kosten, eingeschränkten Modellzugang und fehlende Rohdaten (Chain-of-Thought-Traces) an Handlungsspielraum – das beeinflusst direkt, welche Fragen überhaupt gestellt werden.
— Lumeric Redaktion
Frag die KI zum Artikel
Folgefragen zu Headline, Quelle und Volltext — Antwort streamt in wenigen Sekunden.
Verwandte Beiträge
Princeton-Paper: 33 Trends bei der Evaluation von KI-Agenten
Warum es zählt
Agenten-Evaluation ist deutlich teurer und komplexer als Modell-Evaluation; einzelne Benchmarks wie ExploitBench kosten zehntausende Dollar. Unabhängige Evaluatoren verlieren durch steigende Kosten, eingeschränkten Modellzugang und fehlende Rohdaten (Chain-of-Thought-Traces) an Handlungsspielraum – das beeinflusst direkt, welche Fragen überhaupt gestellt werden.
— Lumeric Redaktion
Frag die KI zum Artikel
Folgefragen zu Headline, Quelle und Volltext — Antwort streamt in wenigen Sekunden.