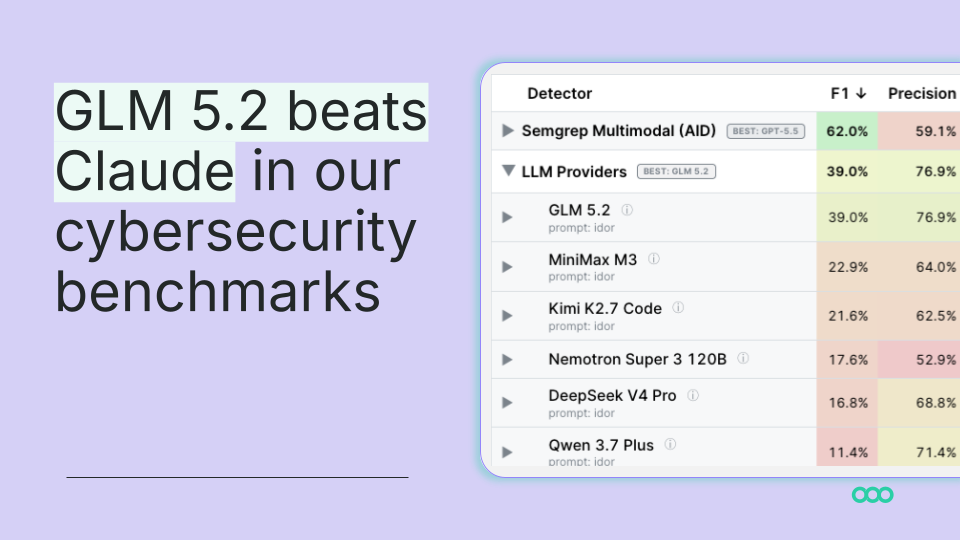
GLM 5.2 übertrifft Claude Code bei IDOR-Sicherheitsbenchmark von Semgrep
Frag die KI zum Artikel
Folgefragen zu Headline, Quelle und Volltext — Antwort streamt in wenigen Sekunden.
Verwandte Beiträge
- BENCHMARKreinvently.co.uk3w
GLM-5.3 übertrifft OpenAI- und Anthropic-Modelle bei 1/5 der Kosten
- BENCHMARKtogether.ai3w
GLM-5.3 vs. Claude Fable 5 auf DeepSWE: 5,4× Kostenvorteil bei gleicher Genauigkeit
- BENCHMARKarxiv.org4d
VEX-Bench: Erster Benchmark für LLM-Agenten zur Ausnutzbarkeit von Software-Supply-Chain-Schwachstellen
- BENCHMARKreddit.com1w
Reddit-Analyse: Lokale Open-Source-Modelle schlagen Frontier-Modelle bei Security-Audits
GLM 5.2 übertrifft Claude Code bei IDOR-Sicherheitsbenchmark von Semgrep
Frag die KI zum Artikel
Folgefragen zu Headline, Quelle und Volltext — Antwort streamt in wenigen Sekunden.
Verwandte Beiträge
- BENCHMARKreinvently.co.uk3w
GLM-5.3 übertrifft OpenAI- und Anthropic-Modelle bei 1/5 der Kosten
- BENCHMARKtogether.ai3w
GLM-5.3 vs. Claude Fable 5 auf DeepSWE: 5,4× Kostenvorteil bei gleicher Genauigkeit
- BENCHMARKarxiv.org4d
VEX-Bench: Erster Benchmark für LLM-Agenten zur Ausnutzbarkeit von Software-Supply-Chain-Schwachstellen
- BENCHMARKreddit.com1w
Reddit-Analyse: Lokale Open-Source-Modelle schlagen Frontier-Modelle bei Security-Audits