Generative KI skaliert quadratisch – ein teures Ingenieurs-Versagen
CompaniesOpenAI
Warum es zählt
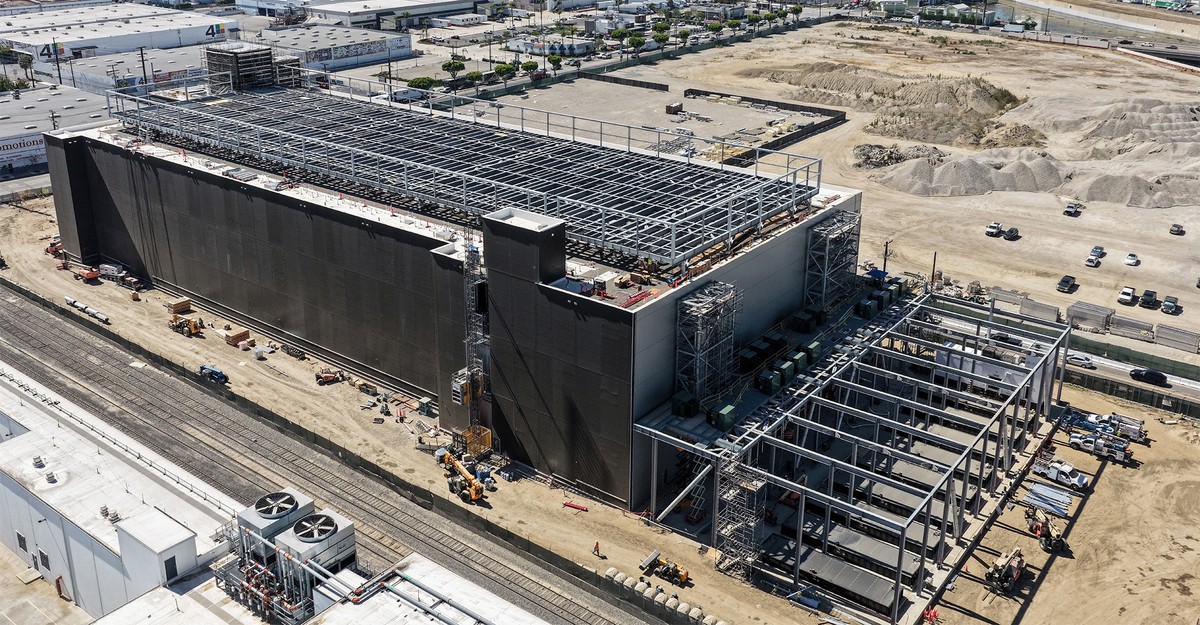
LLMs skalieren quadratisch mit der Eingabelänge – jeder zusätzliche Token kostet exponentiell mehr Ressourcen. Das treibt Datencenter-Ausbau, Speicherpreise und Stromverbrauch in die Höhe, ohne dass ein Effizienz-Durchbruch in Sicht ist. Für AI-Builder bedeutet das: Skalierungskosten sind strukturell, nicht nur operativ.
— Lumeric Redaktion
„By economic and engineering measures, generative AI might be the worst technology ever deployed.“
Frag die KI zum Artikel
Folgefragen zu Headline, Quelle und Volltext — Antwort streamt in wenigen Sekunden.
Verwandte Beiträge
- MEINUNGthesequence.substack.com3w
Energieverbrauch als neue Skalierungsgrenze für KI
- FORSCHUNGhuggingface.co3w
LLMs vs. Embedding-Modelle: Gleiche Leistung, aber weit höhere Kosten
- FORSCHUNGarxiv.org3w
Energy-Aware Knowledge Distillation reduziert LLM-Inferenzenergie um bis zu 90 %
- FORSCHUNGarxiv.org1d
Byte-Modelle übertreffen Token-Modelle bei hohem Compute durch Distillation
Generative KI skaliert quadratisch – ein teures Ingenieurs-Versagen
CompaniesOpenAI
Warum es zählt
LLMs skalieren quadratisch mit der Eingabelänge – jeder zusätzliche Token kostet exponentiell mehr Ressourcen. Das treibt Datencenter-Ausbau, Speicherpreise und Stromverbrauch in die Höhe, ohne dass ein Effizienz-Durchbruch in Sicht ist. Für AI-Builder bedeutet das: Skalierungskosten sind strukturell, nicht nur operativ.
— Lumeric Redaktion
„By economic and engineering measures, generative AI might be the worst technology ever deployed.“
Frag die KI zum Artikel
Folgefragen zu Headline, Quelle und Volltext — Antwort streamt in wenigen Sekunden.
Verwandte Beiträge
- MEINUNGthesequence.substack.com3w
Energieverbrauch als neue Skalierungsgrenze für KI
- FORSCHUNGhuggingface.co3w
LLMs vs. Embedding-Modelle: Gleiche Leistung, aber weit höhere Kosten
- FORSCHUNGarxiv.org3w
Energy-Aware Knowledge Distillation reduziert LLM-Inferenzenergie um bis zu 90 %
- FORSCHUNGarxiv.org1d
Byte-Modelle übertreffen Token-Modelle bei hohem Compute durch Distillation