N²-Speicherproblem in ML-Pipelines: Wie quadratische Komplexität Kosten verdoppelt
Warum es zählt
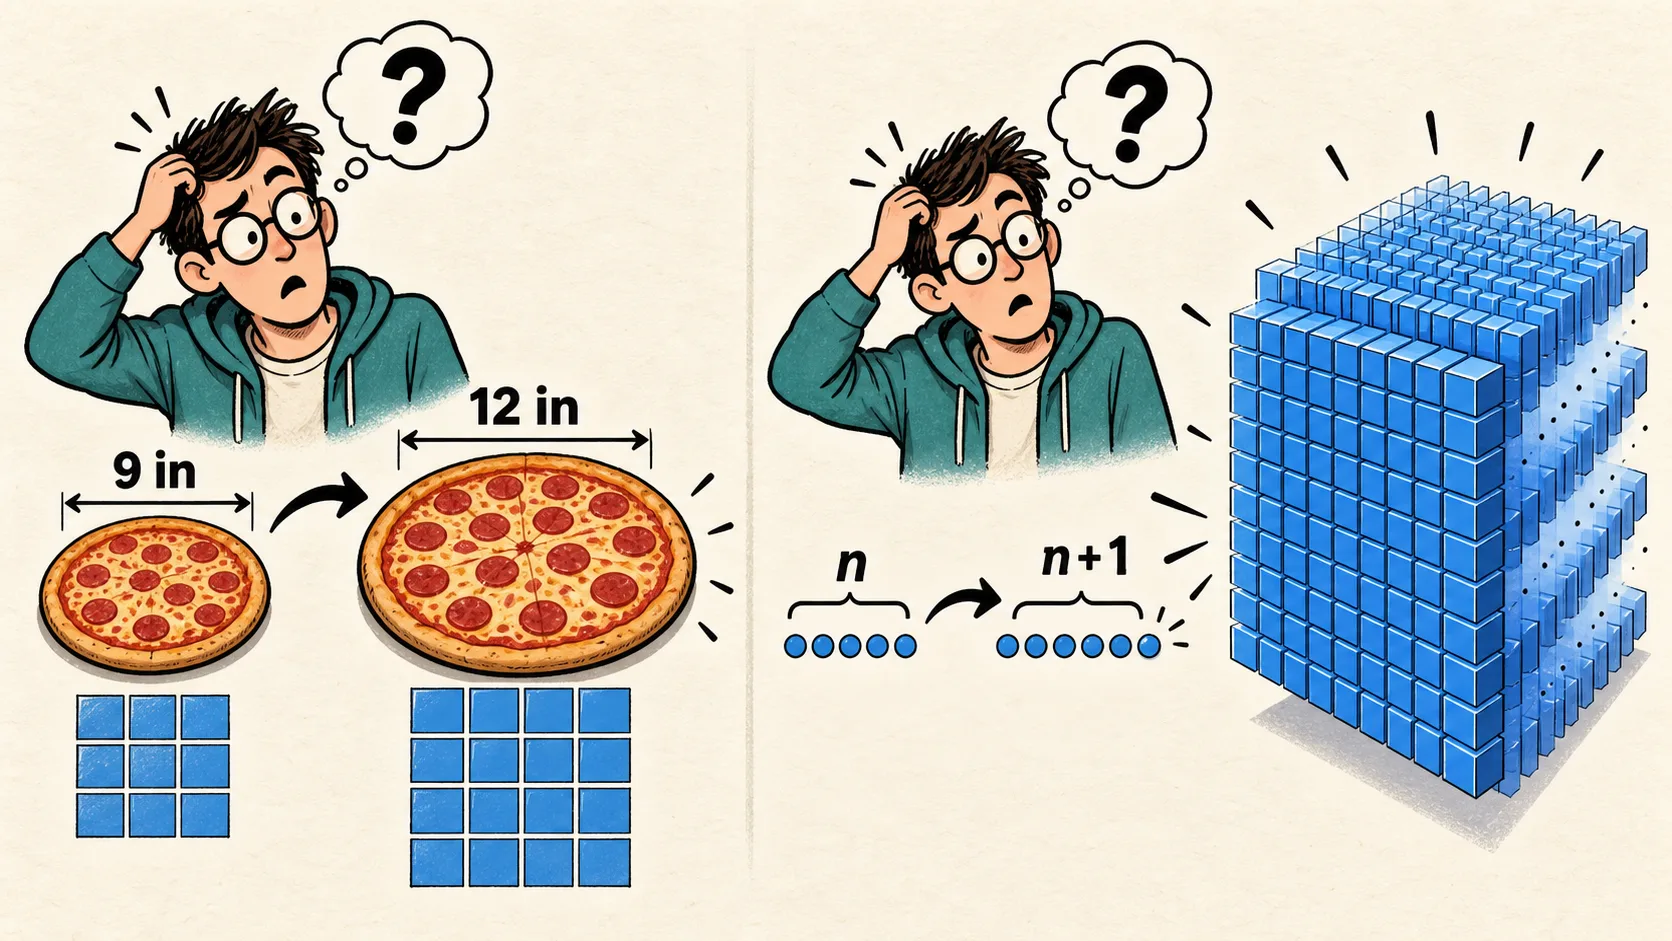
ML-Pipelines mit paarweisen Ähnlichkeitsberechnungen können bei großen Clustern O(N²)-Speicher erzeugen, der Fleet-weites Overprovisioning erzwingt. Feinkörniges Stage-Level-Memory-Sampling (100ms-Intervall, cgroup-basiert) ist entscheidend, um solche Spitzen überhaupt erst sichtbar zu machen.
— Lumeric Redaktion
Frag die KI zum Artikel
Folgefragen zu Headline, Quelle und Volltext — Antwort streamt in wenigen Sekunden.
Verwandte Beiträge
N²-Speicherproblem in ML-Pipelines: Wie quadratische Komplexität Kosten verdoppelt
Warum es zählt
ML-Pipelines mit paarweisen Ähnlichkeitsberechnungen können bei großen Clustern O(N²)-Speicher erzeugen, der Fleet-weites Overprovisioning erzwingt. Feinkörniges Stage-Level-Memory-Sampling (100ms-Intervall, cgroup-basiert) ist entscheidend, um solche Spitzen überhaupt erst sichtbar zu machen.
— Lumeric Redaktion
Frag die KI zum Artikel
Folgefragen zu Headline, Quelle und Volltext — Antwort streamt in wenigen Sekunden.