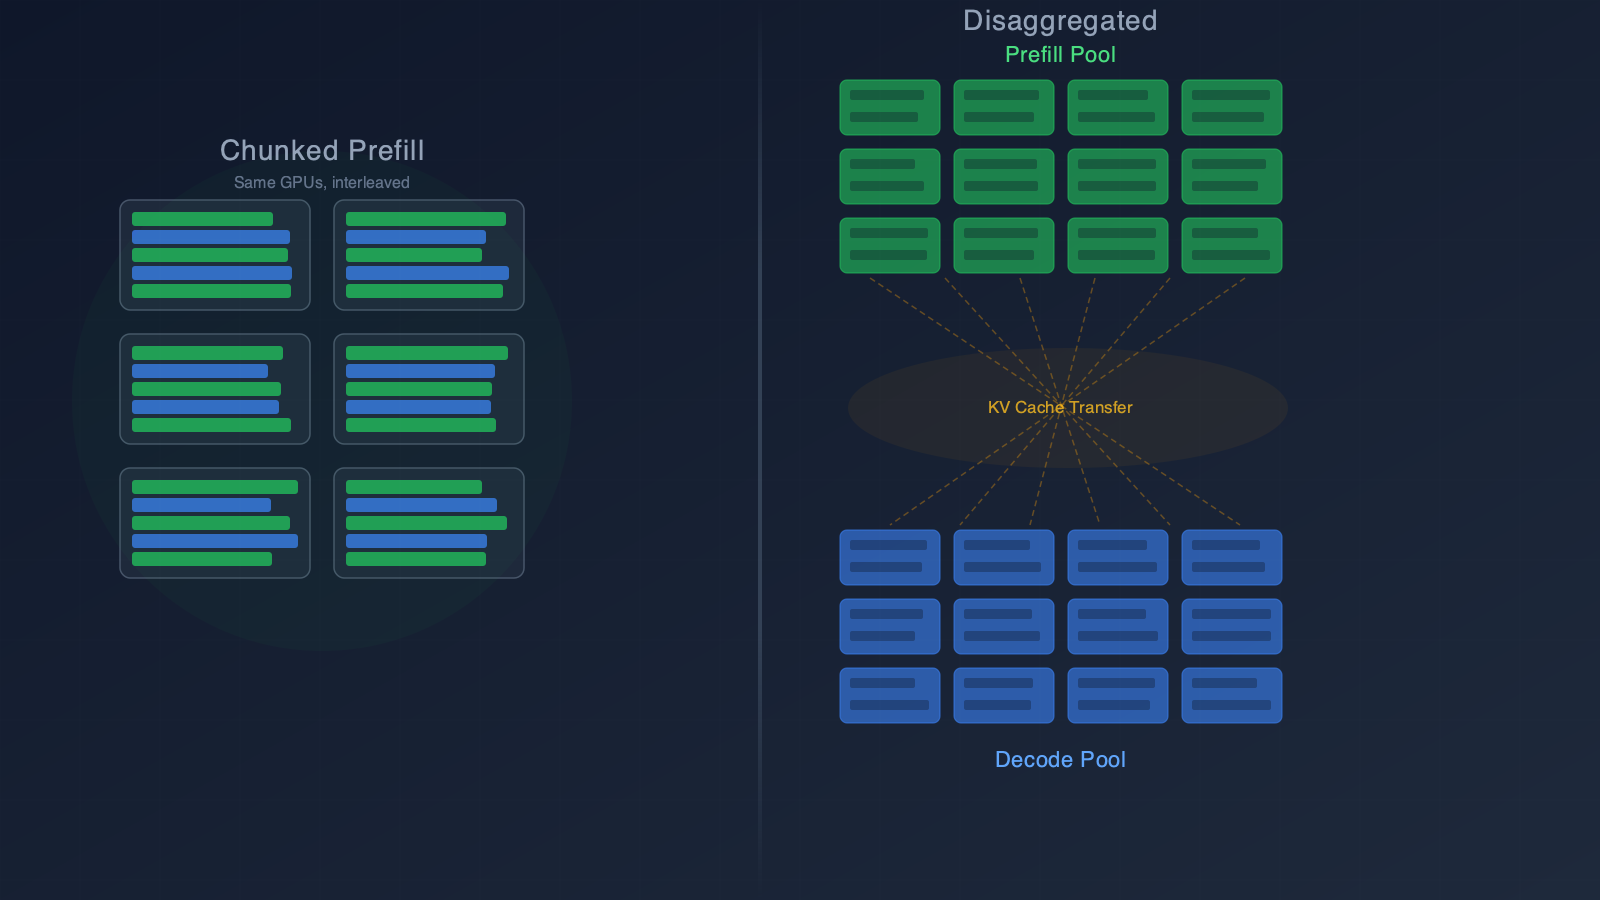
Prefill-Decode-Disaggregation lohnt sich erst ab tausend GPUs
Frag die KI zum Artikel
Folgefragen zu Headline, Quelle und Volltext — Antwort streamt in wenigen Sekunden.
Verwandte Beiträge
- FORSCHUNGarxiv.org0mo
Multi-Bin Batching steigert LLM-Inferenz-Durchsatz durch Längengruppierung
- FORSCHUNGarxiv.org2w
Elastic KV Cache für LLM-Serving: Mechanismus funktioniert, bringt kaum Gewinn
- FORSCHUNGhuggingface.co1w
Layer Dropout spart bis zu 25 % Training-FLOPs bei LLMs ohne Genauigkeitsverlust
- MEINUNGreddit.com4d
CEA-Architektur: Encoder/Decoder-Split eröffnet neue Möglichkeiten für GPU-Pooling
Prefill-Decode-Disaggregation lohnt sich erst ab tausend GPUs
Frag die KI zum Artikel
Folgefragen zu Headline, Quelle und Volltext — Antwort streamt in wenigen Sekunden.
Verwandte Beiträge
- FORSCHUNGarxiv.org0mo
Multi-Bin Batching steigert LLM-Inferenz-Durchsatz durch Längengruppierung
- FORSCHUNGarxiv.org2w
Elastic KV Cache für LLM-Serving: Mechanismus funktioniert, bringt kaum Gewinn
- FORSCHUNGhuggingface.co1w
Layer Dropout spart bis zu 25 % Training-FLOPs bei LLMs ohne Genauigkeitsverlust
- MEINUNGreddit.com4d
CEA-Architektur: Encoder/Decoder-Split eröffnet neue Möglichkeiten für GPU-Pooling