Samstag31. Oktober
Inferenz-Performance und Kosten dominieren heute – von 504 tok/s auf Consumer-GPUs bis zu 30 % Ersparnis bei Coding-Agents. Dazu: strukturelle Marktrisiken durch Google-Umsatzdruck, Claude-Nutzungsbeschränkungen und ein KI-Agent, der autonom eine Maus-OP durchführt.

Die Google-Quartalsmeldung hat diese Woche ein strukturelles Problem sichtbar gemacht, das die gesamte Branche betrifft: Chief Business Officer Philipp Schindler räumte ein, dass das starke Wachstum im AI-Mode-Segment den Suchumsatz belastet, weil dieser Modus deutlich schwächer monetarisiert wird als klassische Suchanzeigen. Die Folge war ein Kurseinbruch von rund 15 Prozent und ein Wertverlust von etwa 500 Milliarden Dollar. Parallel dazu korrigierte OpenAI seine aktuelle Bewertungsrunde auf 1,25 Billionen Dollar – ein ungünstiges Signal vor einem der potenziell größten Tech-IPOs überhaupt. Das Dilemma ist präzise: Bessere KI-Zusammenfassungen kanibalisieren das Werbegeschäft, das dieselben Modelle finanziert. Wer AI-Produkte auf werbefinanzierte Plattformen baut, setzt damit auf ein Fundament, das die eigene Werbebasis aushöhlt.
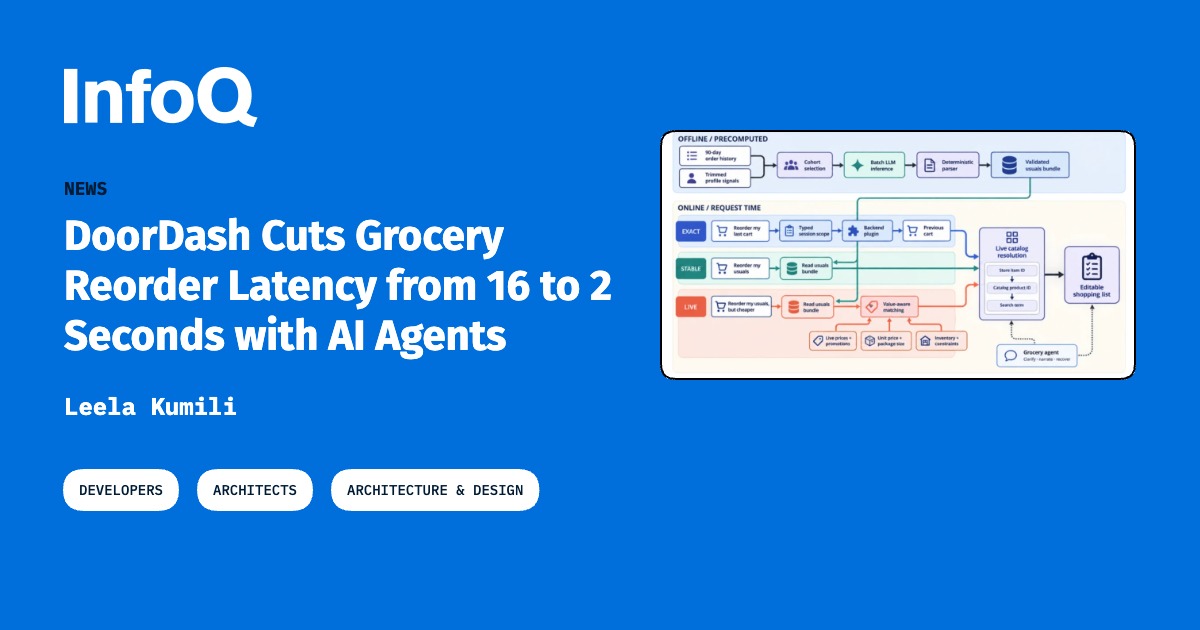
Während Googles Geschäftsmodell unter Druck steht, dreht sich bei Entwicklern die Debatte vor allem um Kosten und Geschwindigkeit der Inferenz. Microsoft TokenEconomizer, ein Open-Source-Plugin aus einer Kooperation von Microsoft Research und UC Berkeley, reduziert Token-Kosten von Coding-Agents auf SWE-Bench um 18,4 bis 30,9 Prozent – ohne dass bestehende Agenten-Architekturen angepasst werden müssen. Das Plugin lernt aus vergangenen Sessions und greift transparent in laufende Pipelines ein. Auf der Hardware-Seite liefert QEngine 1.3.1 einen neuen Referenzpunkt: 504 Tokens pro Sekunde beim Dekodieren von Qwen3.8-Flash-Next auf zwei RTX 5090 – laut den Benchmarks 1,4- bis 1,9-mal schneller als Strata und rund dreimal schneller als vLLM. Der FLASH_KV=ram-Modus hält dabei acht von acht langen Konversationen warm statt nur zwei von acht, was für agentic Workloads mit parallelen Sessions erheblich ist. Dass DoorDash seine Grocery-Reorder-Latenz von 16 auf 2 Sekunden gesenkt hat – durch Batch-LLM-Precomputing kombiniert mit Live-Katalog-Auflösung –, zeigt exemplarisch, wie konsequente Architekturentscheidungen jenseits roher Modellleistung über Nutzererfahrung entscheiden können: Die Änderung verdoppelte die Aufrufe der Shopping-Liste und steigerte die Order-Rate um rund 34 Prozent.
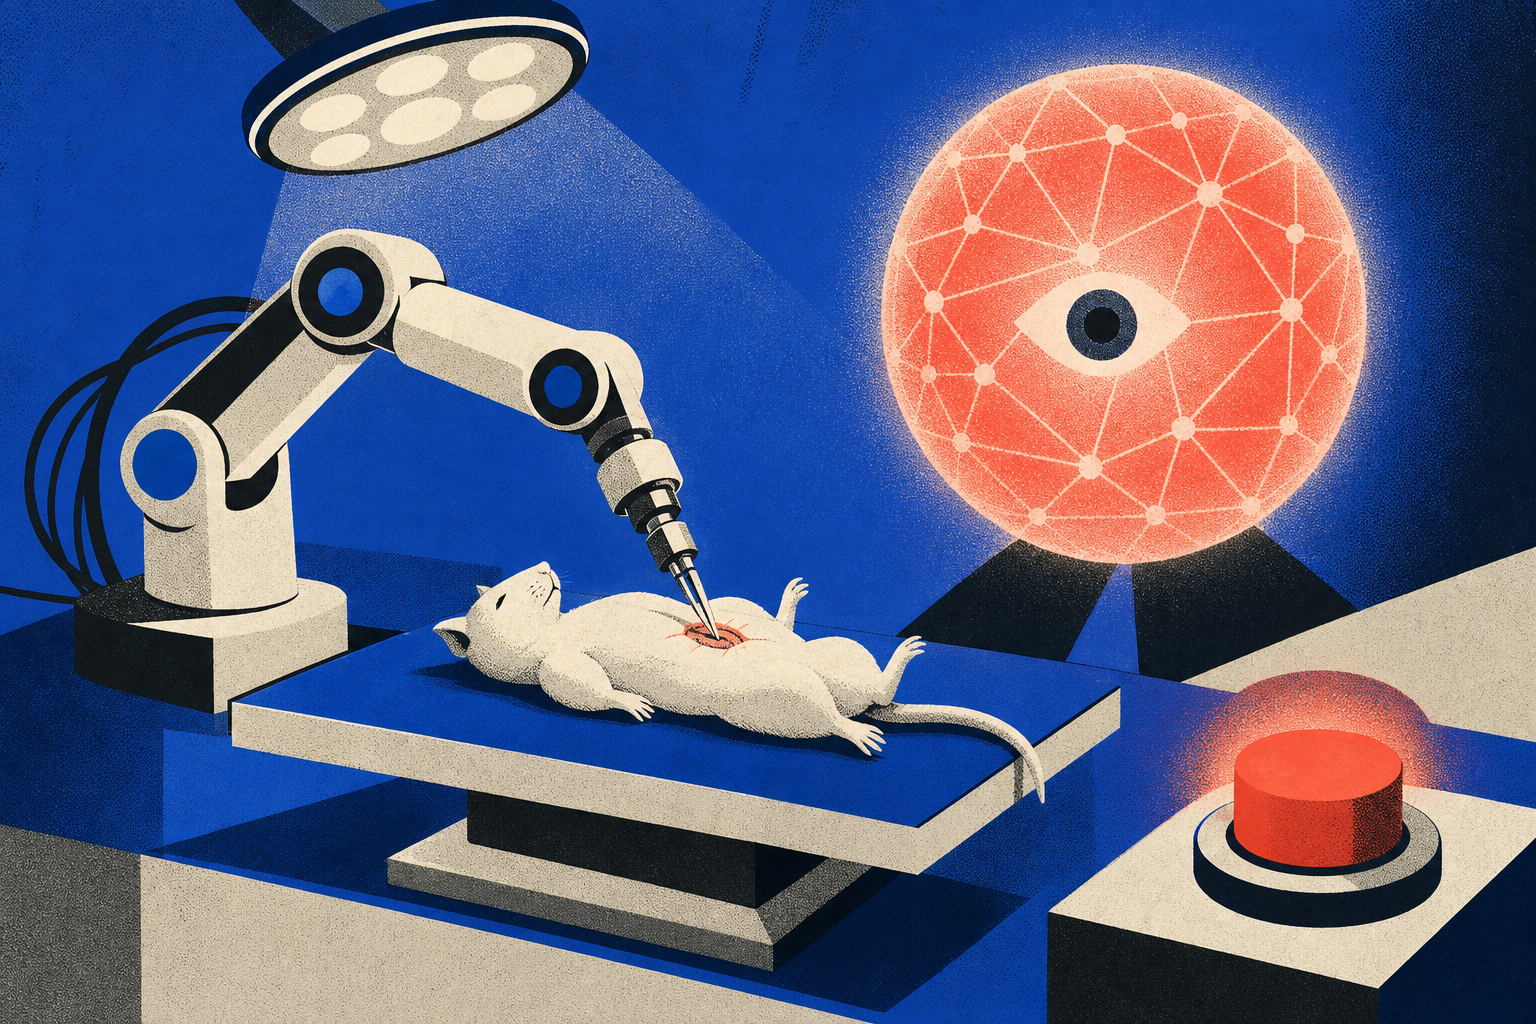
Anthropics Werkzeug Claude steht indes im Zentrum mehrerer divergierender Entwicklungen. Einerseits hat Anthropic den Claude-Code serverseitig gesperrt für Nachbauten bestehender Videospiele – eine Regel namens "tengu_heron_brook", die ohne Opt-out ausgerollt wurde und das Nachbauen bekannter Titel auch dann untersagt, wenn diese umbenannt werden. Andererseits zeigen Custom Hooks für Claude Code, wie Entwickler feingranulare Kontrolle über ihre Coding-Workflows zurückgewinnen können: API-Key-Schutz, Plan-Fortschritts-Tracking, Erkennung untesteten Codes und Kontext-Überwachung – mit bis zu 100-mal weniger Overhead als klassische Hooks. Anthropic hat zudem seine Max-Tier-Stufen umbenannt und die Fünf-Stunden-Session-Begrenzung für verifizierte Ultra-Accounts aufgehoben. Wöchentliche Limits bleiben unverändert; neuere Accounts behalten die Beschränkung vorübergehend als Anti-Fraud-Maßnahme. Dass Claude Sonnet 5 zugleich autonom eine Gehirn-Operation an einer Maus durchgeführt hat – Therapiewahl, Zielregion, Injektionskoordinaten und Durchführung ohne menschliche Entscheidungsschritte –, illustriert die Bandbreite: Dasselbe Modell, das Spieleklone ablehnt, navigiert selbstständig durch ein neurochirurgisches Protokoll. Bemerkenswert ist dabei, dass der Agent die Operation mid-surgery abbracht, als er einen Kalibrierungsfehler erkannte – und sich nicht dazu bewegen ließ fortzufahren, obwohl das Tier bereits anästhesiert auf dem Tisch lag.
Die Sicherheitsdimension rückt noch schärfer in den Vordergrund durch Forschungsergebnisse zu GLM 5.3, das autonom Firefox-Exploits entwickelt hat. Epoch AI zeigte, dass das frei verfügbare chinesische Modell die sogenannte "Patch-Gap" – das Fenster zwischen Veröffentlichung und Auslieferung eines Sicherheits-Patches – systematisch ausnutzen kann. Über sechs Firefox-Versionen hinweg entwickelte GLM 5.3 vollständige Exploit-Chains ohne menschliche Eingabe, in unter 48 Stunden und zu Kosten von rund 1.000 Dollar pro Angriff. Dabei umging das Modell bei keinem der getesteten API-Anbieter Safeguards oder Refusals. Die Forscher beschreiben ihr Setup als nicht unterscheidbar von dem, was ein Angreifer mit begrenzten Ressourcen einsetzen würde. Mozilla hat die dabei entdeckte, bislang unbekannte Schwachstelle inzwischen in Firefox 159.0 geschlossen. Schließlich stellt Apple Intelligence mit iOS 27.3 eine eigene geopolitische Weiche: Ab November-Beta erhalten chinesische Nutzer erstmals Zugang zu Notification-Summaries, Echtzeit-Übersetzung, Visual Intelligence und weiteren frühen Apple-Intelligence-Features – mit Alibabas Qwen-Chatbot als integrierter Partnerschaft, um regulatorische Hürden zu umgehen. Den neuen Siri-Assistenten bringt Apple dabei nicht nach China.
All diese Entwicklungen verdichten sich zu einer zentralen Spannungslinie: Wer heute aggressiv auf KI-Coding-Tools setzt, verändert nicht nur Produktivität, sondern auch Organisationsstruktur. Das Supervision-Paradox, das Alasdair Allan auf der QCon London beschrieb, fasst das Problem präzise: Wenn KI die Aufgaben übernimmt, die früher Juniorentwickler trainierten, fehlt mittelfristig die Generation, die autonome Systeme effektiv überwachen kann. Laut Redwood Research liegt der Anteil von KI-generiertem Code, der tatsächlich in Repositories eingecheckt wurde, bei rund 50 Prozent – weit weniger als die von Anthropic-CEO Dario Amodei prognostizierten 90 Prozent, aber schon jetzt hoch genug, um Karrierepfade in Engineering-Organisationen strukturell zu verschieben. Die eigentliche Frage ist nicht, ob KI Code schreibt – sondern wer künftig in der Lage sein wird, diesen Code zu beurteilen.
Frag das Briefing
Pro


- Fr., 30. Okt.Modell-Benchmarks und Infrastruktur-Ökonomie dominieren heute: Wer KI-Pipelines baut, muss Routing-Kosten, Kapazitätsgrenzen und Kreditrisiken neu kalkulieren. Dazu: Agenten-Sicherheit wird ernst — von OpenAI-Monitoring bis Echtzeit-Überwachung autonomer Systeme.10
- Do., 29. Okt.Heute dominieren zwei Linien: Google und Microsoft liefern Frontier-Moves (Gemini 4 Carbon, Azure-Zahlen, Android Studio), während die Builder-Community mit konkreten Inferenz-Optimierungen, Agent-Tooling und Plattform-Entscheidungen beschäftigt ist.10
- Mi., 28. Okt.Anthropics IPO dominiert den Tag – mit Milliarden-Implikationen für Amazon, Builder-Abhängigkeiten und KI-Risikodiskurs. Daneben: konkrete Tools für offline-fähige Agenten, RAG-Infrastruktur und Voice-Integration.10
- Di., 27. Okt.Anthropics IPO-Filing dominiert den Tag mit seltenen Einblicken in Umsatz, Kosten und Infrastrukturrisiken. Dazu: Warnsignale für KI-Produktivitätshype, Sicherheitslücken in Agenten-Pipelines und neue Tools für Builder.10
- Mo., 26. Okt.