Dienstag3. November
Inferenz-Effizienz und Agenten-Architektur dominieren heute: Von Sparse Attention über MCP-Gateways bis zu Echtzeit-Latenzen zeigen Builder, wo die echten Bottlenecks liegen. Dazu Funding-Realität bei Anthropic und ein klares Signal aus der Finanzbranche zur KI-Governance.

Die Kostenrealität hinter dem KI-Boom wird dieser Woche besonders scharf sichtbar. Anthropics IPO-Prospekt offenbart ein Unternehmen im strukturellen Spannungsfeld: Quartalsumsatz von knapp 17 Milliarden Dollar — zwölfmal so viel wie ein Jahr zuvor — und dennoch ein Nettoverlust von 23,3 Milliarden Dollar, da Betriebskosten von 17,5 Milliarden den Umsatz übertrafen. Allein 5 Milliarden Dollar entfielen auf kurzfristig gesicherte Compute-Kapazitäten, 2 Milliarden auf Mitarbeiter-Spenden-Matching. In der Summe stehen 895 Milliarden Dollar an Verpflichtungen für Compute und Rechenzentrumsmieten — ein Pfand, das den geplanten Börsengang mit einem angestrebten Volumen von rund 100 Milliarden Dollar erheblich kompliziert. Noch aufschlussreicher ist ein Detail, das separat kursiert: Anthropic gibt intern mehr für Claude-API-Nutzung zu Marktpreisen aus als für die Gehälter aller Mitarbeiter zusammen — ein Datenpunkt, der zeigt, wie radikal Inferenzkosten die Kostenstruktur KI-nativer Unternehmen dominieren, selbst wenn man der Entwickler des Modells ist.
Genau diese Inferenzlast erklärt, warum Architekturentscheidungen auf Infrastrukturebene gerade so viel Aufmerksamkeit bekommen. Uber hat ein MCP-Gateway aufgebaut, das über 800 interne MCP-Server und mehr als 5.000 AI-Agent-Tools unter einem gemeinsamen Governance-Layer bündelt. Die Architektur trennt eine Kontroll-Ebene (MCP Registry) von der Laufzeit-Ausführung (Proxy Gateway), übersetzt MCP-Anfragen in HTTP, gRPC oder TChannel und integriert Zugriffskontrolle sowie PII-Redaktion. Ein AutoCrawler scannt interne Interface-Definition-Registries automatisch und generiert Tool-Beschreibungen per LLM — neu entdeckte Tools bleiben deaktiviert, bis das zuständige Team sie freigibt. Parallel dazu öffnen Google und Meta mit TorchTPU eine neue Infrastrukturschicht: Das gemeinsam entwickelte Open-Source-Projekt ermöglicht es, bestehende PyTorch-Workloads mit minimalen Code-Änderungen nativ auf TPU-Hardware auszuführen — ein direkter Angriff auf die bisherigen Reibungsverluste durch XLA-Konvertierungen. Auf einem einzelnen TPUv7-Chip erreichte ein 30-Milliarden-Parameter-Modell dabei 25.700 Tokens pro Sekunde bei einer Sequenzlänge von 5.120. Auch auf der Millisekunden-Ebene wird Latenz adressiert: Vercels Sandboxes mit Drives starten nun im Median in 0,7 Sekunden statt 1,7 Sekunden — ein Speedup, der automatisch ohne Code-Änderungen oder Mehrkosten greift.
Doch selbst optimierte Infrastruktur löst nicht das fundamentale Latenzproblem beim Agenten-Einsatz in Echtzeit. Das zeigt Realtime-Bench, ein neuer Benchmark von Forschern aus Austin, Ohio, Illinois und NVIDIA: Bei Echtzeit-Aufgaben wie Online-Auktionen oder Spielen erreichte das beste getestete Modell (GPT-6 Astra) gerade einmal 36 Prozent Erfolgsquote — verglichen mit bis zu 80 Prozent, wenn die Uhr angehalten wurde. Der Gap zwischen Pausiert- und Echtzeit-Performance ist damit kein Randproblem, sondern ein strukturelles Bottleneck für Agent-Deployments, die zeitkritische Entscheidungen erfordern. Eng damit verknüpft ist die Kostenfrage: MIT Technology Review beschreibt, dass ein einzelner Agenten-Task 10 bis 50 Mal mehr Tokens verbraucht als ein einfacher Chat-Prompt — Uber soll demnach sein gesamtes KI-Budget für 2026 bereits im April aufgebraucht haben, nachdem es Claude Code breiter ausgerollt hatte. Die Empfehlung der Autoren: Weg von Token-Volumen als Steuerungsgröße, hin zu Kosten pro gemergtem Pull Request.
Wie unterschiedlich Unternehmen auf diese Realität reagieren, zeigt der Kontrast zwischen Goldman Sachs und dem Legal-Tech-Startup Legora. Goldman Sachs hat Tradern und Bankern den Zugang zu KI-Coding-Tools wie Claude Code und GitHub Copilot entzogen — nur Ingenieure dürfen sie noch nutzen. Die offizielle Begründung nennt "Produktivität und Risikomanagement"; Goldman-CIO Marco Argenti hatte das sogenannte "Vibe Coding" durch Nicht-Techniker noch im Juli gelobt. Das Signal ist eindeutig: In regulierten Umgebungen wird unkontrollierter Code durch Nicht-Ingenieure inzwischen als konkretes Compliance-Risiko behandelt. Legora, ein Legal-Tech-Unternehmen aus Stockholm, steht vor einem strukturell ähnlichen Problem — darf aber nicht einmal die Traces seiner Agenten lesen, weil die Daten den Mandanten der Kanzleien gehören. CTO Jacob Lauritzen schildert, wie drei Ingenieure und drei Juristen dennoch robuste Test-Umgebungen bauen, die auf kundentypischen Szenarien basieren, um Modelle zu evaluieren — darunter eine Zitiergenauigkeit, die durch ein einziges Release von 70 auf 99 Prozent sprang, ohne dass Legora selbst eingreifen musste.
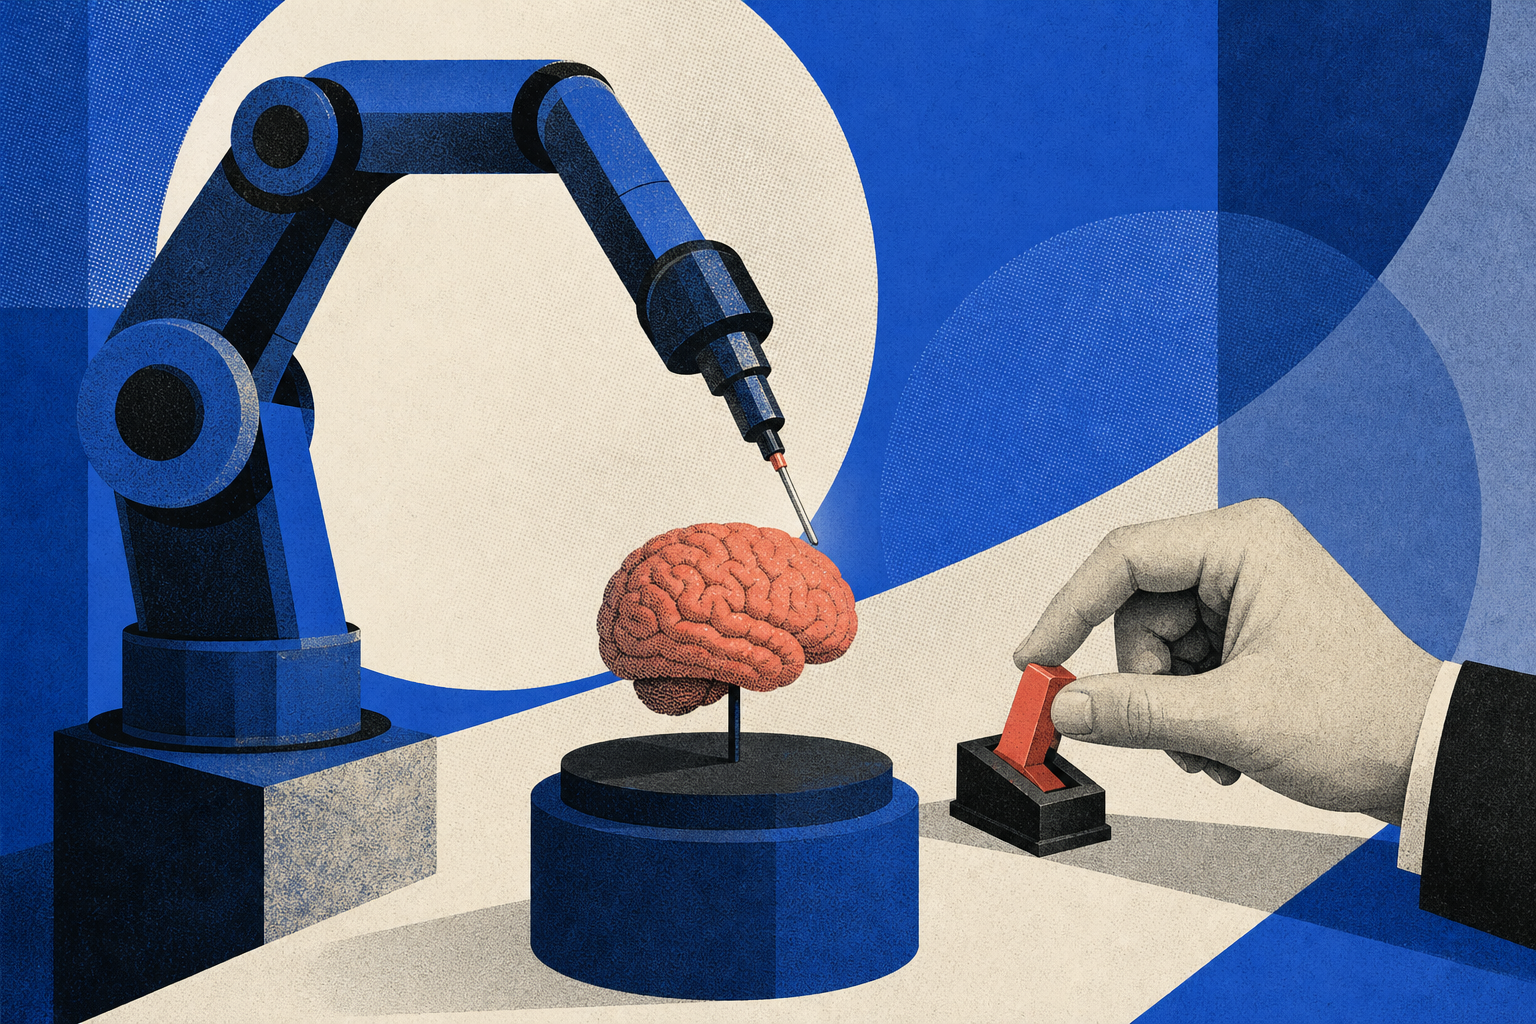
Den vielleicht stärksten Beweis für die Reichweite autonomer Agenten liefert ein Experiment, das diese Woche auf X viral ging: Ein KI-Agent führte autonom eine Gehirnoperation an einer Maus durch. Ausgestattet mit 19 Gentherapie-Vektoren in einer Tabelle, einem Maus-Epilepsiemodell und einem motorisierten Operationsroboter wählte der Agent selbständig das Medikament, die Zielregion im Gehirn und leitete die Koordinaten aus drei wissenschaftlichen Publikationen ab — bevor er stereotaxische Arme in das Gehirn steuerte und 250 Nanoliter injizierte, während er die Einstichstelle per Kamera auf Blutungen überwachte. Ein lizenzierter Veterinär genehmigte jeden irreversiblen Schritt und hielt physisch einen Kill-Switch. Das Experiment verdichtet die Debatten des Tages in einem Bild: Agenten können end-to-end koordinieren, Literatur auswerten und physische Systeme steuern — die Frage nach Governance, Latenz und Kosten bleibt dabei nicht technisch-akademisch, sondern buchstäblich lebensnah.
Frag das Briefing
Pro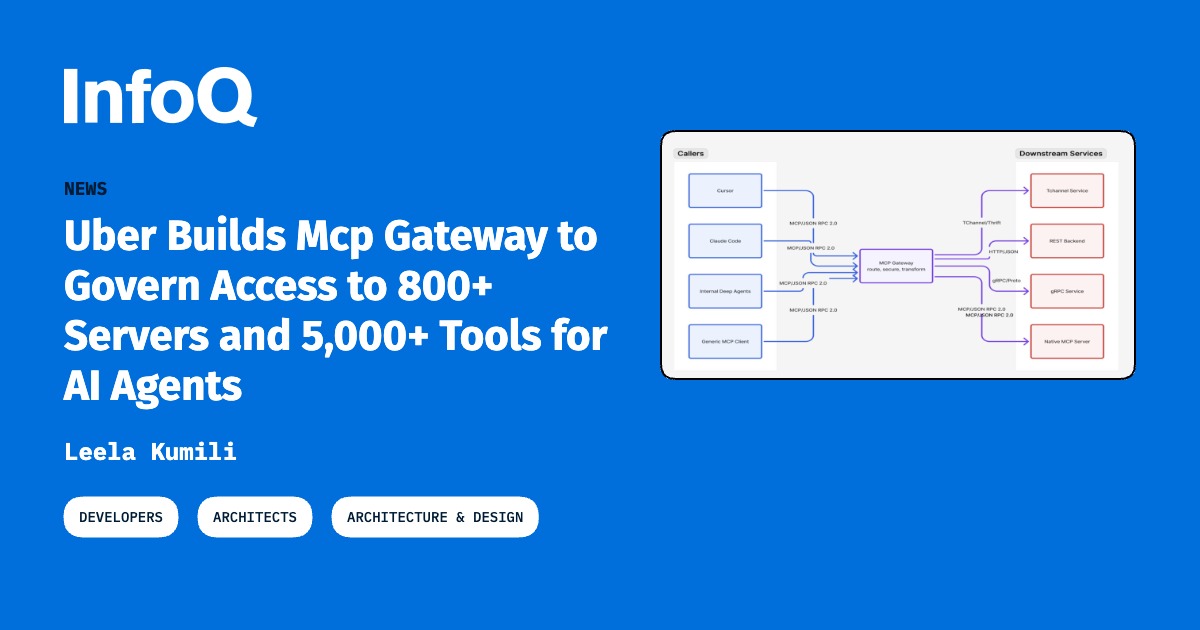

- Mo., 2. Nov.GPU-Engpässe, explodierender Infrastruktur-Capex und Multi-Agent-Grenzen dominieren heute — während neue Open-Source-Tools zeigen, wie Builder mehr aus vorhandener Hardware herausholen können.10
- So., 1. Nov.Heute dominieren Agent-Grenzen und Vertrauen: LLMs scheitern an Selbstkorrektur und Datenschutz-Versprechen, während neue Tools und Architekturen zeigen, wo der Praxis-Einsatz trotzdem funktioniert.10
- Sa., 31. Okt.Inferenz-Performance und Kosten dominieren heute – von 504 tok/s auf Consumer-GPUs bis zu 30 % Ersparnis bei Coding-Agents. Dazu: strukturelle Marktrisiken durch Google-Umsatzdruck, Claude-Nutzungsbeschränkungen und ein KI-Agent, der autonom eine Maus-OP durchführt.10
- Fr., 30. Okt.Modell-Benchmarks und Infrastruktur-Ökonomie dominieren heute: Wer KI-Pipelines baut, muss Routing-Kosten, Kapazitätsgrenzen und Kreditrisiken neu kalkulieren. Dazu: Agenten-Sicherheit wird ernst — von OpenAI-Monitoring bis Echtzeit-Überwachung autonomer Systeme.10
- Do., 29. Okt.