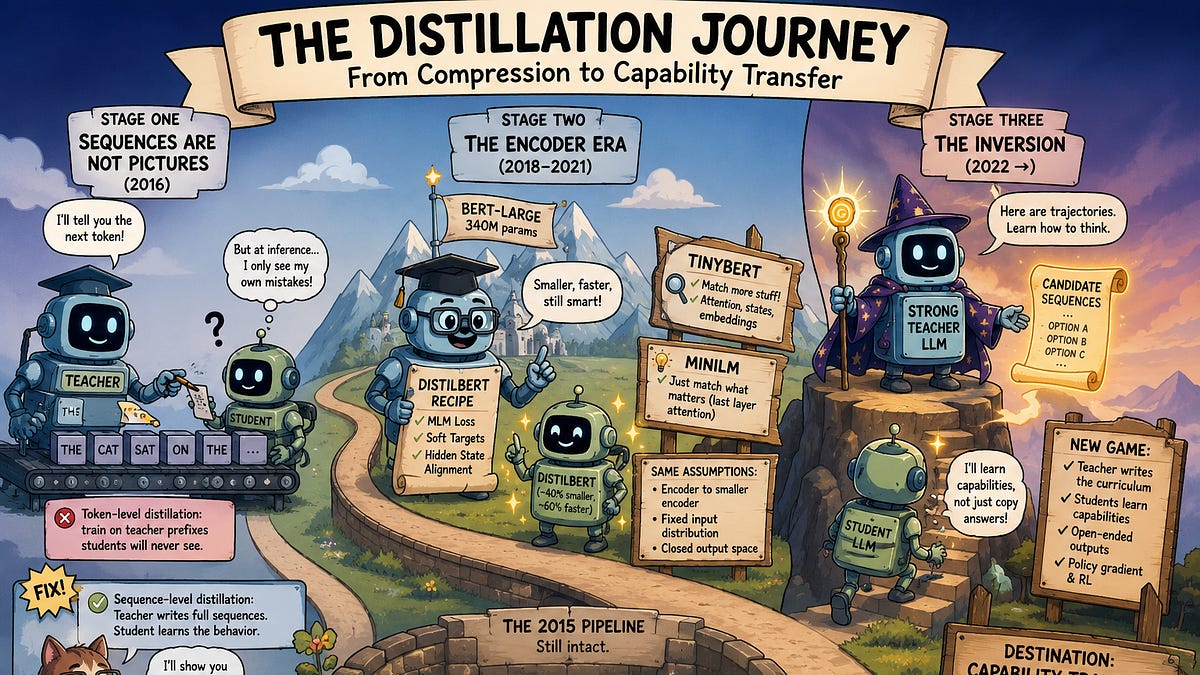
Evolution der Distillation im LLM-Zeitalter: Von Kompression zu Capability Transfer
Warum es zählt
Wer kleine Modelle mit Hilfe großer Modelle trainiert, muss verstehen, dass klassische Distillations-Annahmen (geschlossene Klassen, feste Input-Verteilung) für LLMs nicht mehr gelten. Die historische Einordnung hilft, aktuelle Methoden des Knowledge Transfers konzeptuell besser zu verorten.
— Lumeric Redaktion
Frag die KI zum Artikel
Folgefragen zu Headline, Quelle und Volltext — Antwort streamt in wenigen Sekunden.
Verwandte Beiträge
- MEINUNGthesequence.substack.com3w
Test-Time Compute Distillation: Inferenz-Intelligenz in Modellgewichte komprimieren
- MEINUNGthesequence.substack.com6d
Warum Modell-Distillation die kritischen 5% verliert
- FORSCHUNGarxiv.org2w
MI-Distillation: Effizienteres Chain-of-Thought-Training für kleinere Modelle
- FORSCHUNGarxiv.org1w
Low-Rank Clone: SLM-Training mit 1.000-facher Token-Effizienz
Evolution der Distillation im LLM-Zeitalter: Von Kompression zu Capability Transfer
Warum es zählt
Wer kleine Modelle mit Hilfe großer Modelle trainiert, muss verstehen, dass klassische Distillations-Annahmen (geschlossene Klassen, feste Input-Verteilung) für LLMs nicht mehr gelten. Die historische Einordnung hilft, aktuelle Methoden des Knowledge Transfers konzeptuell besser zu verorten.
— Lumeric Redaktion
Frag die KI zum Artikel
Folgefragen zu Headline, Quelle und Volltext — Antwort streamt in wenigen Sekunden.
Verwandte Beiträge
- MEINUNGthesequence.substack.com3w
Test-Time Compute Distillation: Inferenz-Intelligenz in Modellgewichte komprimieren
- MEINUNGthesequence.substack.com6d
Warum Modell-Distillation die kritischen 5% verliert
- FORSCHUNGarxiv.org2w
MI-Distillation: Effizienteres Chain-of-Thought-Training für kleinere Modelle
- FORSCHUNGarxiv.org1w
Low-Rank Clone: SLM-Training mit 1.000-facher Token-Effizienz