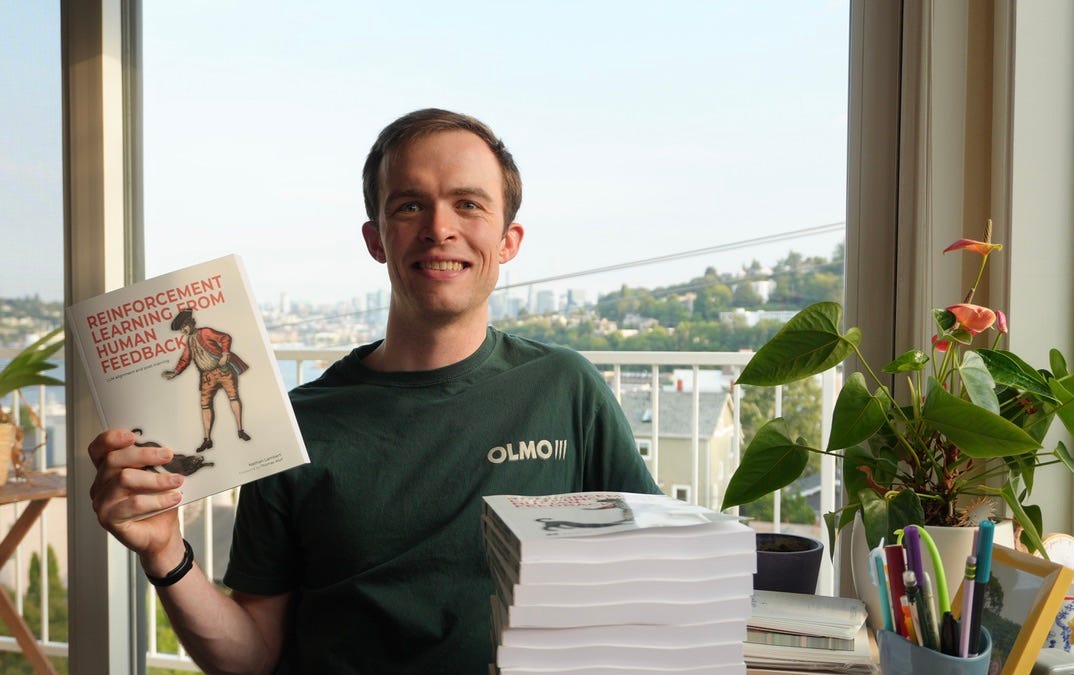
Nathan Lambert veröffentlicht RLHF-Lehrbuch zu Post-Training von LLMs
Lamberts Buch entstand aus einer persönlichen Dokumentations-Website, die er 2024 startete, weil er zu zentralen Post-Training-Methoden kaum strukturiertes Lernmaterial finden konnte. Themen wie Rejection Sampling, Outcome Reward Models und Character Training waren auch zu diesem Zeitpunkt im Netz kaum fundiert aufbereitet. Das fertige Werk gliedert sich so, dass rund 25 % des Inhalts rein auf Reinforcement-Learning-Algorithmen entfällt – von der Herleitung des Policy-Gradient-Theorems über REINFORCE und RLOO bis hin zu modernen Varianten wie GSPO und CISPO. Ein zentrales Kapitel befasst sich mit Loss Aggregation, dem Konzept, das später DAPO und Dr. GRPO als frühe GRPO-Varianten hervorbrachte, sowie mit Truncated Importance Sampling, der Technik, die PPO in frühen RL-Experimenten erst stabil machte. Auf der Systemseite erklärt Lambert asynchrones RL mit getrennten GPU-Pools für Learner (Gradientenschritte) und Actors (Rollout-Generierung) als das seit Jahren stabile Grundgerüst, auf das agentische Aufgaben lediglich weitere Infrastruktur aufsetzen. Kurz vor Redaktionsschluss ergänzte Lambert noch einen Abschnitt zu On-Policy Distillation. Die physische Ausgabe ist bei Manning und Amazon US bereits lieferbar; die Amazon-UK-Ausgabe folgt im Oktober 2026.
- Der Buchinhalt ist zu ca. 25 % RL-fokussiert; das restliche Material behandelt Intuition, Geschichte und Systeme des Post-Trainings.
- Abgedeckte Algorithmen im Policy-Gradient-Kapitel: VPG, REINFORCE, RLOO, PPO, GRPO, GSPO und CISPO – jeweils mit mathematischer Herleitung.
- Das PPO-Clipping wird anhand von sechs Regionen im Surrogate-Objective visualisiert, abhängig von positivem/negativem Advantage und dem Policy-Ratio.
- Loss Aggregation wird als das Konzept eingeführt, das die frühen GRPO-Varianten DAPO und Dr. GRPO angetrieben hat.
- Amazon UK liefert die physische Ausgabe erst ab Oktober 2026; Manning und Amazon US versenden bereits jetzt.
Frag die KI zum Artikel
Folgefragen zu Headline, Quelle und Volltext — Antwort streamt in wenigen Sekunden.
Verwandte Beiträge
Nathan Lambert veröffentlicht RLHF-Lehrbuch zu Post-Training von LLMs
Lamberts Buch entstand aus einer persönlichen Dokumentations-Website, die er 2024 startete, weil er zu zentralen Post-Training-Methoden kaum strukturiertes Lernmaterial finden konnte. Themen wie Rejection Sampling, Outcome Reward Models und Character Training waren auch zu diesem Zeitpunkt im Netz kaum fundiert aufbereitet. Das fertige Werk gliedert sich so, dass rund 25 % des Inhalts rein auf Reinforcement-Learning-Algorithmen entfällt – von der Herleitung des Policy-Gradient-Theorems über REINFORCE und RLOO bis hin zu modernen Varianten wie GSPO und CISPO. Ein zentrales Kapitel befasst sich mit Loss Aggregation, dem Konzept, das später DAPO und Dr. GRPO als frühe GRPO-Varianten hervorbrachte, sowie mit Truncated Importance Sampling, der Technik, die PPO in frühen RL-Experimenten erst stabil machte. Auf der Systemseite erklärt Lambert asynchrones RL mit getrennten GPU-Pools für Learner (Gradientenschritte) und Actors (Rollout-Generierung) als das seit Jahren stabile Grundgerüst, auf das agentische Aufgaben lediglich weitere Infrastruktur aufsetzen. Kurz vor Redaktionsschluss ergänzte Lambert noch einen Abschnitt zu On-Policy Distillation. Die physische Ausgabe ist bei Manning und Amazon US bereits lieferbar; die Amazon-UK-Ausgabe folgt im Oktober 2026.
- Der Buchinhalt ist zu ca. 25 % RL-fokussiert; das restliche Material behandelt Intuition, Geschichte und Systeme des Post-Trainings.
- Abgedeckte Algorithmen im Policy-Gradient-Kapitel: VPG, REINFORCE, RLOO, PPO, GRPO, GSPO und CISPO – jeweils mit mathematischer Herleitung.
- Das PPO-Clipping wird anhand von sechs Regionen im Surrogate-Objective visualisiert, abhängig von positivem/negativem Advantage und dem Policy-Ratio.
- Loss Aggregation wird als das Konzept eingeführt, das die frühen GRPO-Varianten DAPO und Dr. GRPO angetrieben hat.
- Amazon UK liefert die physische Ausgabe erst ab Oktober 2026; Manning und Amazon US versenden bereits jetzt.
Frag die KI zum Artikel
Folgefragen zu Headline, Quelle und Volltext — Antwort streamt in wenigen Sekunden.