AI-Führungskräfte diskutieren Token-Maximierung als Strategie
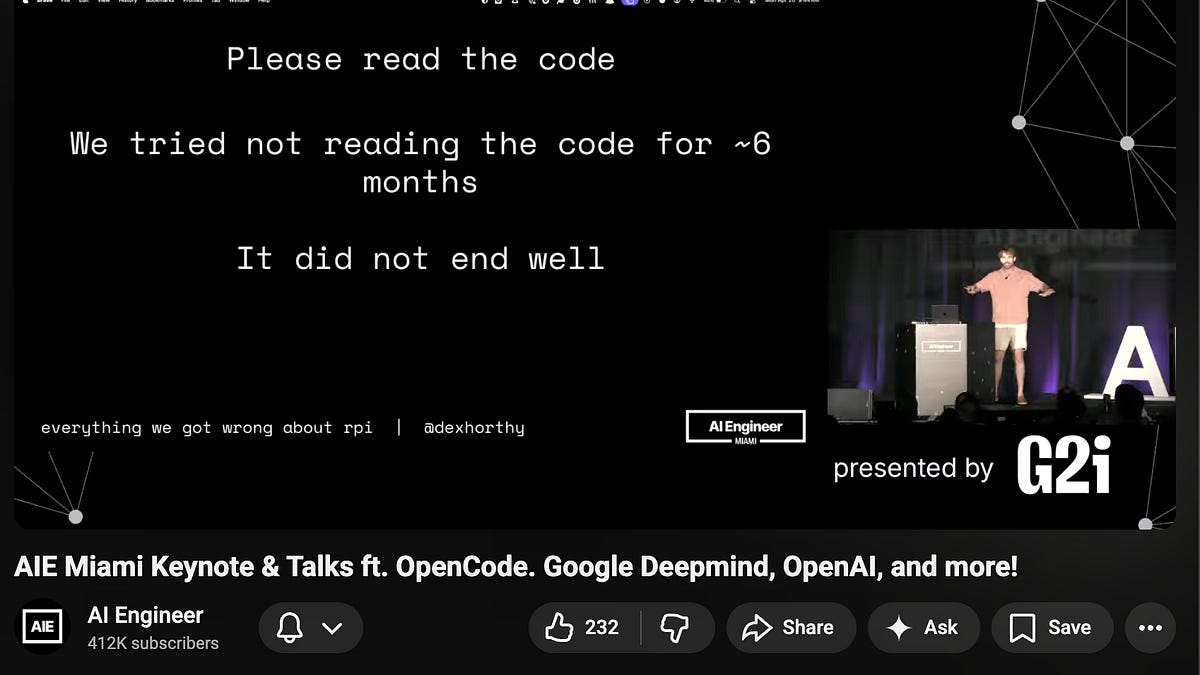
Im Mittelpunkt der Ausgabe steht das Konzept des „Tasteful Tokenmaxxing", das auf der AI Engineer (AIE) Conference in Miami intensiv diskutiert wurde – dem nächsten Halt folgt Singapur. Mikhail Parakhin, CTO von Shopify und Tagesgast bei Latent Space, prägte dabei eine wichtige Nuance: Führungskräfte sollten auf Tiefe setzen (serielle Autoresearch-Loops) statt auf Breite (50 oder 500 parallele LLM-Runs), um sinnlose Token-Verschwendung zu vermeiden. Dex Horthy, Erfinder des Begriffs „Context Engineering" und „the Dumb Zone", widerrief öffentlich seinen früheren Pro-Vibe-Coding-Standpunkt und rief dazu auf, Code tatsächlich zu lesen – gestützt auf Alex Volkovs Z/L-Kontinuum von der AIE Europe. Das Z/L-Spektrum beschreibt eine Skala zwischen zwei Polen: Zechner (Codequalität priorisieren) und Lopopolo (Quantität und billiges Code-Review). Parallel dazu gab es bei Google Cloud Next substanzielle Hardware-Ankündigungen: TPU v8 erscheint in zwei Varianten – TPU 8t für Training (fast 3× Rechenleistung pro Pod gegenüber Ironwood) und TPU 8i für Inferenz (1.152 TPUs pro Pod), wobei Google einen Cluster aus einer Million TPUs ankündigt. Auf der Software-Seite launcht Google die Gemini Enterprise Agent Platform als Nachfolger von Vertex AI, inklusive Agent Studio, Zugang zu über 200 Modellen und Integrationen wie Workspace Intelligence und Wiz. OpenAI veröffentlichte derweil ein Privacy-Filter-Modell (1,5B Parameter gesamt, 50M aktiv, MoE, Apache 2.0) zur PII-Erkennung sowie Workspace Agents in ChatGPT.
- Qwen3.6-27B (Apache 2.0, dense) übertrifft laut Alibaba das deutlich größere Qwen3.5-397B-A17B auf SWE-bench Verified (77,2 vs. 76,2) und Terminal-Bench 2.0 (59,3 vs. 52,5).
- Xiaomis MiMo-V2.5-Pro meldet SWE-bench Pro 57,2 und τ3-Bench 72,9 sowie Unterstützung für 1.000+ autonome Tool-Calls; das nicht-Pro-Modell bietet ein 1-Millionen-Token-Kontextfenster.
- OpenAIs Privacy Filter ist ein 1,5B-Parameter-MoE-Modell (50M aktiv) mit 128k-Kontextfenster, lizenziert unter Apache 2.0, ausgelegt auf kostengünstige PII-Erkennung in großen Logs und Enterprise-Pipelines.
- Google TPU 8i verbindet 1.152 TPUs pro Pod für Low-Latency-Inferenz; Google behauptet, bis zu einer Million TPUs in einem einzigen Cluster mit TPU 8t skalieren zu können.
- AINews wertete für die Ausgabe (21.–22. April 2026) 12 Subreddits und 544 Twitter-Accounts aus.
Frag die KI zum Artikel
Folgefragen zu Headline, Quelle und Volltext — Antwort streamt in wenigen Sekunden.
Verwandte Beiträge
- FORSCHUNGarxiv.org2w
Token Economy Score: Wann lohnt sich LLM-Reasoning wirklich?
- FORSCHUNGarxiv.org3w
Token-Optimierung und Context-Window-Management für Multi-Agent-Workflows
- MEINUNGreddit.com3w
Community diskutiert: LLM-Sprachmuster per System-Prompt neutralisieren
- FORSCHUNGarxiv.org3w
Audio-Token-Kompression für Large Audio Language Models um Faktor 3
AI-Führungskräfte diskutieren Token-Maximierung als Strategie
Im Mittelpunkt der Ausgabe steht das Konzept des „Tasteful Tokenmaxxing", das auf der AI Engineer (AIE) Conference in Miami intensiv diskutiert wurde – dem nächsten Halt folgt Singapur. Mikhail Parakhin, CTO von Shopify und Tagesgast bei Latent Space, prägte dabei eine wichtige Nuance: Führungskräfte sollten auf Tiefe setzen (serielle Autoresearch-Loops) statt auf Breite (50 oder 500 parallele LLM-Runs), um sinnlose Token-Verschwendung zu vermeiden. Dex Horthy, Erfinder des Begriffs „Context Engineering" und „the Dumb Zone", widerrief öffentlich seinen früheren Pro-Vibe-Coding-Standpunkt und rief dazu auf, Code tatsächlich zu lesen – gestützt auf Alex Volkovs Z/L-Kontinuum von der AIE Europe. Das Z/L-Spektrum beschreibt eine Skala zwischen zwei Polen: Zechner (Codequalität priorisieren) und Lopopolo (Quantität und billiges Code-Review). Parallel dazu gab es bei Google Cloud Next substanzielle Hardware-Ankündigungen: TPU v8 erscheint in zwei Varianten – TPU 8t für Training (fast 3× Rechenleistung pro Pod gegenüber Ironwood) und TPU 8i für Inferenz (1.152 TPUs pro Pod), wobei Google einen Cluster aus einer Million TPUs ankündigt. Auf der Software-Seite launcht Google die Gemini Enterprise Agent Platform als Nachfolger von Vertex AI, inklusive Agent Studio, Zugang zu über 200 Modellen und Integrationen wie Workspace Intelligence und Wiz. OpenAI veröffentlichte derweil ein Privacy-Filter-Modell (1,5B Parameter gesamt, 50M aktiv, MoE, Apache 2.0) zur PII-Erkennung sowie Workspace Agents in ChatGPT.
- Qwen3.6-27B (Apache 2.0, dense) übertrifft laut Alibaba das deutlich größere Qwen3.5-397B-A17B auf SWE-bench Verified (77,2 vs. 76,2) und Terminal-Bench 2.0 (59,3 vs. 52,5).
- Xiaomis MiMo-V2.5-Pro meldet SWE-bench Pro 57,2 und τ3-Bench 72,9 sowie Unterstützung für 1.000+ autonome Tool-Calls; das nicht-Pro-Modell bietet ein 1-Millionen-Token-Kontextfenster.
- OpenAIs Privacy Filter ist ein 1,5B-Parameter-MoE-Modell (50M aktiv) mit 128k-Kontextfenster, lizenziert unter Apache 2.0, ausgelegt auf kostengünstige PII-Erkennung in großen Logs und Enterprise-Pipelines.
- Google TPU 8i verbindet 1.152 TPUs pro Pod für Low-Latency-Inferenz; Google behauptet, bis zu einer Million TPUs in einem einzigen Cluster mit TPU 8t skalieren zu können.
- AINews wertete für die Ausgabe (21.–22. April 2026) 12 Subreddits und 544 Twitter-Accounts aus.
Frag die KI zum Artikel
Folgefragen zu Headline, Quelle und Volltext — Antwort streamt in wenigen Sekunden.
Verwandte Beiträge
- FORSCHUNGarxiv.org2w
Token Economy Score: Wann lohnt sich LLM-Reasoning wirklich?
- FORSCHUNGarxiv.org3w
Token-Optimierung und Context-Window-Management für Multi-Agent-Workflows
- MEINUNGreddit.com3w
Community diskutiert: LLM-Sprachmuster per System-Prompt neutralisieren
- FORSCHUNGarxiv.org3w
Audio-Token-Kompression für Large Audio Language Models um Faktor 3